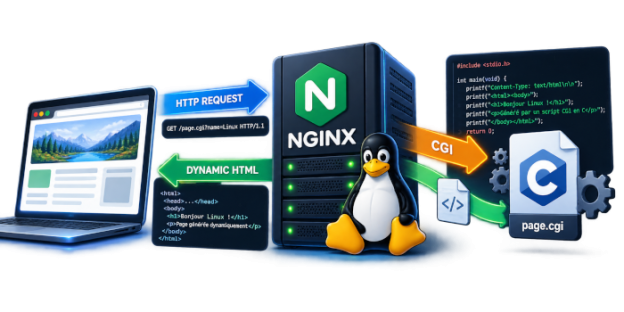
Comme nous l’avons vu dans les épisodes précédents, la mécanique est de coupler un formulaire (form) HTML rempli par le client, envoyé au serveur NginX qui renvoie lui-même les données à un script de traitement, que nous ambitionnons d’écrire en langage C.
Ce script aura toujours la même structure :
- Recevoir et lire les données brutes envoyées par le formulaire
- Retraiter ces données pour qu’elles soient exploitables
- Effectuer les traitements requis
- Produire et renvoyer une page HTML de réponse
Pour faire tout cela, nous allons utiliser la librairie climb téléchargeable ici.
Recevoir et lire les données brutes envoyées par le formulaire
Voici le code type :
int main()
{
char *request_body;
char *parametre1;
int nb;

request_body=climb_http_post_request_body();
parametre1=(char *)malloc(strlen(request_body));
nb=climb_http_request_body_items_number(request_body);
if(nb>0) climb_http_request_body_item(request_body,1,parametre1);
}
climb_http_post_request_body lit la chaine de caractères brute reçue du formulaire du client
climb_http_request_body_items_number compte le nombre de champs qu’il y a dans cette chaine de caractères brute (ie le nombre d’items renseignés par le client dans le formulaire)
climb_http_request_body_item recopie dans parametre1 la valeur du champ n (ici n=1 donc c’est le dernier champ, 2 pour l’avant dernier, etc.)
Notez comment la variable parametre1 est initialisée : par malloc sur la taille complète de la chaine reçue. C’est un moyen très simple mais pourtant très efficace de ne pas être attaqué par débordement de tampon.
Retraiter ces données pour qu’elles soient exploitables
Comme on l’a vu dans les épisodes précédents, la chaine de caractères envoyée par le formulaire est codée selon les codages HTML, ce qui signifie que ce que le script C reçoit n’a plus que peu à voir avec ce que l’utilisateur a tapé dans son formulaire.
Pour retrouver ce que l’utilisateur a tapé, notre programme C va donc maintenant exécuter :
climb_http_translate(parametre1);Cette fonction permet à la fois de retrouver ce qu’a tapé l’utilisateur mais empêche également les attaques de type XSS (Cross site scripting).
Effectuer les traitements requis
Nous avons vu dans l’épisode 6 comment notre programme C peut interférer avec une base de données MySQL. Comme mentionné, pour faire cela il faut connaître un minimum les requêtes SQL : nous en verrons le B-A-BA dans un épisode ultérieur.
La librairie climb ne fournit pas que des fonctions utiles au dialogue avec MySQL. Il y aussi :
Une fonction pour hacher une chaine de caractères, que nous utiliserons pour stocker les mots de passe en base de données. Vous savez déjà en effet qu’un mot de passe ne se stocke jamais en clair, mais haché :
void climb_sha56_hash(char *string); climb fournit aussi des fonctions utiles pour la gestion du temps, du format JSON, des sémaphores et des cookies HTML :
// Time functions
int climb_time_dayoftheweek(char * date_string);
void climb_time_zeroize(int num, char *out_string);

// JSON functions
struct json_response *climb_json_init();
void climb_json_status_seterror(struct json_response *jr, char *errorstatus);
void climb_json_status_unseterror(struct json_response *jr);
void climb_json_data_record_add_keyvalue_(struct json_response *jr, char *key, char *value);
void climb_json_data_add_record_(struct json_response *jr);
void climb_json_response_(struct json_response *jr);

// Semaphore functions
void climb_semaphore_init(int *sem, int pack);
int climb_semaphore_get(int *sem, int pack);
void climb_semaphore_take_token(int *sem);
void climb_semaphore_release_token(int *sem);

// Cookies functions
int climb_cookies_get_how_many(char *chaine);
int climb_cookies_get_cookie_name(char *chain,int pos,char *result);
int climb_cookies_get_cookie_value(char *chain,int pos,char *result);
int climb_cookies_is_cookie_present(char *chain, char *name); // returns cookie position if yes, -1 otherwise
Produire et renvoyer une page HTML de réponse
Pour envoyer une réponse au client web, le script en C a juste à faire des printf puisque sa sortie standard est de facto connectée à NginX, qui sert de passe plat vers le navigateur du client.
Cependant, il faut veiller à ce que la première partie de la réponse soit :
printf("Content-type: text/html\n\n");En effet, sans cet entête la réponse HTML envoyée par notre programme ne sera pas considérée comme valide.
De même, si notre script en C devait répondre en JSON et non en HTML, l’entête devra obligatoirement être :
Content-Type: application/json Pour info, c’est déjà ce qu’envoie la fonction :
void climb_http_response_init();Une fois envoyé l’entête HTML, le script en C doit construire une page de réponse en HTML5 / CSS / Javascript, ou utiliser un framework (j’ai longtemps utilisé JQUERY MOBILE mais il est désuet).
Généralement je travaille un look moderne de page avec une IA comme DeepSeek, et l’IA me génère le fichier styles.css aux petits oignons que j’utilise ensuite dans mes réponses en C.
Conclusion
Au final on voit qu’avec la librairie climb tout est super simple : 4 fonctions pour lire l’entrée, quelques fonctions bien senties pour faciliter les traitements, et de simples printf en sortie pour générer la réponse.