Archives de catégorie : Réseaux

Tutoriel Android / Linux : Installer et utiliser SimpleX chat, la messagerie chiffrée sans identifiant

SimpleX Chat part d’un constat simple : la plupart des messageries chiffrées protègent le contenu des messages, mais laissent fuiter l’essentiel : qui parle à qui.

Signal et WhatsApp savent que vous existez, que vous avez un numéro ou un compte, et quels contacts vous échangez. SimpleX pousse la logique un cran plus loin en supprimant purement et simplement la notion d’identifiant utilisateur.

En effet, SimpleX Chat est une application de messagerie open source qui se présente comme le premier réseau de messagerie sans identifiant utilisateur d’aucune sorte, pas même un identifiant aléatoire .

Concrètement, il n’y a ni numéro de téléphone, ni nom d’utilisateur, ni adresse email à fournir. Votre profil et vos contacts sont stockés uniquement sur votre appareil, et les serveurs relais n’y ont pas accès .

L’application est disponible sur Android, iOS, Linux, macOS et Windows . Elle est gratuite et son code source est public.

Fonctionnement : des files d’attente plutôt que les identités

Le fonctionnement de SimpleX repose sur un renversement architectural. Au lieu d’attribuer à chaque utilisateur une adresse unique par laquelle transiteraient tous ses messages, SimpleX crée des files d’attente unidirectionnelles (queues) pour chaque conversation. Une file sert à recevoir les messages, une autre à les envoyer. Ces files ont des identifiants éphémères et aléatoires, sans lien avec votre personne .

Pour contacter quelqu’un, vous ne cherchez pas son nom d’utilisateur : vous lui transmettez un lien d’invitation à usage unique (ou un QR code), par un canal externe (de vive voix, SMS, etc.). Une fois la connexion établie, vos messages transitent par des serveurs relais qui ne voient qu’un flux chiffré entrant et sortant, sans pouvoir relier les deux files à une même conversation ni identifier les personnes .

Le chiffrement de bout en bout est assuré par un protocole de double ratchet résistant aux attaques quantiques, et il est activé par défaut pour tous les échanges, y compris les fichiers, les appels audio/vidéo et les messages vocaux .

Ce qui distingue SimpleX de Signal et WhatsApp

La différence tient en un mot : les métadonnées.

WhatsApp appartient à Meta et repose sur un numéro de téléphone comme identifiant. Même avec le chiffrement de bout en bout, l’entreprise sait qui vous êtes, qui sont vos contacts, et quand vous communiquez.

Signal est bien meilleur élève : l’application est open source, à but non lucratif, et ne conserve quasiment aucune métadonnée. Mais elle repose toujours sur un numéro de téléphone comme identifiant, et son architecture centralisée implique que les serveurs Signal savent quels comptes existent et quand ils se connectent, même s’ils ne savent pas qui parle à qui.

SimpleX élimine l’identifiant lui-même. Il n’y a pas de « compte » à proprement parler. Chaque conversation utilise des files d’attente anonymes et jetables. Le serveur relais ne peut pas reconstruire de graphe social parce qu’il n’y a pas de nœuds à relier . Cette approche a un coût : pas d’annuaire, pas de découverte de contacts, une ergonomie d’ajout de contact moins fluide. C’est le prix de la confidentialité des métadonnées.

Continuer la lecture →
Tutoriel Linux : Les sockets réseau (Travaux pratiques)

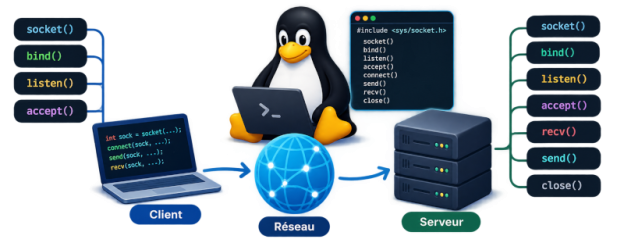
Pour faire suite à l’article sur la théorie, voici l’article sur la pratique en C.

Le principe est simple : tout d’abord nous allons mettre toutes les fonctions en C dont ont besoin un client ou un serveur pour gérer les sockets réseau dans un couple de fichiers sockets.h et sockets.c que voici :

sockets.h :

/*
 * sockets.h
 * ---------
 * Interface des fonctions réseau TCP/UDP, compatible IPv4 et IPv6.
 */
#ifndef SOCKETS_H
#define SOCKETS_H

#include <stddef.h>   /* pour size_t */

/*
 * Crée une socket TCP en écoute sur le port donné (ex: "56000").
 * Retourne un descripteur prêt pour accepter_client(), ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_tcp(const char *port);

/*
 * Crée une socket UDP liée au port donné.
 * Retourne un descripteur, ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_udp(const char *port);

/*
 * Se connecte en TCP à hote:port (IPv4 ou IPv6, automatique).
 * Retourne un descripteur connecté, ou -1.
 */
int contacter_socket_tcp(const char *hote, const char *port);

/*
 * Se connecte en UDP à hote:port.
 * Retourne un descripteur, ou -1.
 */
int contacter_socket_udp(const char *hote, const char *port);

/*
 * Accepte une connexion entrante sur la socket d'écoute fd_ecoute.
 * - fd_ecoute       : descripteur renvoyé par etablir_socket_ecoute_tcp()
 * - adresse_client  : buffer où sera écrite l'adresse IP du client
 *                     (chaîne lisible, ex: "127.0.0.1" ou "::1")
 * - taille_adresse  : taille du buffer ci-dessus
 *
 * Retourne le descripteur de la connexion client, ou -1.
 * Aucun struct sockaddr n'est exposé à l'appelant.
 */
int accepter_client(int fd_ecoute, char *adresse_client, size_t taille_adresse);

#endif /* SOCKETS_H */

Comme on peut le voir, on a à notre disposition 4 fonctions : 2 fonctions destinées à être utilisées par les programmes serveurs (etablir_socket_ecoute_tcp et etablir_socket_ecoute_tcp) et 2 fonctions destinées à être utilisées par les programmes clients (contacter_socket_tcp et contacter_socket_udp).

Le code de ces fonctions est prévu pour tenter des connexions IPv6 si disponible, et de basculer automatiquement sur IPv4 si IPv6 n’est pas disponible pour la connexion.

Continuer la lecture →

Tutoriel Linux : Les sockets réseau

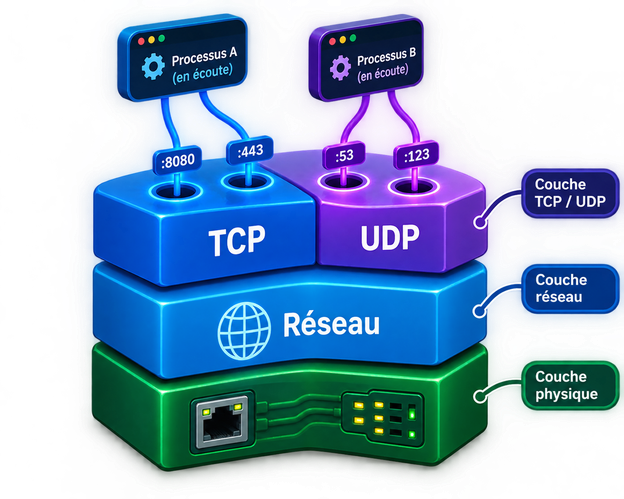
Les sockets font partie des mécanismes qui permettent aux processus de communiquer entre eux. Cependant, contrairement aux IPC classiques (segments de mémoire partagée, queues de messages, et même pipes), ce mécanisme est prévu pour faire communiquer des processus situés sur … des machines différentes.

Et comme les machines sont différentes et qu’il a bien fallu inventer des standards, les processus qui vont communiquer via ces mécanismes sont situés sur des machines différentes … dont le système d’exploitation est potentiellement différent.

Ainsi, via les sockets, une machine Linux va pouvoir communiquer avec un Mac ou une machine Windows, et inversement.

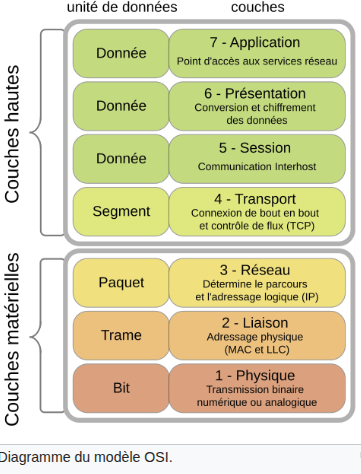
Le modèle OSI

Toutes les machines qui souhaitent communiquer avec d’autres doivent se conformer au modèle OSI.

Avec ce modèle, les logiciels réseaux installés sur chaque machine sont rangés en 7 couches en théorie.

Au niveau 7 on a l’application qui veut communiquer avec une autre application, située elle aussi au niveau 7 sur une autre machine.

Les données que l’application souhaite envoyer à l’autre application descendent successivement les couches réseaux de la machine de départ, chaque couche encapsulant les données reçues de la couche du dessus et à destination de la couche équivalente sur la machine d’arrivée.

La dernière couche qui reçoit les données est la couche physique (couche 1) et c’est de là que les données quittent la machine sous forme de paquets. Ces paquets trouvent leur chemin vers la machine destination (qui peut être sur Internet, donc potentiellement de l’autre côté de la Terre) via un réseau de routeurs qui sont hors sujets dans le cadre de cet article.

Arrivés à la machine destination (potentiellement dans le désordre), ces paquets remontent les 7 couches de celle-ci (en désencapsulant à chaque couche) jusqu’à ce qu’ils soient délivrés à l’application (couche 7) qui attend ces données sur la machine destinatrice.

Bien sûr, l’application destinatrice pourra elle aussi envoyer des données de réponse à l’application émettrice en utilisant la mécanique inverse.

Continuer la lecture →

Tutoriel Linux : sécuriser NginX avec mTLS (authentification mutuelle)

Lorsqu’on auto-héberge des services accessibles par le web, il est courant d’utiliser le serveur web NginX.

Le cadre architectural dans lequel on travaille est toujours le même :

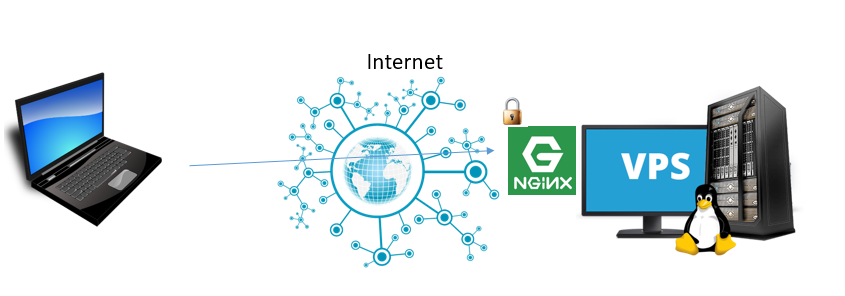
Un client web se connecte à l’un de nos services web auto-hébergés, protégé par du https.

Concrètement cela signifie que le client va pouvoir authentifier le serveur web, en récupérant le certificat https que celui-ci présente et en vérifiant la signature de ce certificat par une autorité de confiance (ici Let’s encrypt). Pour réaliser cela, le navigateur web du client utilise juste la clé publique de l’autorité Let’s encrypt, dont il dispose (les clés publiques de toutes les autorités ayant pignon sur rue sur Internet sont intégrés dans les navigateurs). Le client n’aura donc même pas à contacter Let’s encrypt pour vérifier que le certificat présenté par le serveur est authentique, et donc que l’on peut faire confiance à ce site : il est bien qui il prétend être.

Cette mécanique a été pensée pour favoriser le e-commerce, pour donner confiance au consommateur de sorte qu’il accepte de fournir son numéro de carte bancaire tout en ayant l’assurance ni qu’elle soit interceptée pendant la transmission, ni qu’elle soit transmise à un site margoulin.

Pratiquement tout le web fonctionne comme cela, et vous serez obligé de rester sur ce modèle si vos services auto-hébergés s’adressent à un large public, que vous ne connaissez pas (un site wordpress par exemple).

Dans ce modèle, le serveur est authentifié par le client, mais le client n’est pas authentifié par le serveur. Dans ce modèle, le serveur tente de susciter la confiance du client, mais le client ne se soucie pas de susciter la confiance du serveur. Le postulat de base est que le serveur est connu, et les clients sont anonymes. Le site se chargera de vérifier l’identité du client plutôt en lui présentant une page demandant son login et son mot de passe de client commercial.

Ce modèle est-il adapté par contre si votre VPS n’a pas vocation à offrir des services web à la terre entière mais seulement à vous et à quelques uns de vos amis ?

La réponse est oui, cela fonctionnera. Les pages vous seront accessibles bien sûr, mais elles seront également accessibles à la terre entière. Ok la terre entière tombera sur une page de login / mot de passe, qu’elle n’a pas. Mais qu’est-ce-qui l’empêche de tenter des milliards de mots de passe pour essayer de rentrer ? Rien en fait.

Il existe donc un autre modèle, le mTLS.

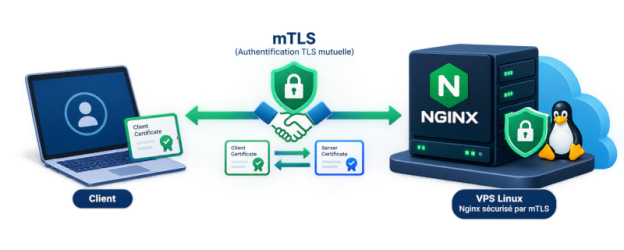
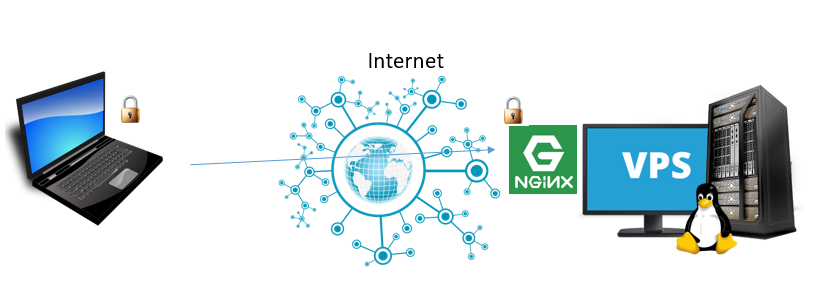
Dans ce modèle, le serveur présente toujours au client les certificats que lui a fournis Let’s encrypt. Ce qui change par contre c’est que le client dispose lui aussi de certificats prouvant son identité et il les présente au serveur. Cette vérification mutuelle donne son nom au modèle : mTLS (pour mutual TLS, TLS étant le nom technique de ce que le grand public appelle https).

Avec ce modèle, il faut que l’authentification mutuelle réussisse pour que la page web proposée par le serveur soit envoyée au client et apparaisse sur son écran.

Un tiers qui ne dispose pas des certificats client et qui tente une connexion au serveur ne verra même pas la page de login. Il ne sera donc pas capable de lancer une salve de tentatives d’intrusion.

Lorsqu’on met en ligne un VPS dédié à un nombre très restreint d’utilisateurs (par exemple les employés de notre micro-entreprise), il peut être utile d’activer l’authentification mutuelle mTLS. Elle permet aux utilisateurs authentifiés d’accéder aux services web du VPS, tout en rendant ces derniers invisibles au reste d’Internet.

Nous allons voir dans cette section comment activer le mTLS

Continuer la lecture →

Tutoriel Linux : page html mise à jour en temps réel par un serveur websocket écrit en langage C

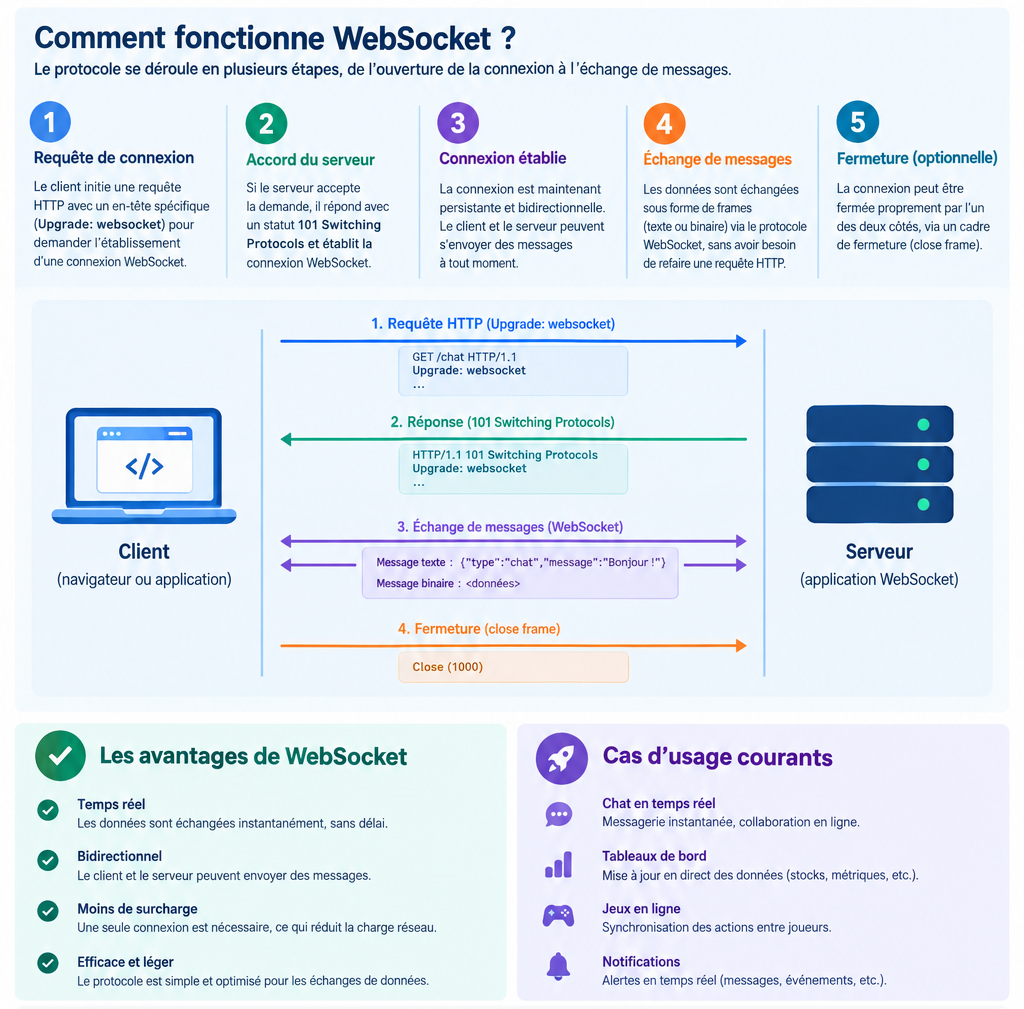
Une websocket est un protocole de communication qui permet d’établir une connexion permanente et bidirectionnelle entre un client (généralement un navigateur) et un serveur. Elle est normalisée par l’IETF sous la référence RFC 6455 et fonctionne au-dessus de TCP.

Contrairement au modèle classique du web, où le client envoie une requête et le serveur répond puis ferme la connexion, la websocket maintient un canal ouvert dans les deux sens. Une fois la connexion établie, le client et le serveur peuvent s’envoyer des données à tout moment, sans attendre une nouvelle requête.

Comment la connexion s’établit

La websocket démarre par une requête HTTP classique contenant un en-tête spécifique, Upgrade: websocket. Si le serveur accepte, il répond avec un code 101 (Switching Protocols). À partir de ce moment, la connexion HTTP est transformée en connexion websocket, et les échanges suivent un format de trames propre à ce protocole.

Ce mécanisme de poignée de main permet de réutiliser l’infrastructure existante du web : ports 80 et 443, proxys, TLS. Une websocket peut donc fonctionner en ws:// ou en wss:// pour la version chiffrée.

Continuer la lecture →

Tutoriel Linux : Installer un serveur DNS récursif sur son VPS avec Unbound

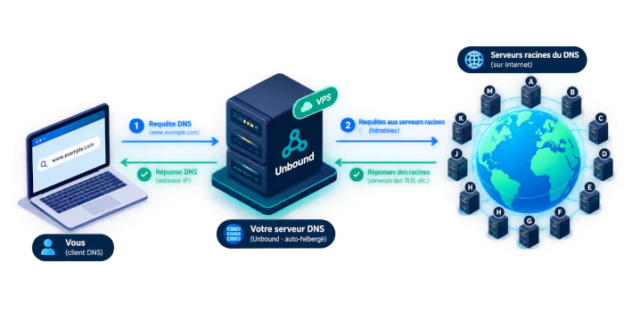
Le DNS (Domain Name System) est un service fondamental sur Internet, puisque c’est lui qui permet à notre ordinateur de joindre une machine dont on ne connait que le nom.

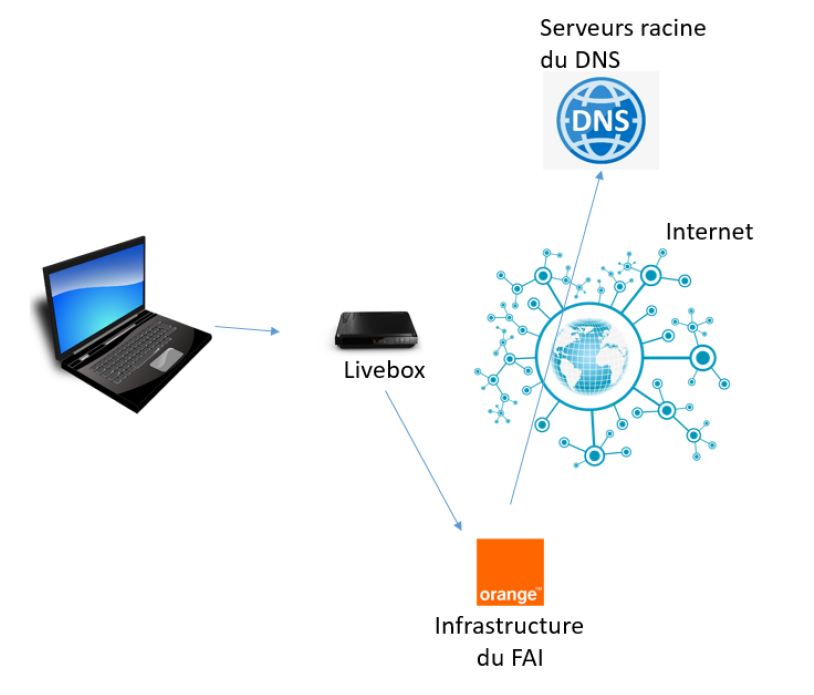
Dans une configuration typique, si l’on ne touche à aucun paramétrage particulier, le fait de taper par exemple https://cnn.com dans la barre d’URL du navigateur de notre laptop va entraîner la séquence suivante :

– Le laptop va faire une requête DNS (protocole UDP, port 53) à la Livebox (« Quelle est l’adresse IP de la machine cnn.com ? »)

– La Livebox (adresse IP 192.168.1.1 généralement) va répercuter cette demande à l’infrastructure du FAI (exemple d’Orange dans la figure ci-dessus)

– Soit l’infrastructure du FAI a déjà la réponse, parce qu’elle a déjà questionné les serveurs racines du DNS sur Internet, auquel cas elle répond. Soit elle n’a pas la réponse et elle questionne récursivement les serveurs DNS racine sur Internet, qui eux vont fournir la réponse

– La réponse (l’adresse IP de la machine cnn.com) fait le trajet en sens inverse jusqu’au laptop

– Le laptop ouvre une connexion avec la machine en utilisant l’adresse IP qu’elle a reçue en réponse.

Les serveurs racine du DNS sur Internet sont des serveurs qui sont les points d’entrée d’un système hiérarchique, c’est pourquoi on parle de récursivité. Concrètement, si l’on souhaite l’adresse IP de la machine toto.cnn.com, le serveur racine du domaine .com sera consulté en premier, puis le serveur du domaine cnn.com.

Bref, on utilise ainsi le DNS en permanence sans même s’en douter.

Cependant cette configuration pose problème. En effet, le FAI est régulièrement sommé par les autorités d’effacer certaines machines du DNS. Techniquement c’est facile à faire : si les autorités demandent d’effacer la machine cnn.com (exemple fictif), alors le FAI paramètre son architecture DNS pour renvoyer comme réponse 127.0.0.1 en IPv4, ::1 en IPv6, au lieu de la vraie adresse IP, quand une requête DNS demandant l’adresse IP de cette machine est reçue.

127.0.0.1 et ::1 sont des adresses IP locales, qui ne permettront pas au laptop demandeur d’en faire quoi que ce soit. La machine cnn.com est ainsi invisibilisée (mais elle est toujours là) d’Internet.

Continuer la lecture →

Tutoriel Linux : créer un réseau VPN Nebula

Nebula est né d’une difficulté d’ingénierie bien concrète. Vers la fin de 2016, le réseau de production de Slack connaissait une expansion rapide, et la solution IPSec utilisée alors pour relier les serveurs entre les régions commençait à montrer ses limites. Chaque paquet traversant les régions devait passer par un hôte tunnel IPSec, ajoutant un saut de latence sans contrepartie.

Plus problématique encore : à mesure que le réseau s’étendait sur plusieurs fournisseurs de cloud et des dizaines de sites, les « groupes de sécurité » propres à chaque fournisseur devenaient incompatibles entre eux, et les règles de pare-feu se réduisaient à une gestion grossière par plages d’adresses IP.

Nate Brown et Ryan Huber ont évalué toutes les solutions disponibles à l’époque. Aucune ne satisfaisait simultanément les exigences de Slack en matière de performance, d’échelle et de simplicité opérationnelle. Ils ont donc décidé de construire la leur. Le résultat de cette décision s’appelle Nebula, un système de réseau superposé qui, depuis le milieu de l’année 2017, porte l’essentiel du trafic réseau de Slack en interne, et qui n’a été basculé en open source qu’en novembre 2019.

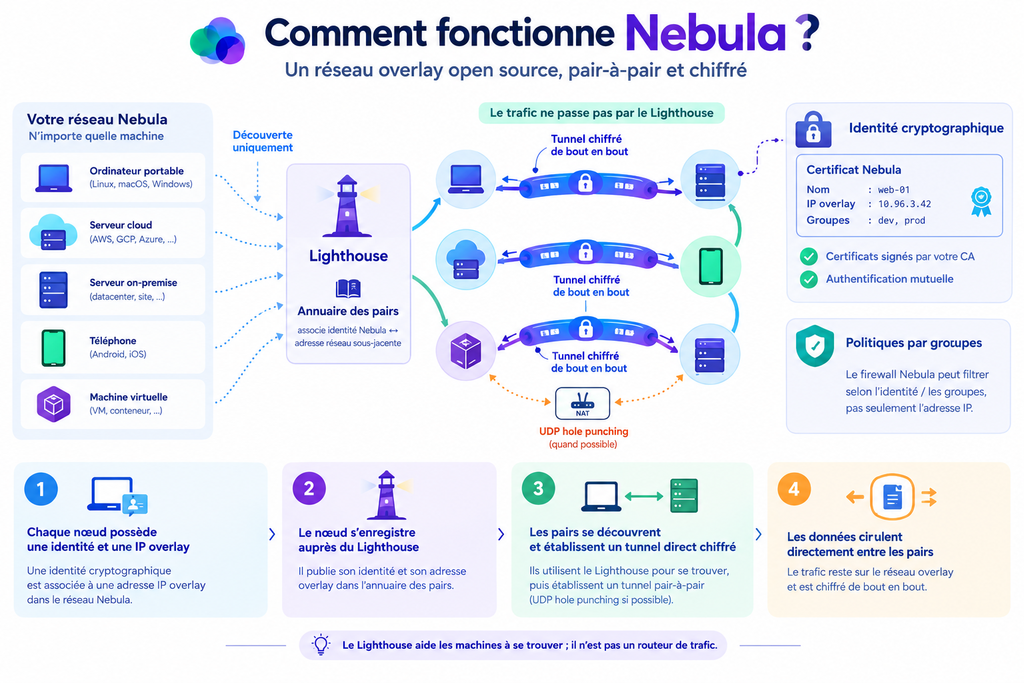
Le principe de conception central de Nebula peut se résumer ainsi : intégrer l’identité numérique directement dans le tunnel chiffré, afin d’éliminer ce problème de distribution des clés qui empoisonne les architectures VPN traditionnelles. En effet, dans la plupart des réseaux superposés bâtis sur WireGuard, le chiffrement est assuré par WireGuard, mais la gestion des clés, l’authentification et le contrôle d’accès reposent sur un système latéral construit séparément. Cela signifie que lorsqu’une nouvelle machine rejoint le réseau, le service de coordination doit prévenir tous les nœuds existants pour qu’ils mettent à jour leur configuration. À l’échelle de Slack, c’est-à-dire plus de cinquante mille machines de production, chaque nouveau nœud impliquait d’informer cinquante mille nœuds de son existence, une approche intenable.

La solution de Nebula consiste à faire porter l’identité par des certificats PKI. Chaque machine reçoit, avant de rejoindre le réseau, un certificat signé par une autorité de certification, dans lequel sont encodés son adresse IP au sein du réseau superposé, son nom, ainsi que son appartenance à des groupes de sécurité définis par l’utilisateur. Lorsque deux machines communiquent pour la première fois, elles échangent et vérifient directement leurs certificats, confirment mutuellement leur identité, puis établissent un tunnel chiffré. Ce processus ne nécessite aucune distribution préalable de clés par un tiers, ni l’intervention d’un plan de contrôle pour coordonner les échanges. Selon les mots de Ryan Huber, ils voulaient un protocole qui traite directement l’identité et le transport, plutôt que d’accoler une identité à un VPN distinct.

Cette logique de décentralisation se retrouve également dans le mécanisme de découverte des nœuds. Il existe dans un réseau Nebula une catégorie de nœuds appelés Lighthouse (phare en français), dont l’unique fonction est de servir d’annuaire : indiquer à une machine comment en trouver une autre. Les Lighthouse ne communiquent pas entre eux et ne participent à aucun transfert de données. Si un réseau compte six Lighthouse et que cinq d’entre eux tombent en panne, le dernier continue de fonctionner normalement, et les chemins de trafic de l’ensemble du réseau restent inchangés.

Continuer la lecture →
Tutoriel Linux : auto-héberger Ntfy, le service de notification de smartphones

Lorsqu’on développe une application web qui ambitionne de tourner sur mobile, on n’a que peu d’accès au matériel du smartphone (notifications, GPS, etc.), contrairement à une application mobile native.

Accéder à une notification des clients sur smartphones depuis une application web n’est pas impossible, mais au prix de circonvolutions et de ruses de Sioux techniques.

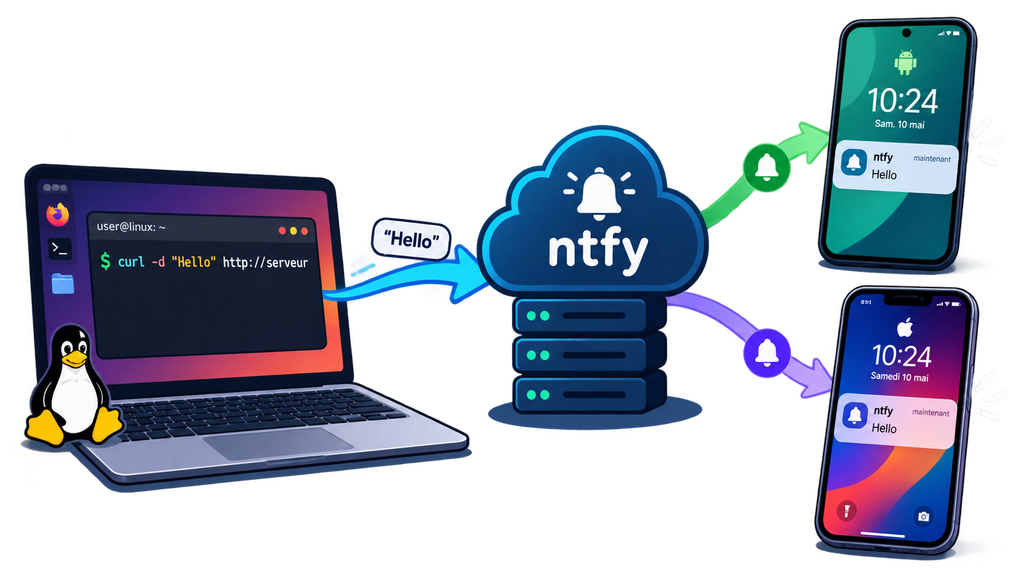
Heureusement, on peut laisser de côté la recherche de cet exploit technique puisqu’il existe un service clé en main qu’on peut utiliser pour faire notifier des smartphones depuis une application web : Ntfy (prononcer notify).

Ntfy est un service de notification. Il ne fait que cela, mais il le fait très bien. Ce service existe sous forme de SaaS ou auto-hébergeable gratuitement. C’est cette version gratuite auto-hébergée que nous allons mettre en place dans ce tutoriel.

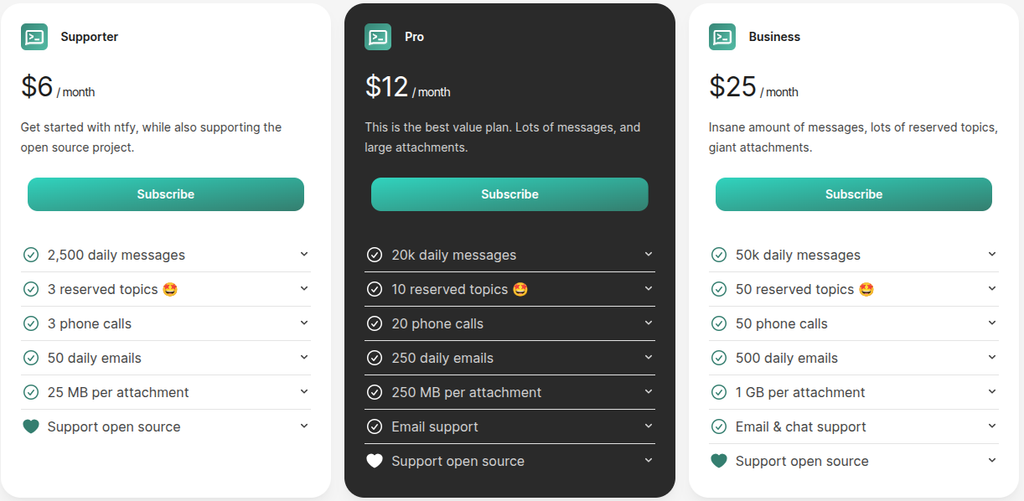
Prix des plans payants de la version SaaS
Continuer la lecture →

Tutoriel Linux : obfusquer le trafic Wireguard

Mettre en place un tunnel Wireguard entre des machines et un serveur est très utile mais cela n’est pas discret.

En effet, s’il est impossible pour un intervenant extérieur de visualiser en clair le trafic vu qu’il est chiffré, la nature Wireguard du trafic est par contre très facile à déterminer.

Dans un environnement réseau sous surveillance interdisant le trafic Wireguard, celui-ci sera facilement bloqué. La solution pour passer quand même est d’obfusquer le trafic en l’encapsulant dans un tunnel d’obfuscation.

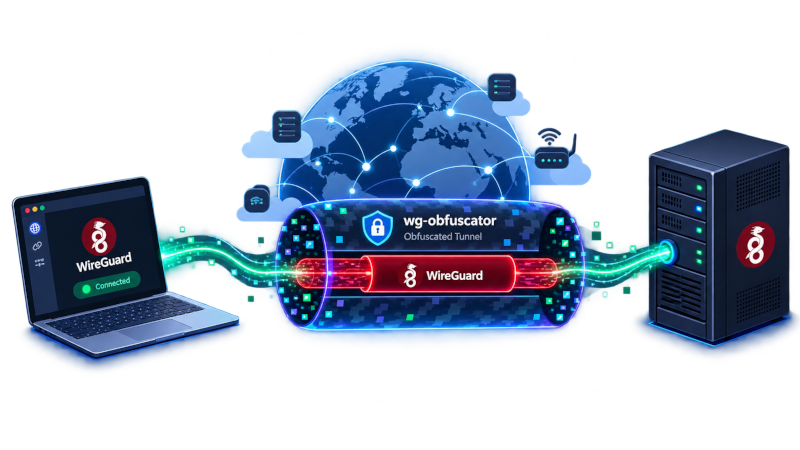
Celui que nous allons utiliser dans ce tutoriel est wg-obfuscator, qui obfusque le trafic pour le faire ressembler à une visio-conférence, soit une nature de trafic moins sujet à des filtrages.

Rappel : l’installation de Wireguard sans obfuscation a déjà été couverte dans cet article.

Continuer la lecture →

Tutoriel Linux : auto-héberger IT-tools, une boîte de +80 outils IT indispensables

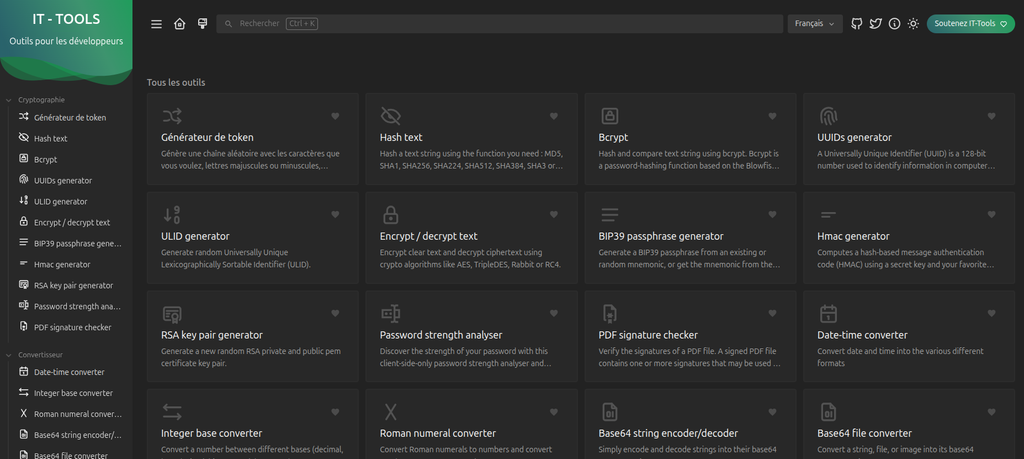
IT-tools est une boîte contenant plus de 80 outils IT indispensables aux personnes travaillant dans le domaine de l’IT. Il est auto-hébergeable sur un serveur en ligne via docker et programmé par le français Corentin Thomasset (ingénieur INSA Lyon).

Une instance en ligne est utilisable directement sur it-tools.tech pour ceux qui auraient la flemme de l’auto-héberger.

Indépendamment de disposer d’une interface web moderne ultra-léchée, la boîte à outil est incroyablement simple à auto-héberger sous docker.

Installation d’IT-tools avec docker compose

Créez un répertoire ittools-docker et mettez-y un fichier docker-compose.yml qui contient :

services:
    it-tools:
        image: ghcr.io/corentinth/it-tools:latest
        ports:
            - "8080:80"
        restart: unless-stopped
        container_name: it-tools

Lancez le service par :

docker compose up -d

Et voilà, c’est installé. Il n’y a plus qu’à se rendre sur http://serveur:8080 pour accéder à la boîte à outils.

Les outils mis à disposition

Le paramétrage de l’interface propose 8 langues, dont bien sûr le français.

Au niveau des outils mis à disposition, c’est le feu d’artifice.

Chaque rubrique propose au moins une dizaine d’outils utilisables d’un clic. Les rubriques couvrent la cryptographie, la conversion de formats, les outils web, la génération de qr codes, le développement, les réseaux, les maths, les mesures, les manipulations de textes, les données.

A chaque mise à jour de l’image docker, on bénéficie d’outils supplémentaires.

Bémol

Attention, la configuration du docker-compose.yml présentée ici aboutit non seulement à un outil en http et non en https, mais aussi un outil accessible à n’importe quel internaute qui connaîtrait l’URL du service.

La seule manière de rendre ce service privé serait de le cacher derrière un reverse proxy présentant à l’internaute une authentification basique.