Archives par étiquette : C

Tutoriel Linux : développement web avec backend en langage C (Episode 4 – L’extraction et le décodage des données du formulaire)

Dans l’épisode 3 nous avons vu comment coupler un formulaire HTML (form) présenté au client web et rempli par lui, et un script écrit en C qui reçoit et traite ces données.

Nous avons vu que le script en C récupère pour le formulaire une chaine de caractère unique, comme par exemple :

texte=C%27est+une+vir%C3%A9e+ma%C3%A7onnique+v%C3%A9n%C3%A8re+%23%24*&motdepasse=re%C3%A7u

Cette chaine reprend les champs définis par le formulaire (texte et motdepasse) séparés par le caractère &, et les valeurs envoyées par le formulaire pour ces champs (C%27est+une+vir%C3%A9e+ma%C3%A7onnique+v%C3%A9n%C3%A8re+%23%24* pour texte, et re%C3%A7u pour motdepasse).

Ces valeurs doivent maintenant pouvoir être extraites une par une, et surtout doivent pouvoir être retraitées pour que le codage HTML effectué par le navigateur du client soit décodé pour retrouver les frappes exactes réalisées par l’utilisateur.

C’est pourquoi nous allons ajouter quelques fonctions au programme script.c que nous avons vu à l’épisode 3.

Nous allons notamment ajouter la fonction http_request_body_item qui permet de lire la valeur de rang n dans la chaine de caractère unique (n=1 pour la dernière valeur de la chaine, n=2 pour l’avant dernière valeur de la chaine, etc.), et la fonction http_translate qui décode la valeur passée en paramètre.

Voici donc le nouveau programme script.c complet, avec capacité d’extraction et de décodage des champs :

#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <string.h>

char* http_post_request_body()
{
int query_size;

query_size=atoi(getenv("CONTENT_LENGTH"));
char* query_string = (char*) malloc(query_size+10);
if (query_string != NULL) fread(query_string,query_size,1,stdin);
return query_string;
}

int http_request_body_item(char *in_string,int pos,char *out_string)
{
int i,n,start;

i=strlen(in_string);
for(n=0; n<pos;n++) 
	{
	while(in_string[i]!='=') i--;
	i--;
	}
i+=2;
start=i;
do
	{
	out_string[i-start]=in_string[i];
	i++;
	}
while(in_string[i-1]!=0 && in_string[i-1]!='&');
out_string[i-start-1]=0;
}

void http_urldecode(char *string)
{
int i,start;
char *res,buf[50];

start=i=0;
res=(char *)malloc(10*strlen(string));
while(i<=strlen(string))
	{
	if(string[i]!='%') 
		{
		res[start]=string[i];
		i++;
		start++;
		}
	else
		{
		if(string[i+1]=='0' && string[i+2]=='A')
			{
			res[start]='\\';
			res[start+1]='\\';
			res[start+2]='n';
			start = start+3;
			i = i+3;
			}
		else
			{
			if(string[i+1]!='3' || string[i+2]!='C')
				{
				sprintf(buf,"0x%c%c",string[i+1],string[i+2]);
				res[start]=strtol(buf,NULL,16);
				start++;
				i = i+3;
				}
			else
				{
				res[start]='&';
				res[start+1]='l';
				res[start+2]='t';
				res[start+3]=';';
				start = start+4;
				i = i+3;
				}
			}
		}
	}
strcpy(string,res);
free(res);
}

void http_prepare(char *string)
{
int i,start;
char *res;

res=(char *)malloc(strlen(string)*2);
i=start=0;
do
	{
	if(string[i]!=';' && string[i]!='\'' && string[i]!='"') res[start]=string[i];
	else res[start]=' ';
	start++;
	i++;
	}
while(i<=strlen(string));
strcpy(string,res);
free(res);
}

void http_translate(char *in_string)
{
int i;

for(i=0;i<strlen(in_string);i++)
	{
	if(in_string[i]=='+') in_string[i]=' ';
	}
http_urldecode(in_string);
http_prepare(in_string);
}

int main()
{
char *request_body;
extern char **environ;
char **e;
char *texte,*motdepasse;

request_body=http_post_request_body(); // on récupère les données envoyées par le formulaire
// On initialise la taille des deux variables qui vont accueillir les données tapées par l'utilisateur dans le formulaire.
// Cette manière de faire garantit que le débordement de tampon (buffer overflow) sera impossible
texte=(char *)malloc(strlen(request_body));
motdepasse=(char *)malloc(strlen(request_body));
http_request_body_item(request_body,2,texte); // On récupère l'avant dernière (position 2 par rapport à la fin) information brute transmise par le formulaire, donc le texte tapé codé HTML
http_translate(texte); // On réalise le décodage texte tel que l'utilisateur l'a tapé
http_request_body_item(request_body,1,motdepasse); // On récupère la dernière (position 1 par rapport à la fin) information transmise par le formulaire, donc le mot de passe tapé
http_translate(motdepasse);
// on construit maintenant la page html de réponse, en écrivant sur la sortie standard. NginX intercepera cette sortie et l'enverra tout seul au client web
printf("Content-type: text/html\n\n"); // Cette ligne d'entête est fondamentale. Sans elle le format de réponse ne serait pas respecté
printf("<!DOCTYPE html>\n\
<html lang=\"fr\">\n\
<head>\n\
	<meta charset=\"UTF-8\">\n\
    <title>Page de réponse du script</title>\n\
</head>\n\
<body>\n");
printf("Données reçues du formulaire : %s<br>Texte tapé : %s<br>\nMot de passe tapé : %s<br><br>\n",request_body,texte,motdepasse);
printf("Variables d'environnement du formulaire : <br><br>\n");
for(e=environ;*e;e++) printf("%s<br>\n",*e);
printf("</body>\n\
</html>\n");
}

Comme dans l’épisode 3, on le compile et installe par les commandes :

gcc script.c -o script.cgi
sudo cp ./script.cgi /usr/lib/cgi-bin

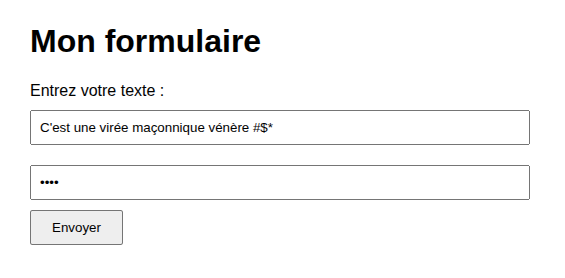
Voici ce que donne la réponse du script en C quand on saisit des données dans le formulaire :
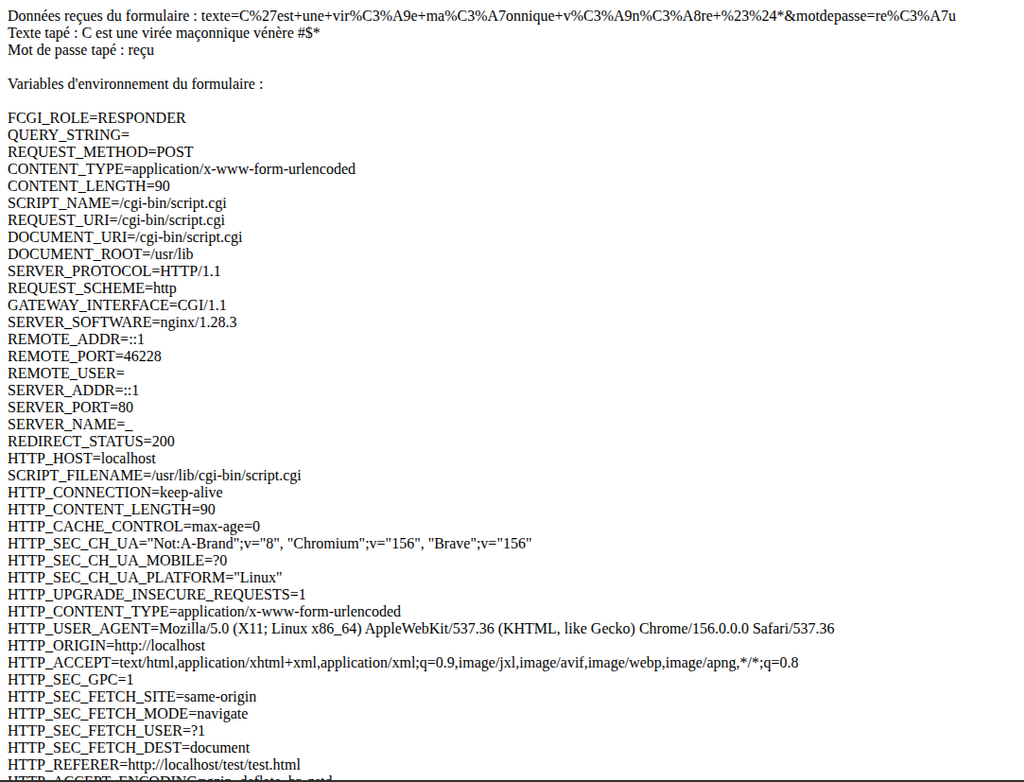
Le script a bien extrait et décodé les données du formulaire puisqu’il affiche :

Texte tapé : C est une virée maçonnique vénère #$*
Mot de passe tapé : reçu

Pour être franc, le script a retiré l’apostrophe de C’est. On peut la garder mais c’est le genre de détail dangereux si le script en C est couplé à une base MySQL (ce qui n’est pas le cas ici), car le maintient de l’apostrophe sans ruser ouvrirait la porte à une attaque par injection SQL.

Il est bien évident que les fonctions C d’extraction et de décodage que nous avons ajoutées seront à utiliser dans tous les futurs scripts. Le réflexe naturel est donc de regrouper ces fonctions dans un fichier C à part, réutilisable.

Si l’on met à part ces fonctions, le corps du script en C restant devient finalement très simple, puisque cela se résume à la fonction main :

int main()
{
char *request_body;
extern char **environ;
char **e;
char *texte,*motdepasse;

request_body=http_post_request_body(); // on récupère les données envoyées par le formulaire
// On initialise la taille des deux variables qui vont accueillir les données tapées par l'utilisateur dans le formulaire.
// Cette manière de faire garantit que le débordement de tampon (buffer overflow) sera impossible
texte=(char *)malloc(strlen(request_body));
motdepasse=(char *)malloc(strlen(request_body));
http_request_body_item(request_body,2,texte); // On récupère l'avant dernière (position 2 par rapport à la fin) information brute transmise par le formulaire, donc le texte tapé codé HTML
http_translate(texte); // On réalise le décodage texte tel que l'utilisateur l'a tapé
http_request_body_item(request_body,1,motdepasse); // On récupère la dernière (position 1 par rapport à la fin) information transmise par le formulaire, donc le mot de passe tapé
http_translate(motdepasse);
// on construit maintenant la page html de réponse, en écrivant sur la sortie standard. NginX intercepera cette sortie et l'enverra tout seul au client web
printf("Content-type: text/html\n\n"); // Cette ligne d'entête est fondamentale. Sans elle le format de réponse ne serait pas respecté
printf("<!DOCTYPE html>\n\
<html lang=\"fr\">\n\
<head>\n\
	<meta charset=\"UTF-8\">\n\
    <title>Page de réponse du script</title>\n\
</head>\n\
<body>\n");
printf("Données reçues du formulaire : %s<br>Texte tapé : %s<br>\nMot de passe tapé : %s<br><br>\n",request_body,texte,motdepasse);
printf("Variables d'environnement du formulaire : <br><br>\n");
for(e=environ;*e;e++) printf("%s<br>\n",*e);
printf("</body>\n\
</html>\n");
}

Dans l’épisode 5 nous verrons un fichier C réutilisable dans les scripts qui contient tout ce dont on a besoin d’y piocher pour gérer les cas de figure les plus courants, et notamment le dialogue avec une base de données MySQL depuis un script en C.

Stay tuned 😎
Tutoriel Linux : développement web avec backend en langage C (Episode 3 – Le couple form / script)

Maintenant que notre serveur NginX est installé et configuré pour être en mesure de transférer les requêtes des clients web aux scripts CGI, nous allons voir dans cet épisode 3 comment se fait ce dialogue entre le client web et le script CGI.

Côté client web : la form

La page web affichée sur le poste client web va utiliser des forms (formulaires HTML en français).

Il s’agit d’un formulaire contenant des items à afficher dans le formulaire (de différents types comme des inputs pour saisir du texte, des boutons radio, des cases à cocher, des zones de saisie de mot de passe, des listes déroulantes, etc.), un script cible (qui pour nous sera écrit en langage C), et un bouton pour activer le formulaire.

Activer le formulaire signifie que le navigateur web du client va lire les données saisies ou choisies par l’utilisateur, et les envoyer au script CGI.

La nature de l’envoi vers le script CGI est indiquée dans le formulaire. Elle peut être GET ou POST.

Si GET est utilisé, les données saisies dans la form seront transmises sur l’URL du script appelé, ce qui n’est pas top pour la sécurité. C’est pourquoi nous utiliserons que la méthode POST, qui envoie les données vers le script dans le flux html, donc non visible des hommes du milieu dès lors qu’on est en https.

Dans l’exemple que nous allons utiliser, voici la page web que l’on affiche sur le client web :

<!DOCTYPE html>
<html lang="fr">
<head>
    <meta charset="UTF-8">
    <title>Formulaire CGI</title>
    <style>
        body { font-family: sans-serif; max-width: 500px; margin: 50px auto; padding: 20px; }
        input[type="text"] { width: 100%; padding: 8px; margin: 10px 0; box-sizing: border-box; }
	input[type="password"] { width: 100%; padding: 8px; margin: 10px 0; box-sizing: border-box; }
        input[type="submit"] { padding: 8px 20px; cursor: pointer; }
        .result { padding: 15px; background: #eef; border-radius: 5px; }
    </style>
</head>
<body>
    <h1>Mon formulaire</h1>
    <form action="/cgi-bin/script.cgi" method="post">
        <label for="texte">Entrez votre texte :</label>
        <input type="text" placeholder="Entrez du texte ici" id="texte" name="texte" required>
	<input type="password" placeholder="Entrez un mot de passe ici" id="mdp" name="motdepasse" required>
        <input type="submit" value="Envoyer">
    </form>
</body>
</html>

Cette page web comporte un petit script CSS pour l’esthétique, mais surtout elle contient une form (visible en gras), dans laquelle on voit que le formulaire contient comme items à afficher un label (du texte), un input requis (ie on ne pourra pas déclencher le formulaire si ce champ est vide) pour saisir du texte, un mot de passe, et un bouton submit pour déclencher le formulaire.

Comme on peut le voir, ce formulaire a pour cible le script dont l’URL est /cgi-bin/script.cgi en utilisant la méthode POST.

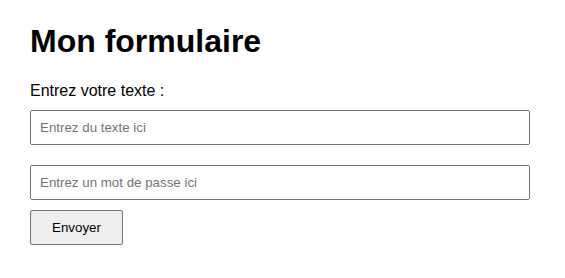
On met ce fichier test.html dans /var/www/html sur le serveur web, ce qui affiche la page suivante sur le navigateur du client lorsqu’il se connecte sur cette URL https://serveur/test.html :

Voici ce qui s’affiche quand l’utilisateur saisit les données :

Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 1 – Introduction)

Le développement web se fait aujourd’hui grâce à des langages modernes : Javascript, Typescript, React pour le frontend, PHP, node.js notamment pour le backend.

Quand j’explique à des programmeurs que je programme mes backends en langage C, ils sont généralement très étonnés que ce soit même faisable.

Et pourtant, ça marche très bien. Ce n’est probablement pas le langage le plus adapté, mais ce n’est pas compliqué et ça marche.

Quels avantages en tirer ?

Tout d’abord la simplicité. Avec le C il n’y a aucune bibliothèque ou framework externe à charger. Le programme ne fera que ce que vous écrivez. Vous maîtrisez la compréhension du code de A à Z. Ce qui ne vous empêche pas bien sûr de vous créer votre propre bibliothèque de routines réutilisables en C.

Deuxièmement, la vélocité. A part l’assembleur, aucun langage n’est aussi rapide que le C. Votre serveur web sera donc hyper véloce.

Troisièmement, l’indépendance. Comme vous n’utilisez aucune bibliothèque ou framework externe, vous n’aurez pas de mise à jour de ceux-ci qui mettent par terre votre mécanique.

Comment ça marche ?

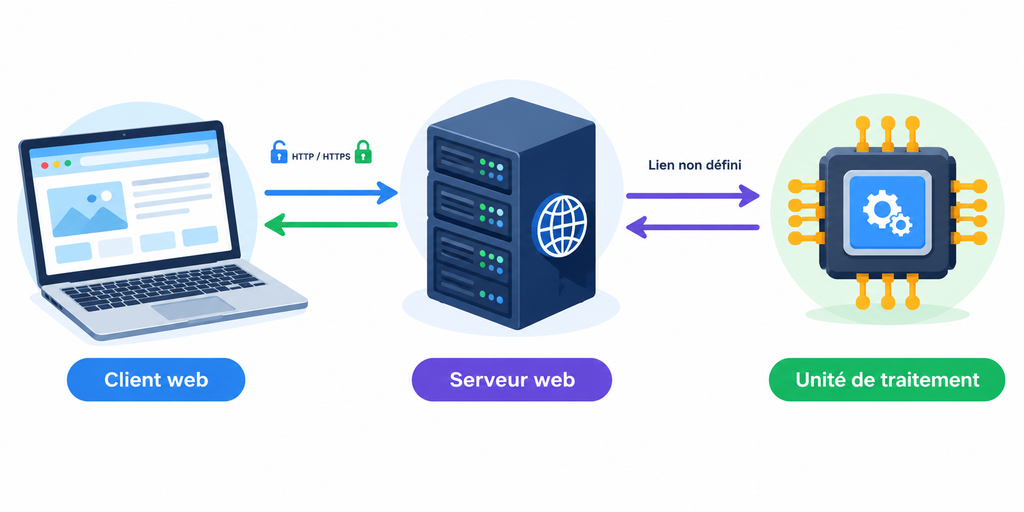
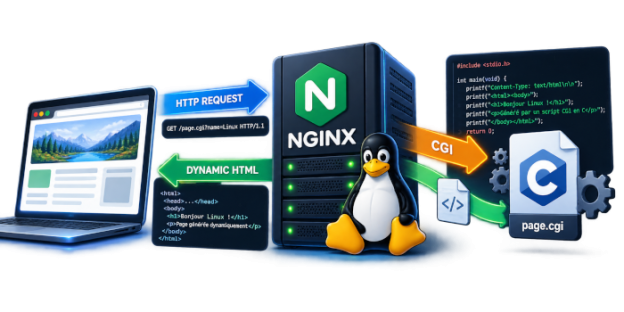
Servir dynamiquement des pages web relève toujours de la même mécanique, représentée ci-dessous :

Le client web à servir (le navigateur) communique avec un serveur sur lequel 2 services tournent : le serveur web et l’unité de traitement.

Le serveur web s’occupe d’un côté de communiquer avec le client en http ou en https, selon comment il est configuré. Et de l’autre côté il s’occupe de transmettre à l’unité de traitement les data des requêtes que le client web lui a envoyées.

L’unité de traitement sait quoi faire des données de requête reçues du client (consulter ou mettre à jour une base de données par exemple), et sait générer une page html de réponse qu’il transmet au serveur web.

Le serveur web récupère la page html générée par l’unité de traitement, et la transmet au navigateur du client qui l’affiche.

NB : Nous nous plaçons ici dans le cas où la page entière est mise à jour, pas la cas où une partie seulement de la page est mise à jour dynamiquement sans recharge de la page entière. Ce cas de figure se traite en effet avec des websockets et a déjà été traité dans l’article sur les websockets en C.

Concrètement, quand on utilise node.js, celui-ci prend en charge seul le serveur web et l’unité de traitement qui est le programme qu’on est en train d’écrire. Ce script est interprété par le moteur V8 mais certaines parties qui sont exécutées souvent sont compilées à la volée pour améliorer la vélocité.

Les sites bâtis avec PHP fonctionnent avec un vrai serveur web (Nginx, Apache, …) et l’unité de traitement est le Zend engine (écrit en C) qui interprète le script de traitement PHP à exécuter (le terme interprète est légèrement abusif puisque le Zend engine fait en réalité une pseudo compilation en bytecode avec d’exécuter le script).

Et le C là dedans ?

Continuer la lecture →

Tutoriel Linux : Les sockets réseau (Travaux pratiques)

Pour faire suite à l’article sur la théorie, voici l’article sur la pratique en C.

Le principe est simple : tout d’abord nous allons mettre toutes les fonctions en C dont ont besoin un client ou un serveur pour gérer les sockets réseau dans un couple de fichiers sockets.h et sockets.c que voici :

sockets.h :

/*
 * sockets.h
 * ---------
 * Interface des fonctions réseau TCP/UDP, compatible IPv4 et IPv6.
 */
#ifndef SOCKETS_H
#define SOCKETS_H

#include <stddef.h>   /* pour size_t */

/*
 * Crée une socket TCP en écoute sur le port donné (ex: "56000").
 * Retourne un descripteur prêt pour accepter_client(), ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_tcp(const char *port);

/*
 * Crée une socket UDP liée au port donné.
 * Retourne un descripteur, ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_udp(const char *port);

/*
 * Se connecte en TCP à hote:port (IPv4 ou IPv6, automatique).
 * Retourne un descripteur connecté, ou -1.
 */
int contacter_socket_tcp(const char *hote, const char *port);

/*
 * Se connecte en UDP à hote:port.
 * Retourne un descripteur, ou -1.
 */
int contacter_socket_udp(const char *hote, const char *port);

/*
 * Accepte une connexion entrante sur la socket d'écoute fd_ecoute.
 * - fd_ecoute       : descripteur renvoyé par etablir_socket_ecoute_tcp()
 * - adresse_client  : buffer où sera écrite l'adresse IP du client
 *                     (chaîne lisible, ex: "127.0.0.1" ou "::1")
 * - taille_adresse  : taille du buffer ci-dessus
 *
 * Retourne le descripteur de la connexion client, ou -1.
 * Aucun struct sockaddr n'est exposé à l'appelant.
 */
int accepter_client(int fd_ecoute, char *adresse_client, size_t taille_adresse);

#endif /* SOCKETS_H */

Comme on peut le voir, on a à notre disposition 4 fonctions : 2 fonctions destinées à être utilisées par les programmes serveurs (etablir_socket_ecoute_tcp et etablir_socket_ecoute_tcp) et 2 fonctions destinées à être utilisées par les programmes clients (contacter_socket_tcp et contacter_socket_udp).

Le code de ces fonctions est prévu pour tenter des connexions IPv6 si disponible, et de basculer automatiquement sur IPv4 si IPv6 n’est pas disponible pour la connexion.

Continuer la lecture →

Tutoriel Linux : page html mise à jour en temps réel par un serveur websocket écrit en langage C

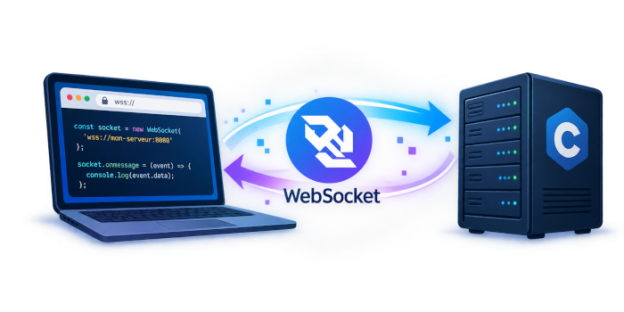
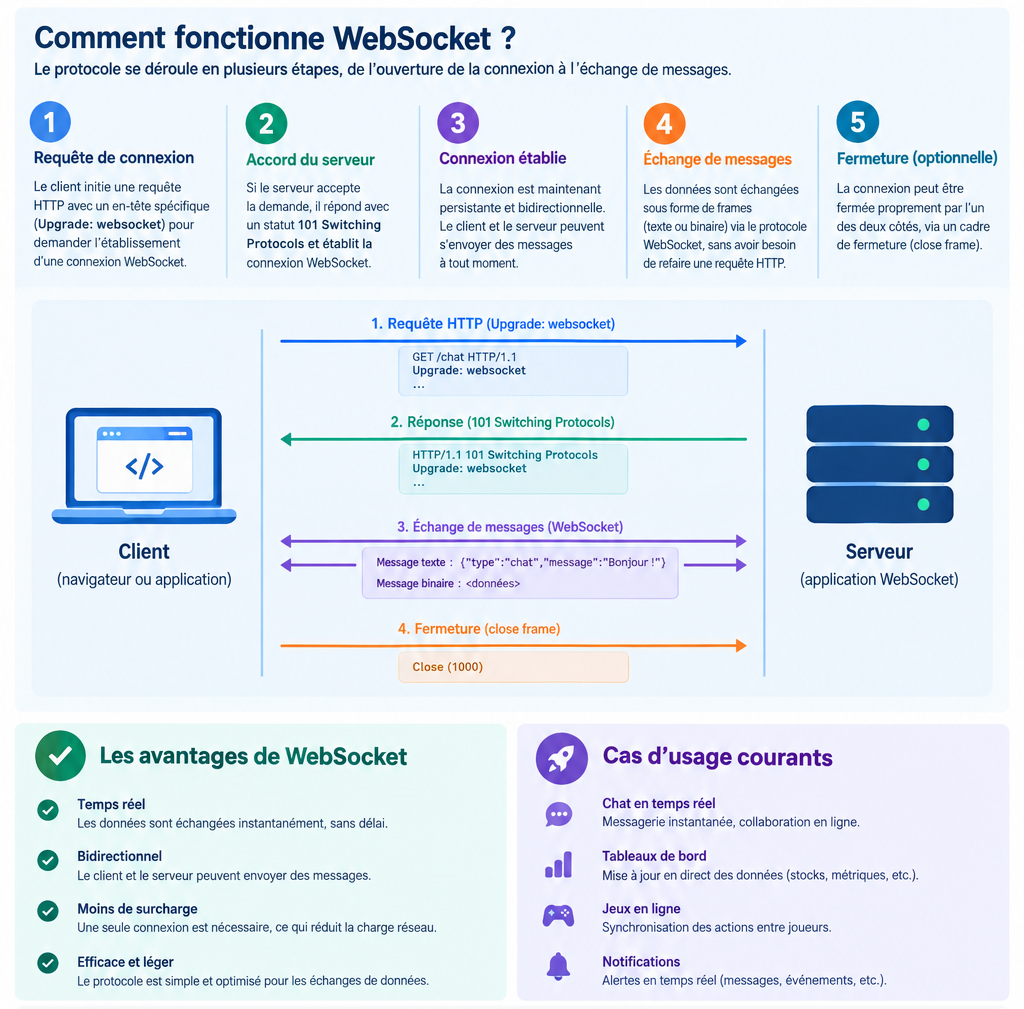
Une websocket est un protocole de communication qui permet d’établir une connexion permanente et bidirectionnelle entre un client (généralement un navigateur) et un serveur. Elle est normalisée par l’IETF sous la référence RFC 6455 et fonctionne au-dessus de TCP.

Contrairement au modèle classique du web, où le client envoie une requête et le serveur répond puis ferme la connexion, la websocket maintient un canal ouvert dans les deux sens. Une fois la connexion établie, le client et le serveur peuvent s’envoyer des données à tout moment, sans attendre une nouvelle requête.

Comment la connexion s’établit

La websocket démarre par une requête HTTP classique contenant un en-tête spécifique, Upgrade: websocket. Si le serveur accepte, il répond avec un code 101 (Switching Protocols). À partir de ce moment, la connexion HTTP est transformée en connexion websocket, et les échanges suivent un format de trames propre à ce protocole.

Ce mécanisme de poignée de main permet de réutiliser l’infrastructure existante du web : ports 80 et 443, proxys, TLS. Une websocket peut donc fonctionner en ws:// ou en wss:// pour la version chiffrée.

Continuer la lecture →

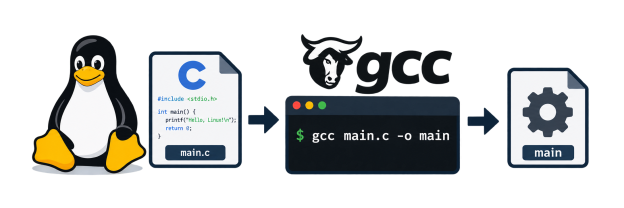
Tutoriel Linux : compiler le langage C

Le langage C est incontournable en environnement Linux, et pas seulement parce que le noyau Linux lui-même est programmé à 99% en C.

En effet, tous les binaires exécutables présents sur un système Linux, quel que soit le langage dans lequel ils sont développés, utilisent la librairie C, qui est le point de passage obligé pour s’interfacer avec les appels systèmes offerts par le noyau. Beaucoup de ces langages sont en réalité traduits en C avant d’être compilés (ce qui est assez cocasse), d’autres comme Python sont interprétés par un interpréteur écrit en C.

Comme nous l’avons déjà vu, les appels systèmes réellement offerts par le noyau (les vrais) sont différents des appels système offerts par la librairie C (souvent appelée libc pour faire court). Les (faux) appels système de la libc sont les seuls à être standardisés par la norme POSIX, qui définit les appels systèmes à implémenter dans un système Unix. La libc est parfaitement conforme (et offre même des appels système en plus) à la norme POSIX. Ne laissez donc jamais un incompétent vous affirmer que Linux n’est pas un Unix.

Le langage C est un langage merveilleux, très simple à apprendre (c’est ce qui a fait son succès), avec lequel on peut absolument TOUT programmer (même des applications web). C’est LE langage par excellence, celui qui, quand on le maîtrise, fait qu’on n’a plus besoin de s’intéresser aux autres langages de programmation.

Tout simple qu’il soit, il n’est pas question dans cet article d’apprendre la programmation C. Le lecteur se référera pour cela à un livre dédié comme celui-ci :

Ou mieux, le Kernighan et Ritchie original, écrit par les deux créateurs du langage C, que tout afficionado de Linux se doit d’avoir dans sa bibliothèque :

Continuer la lecture →