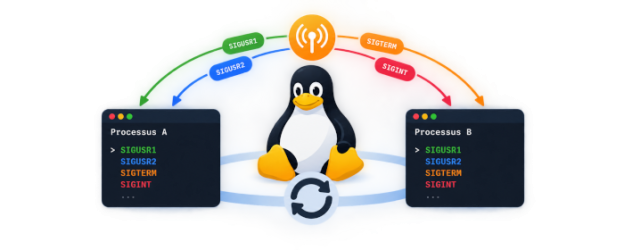
Les signaux sous Linux sont un mécanisme de communication inter-processus utilisé par le noyau pour notifier un processus qu’un événement s’est produit. Nous avons déjà consacré une introduction aux signaux dans l’épisode 5.
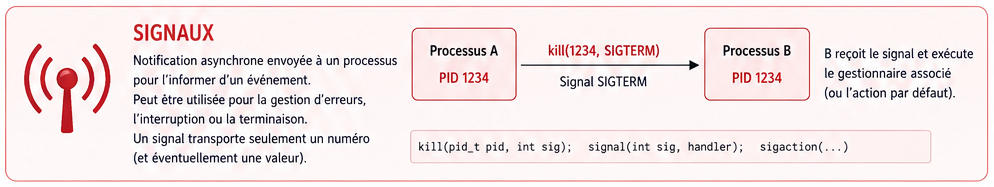
Contrairement aux appels système classiques, ils sont asynchrones : un processus peut recevoir un signal à n’importe quel moment, ce qui interrompt temporairement son exécution normale.
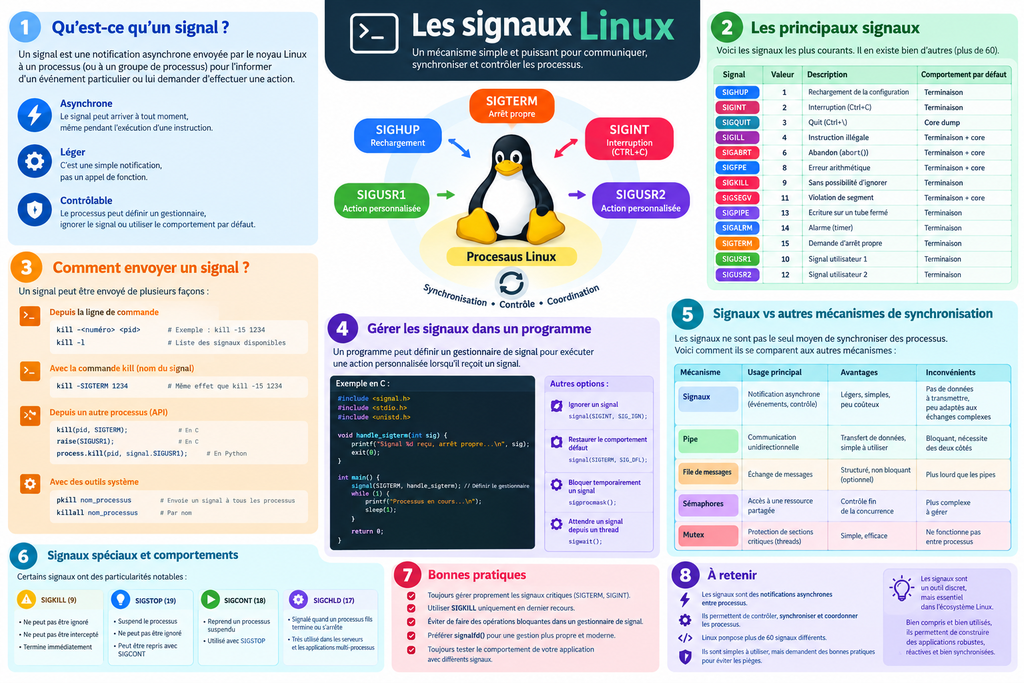
Chaque signal possède un numéro et un nom symbolique défini dans le fichier d’en-tête signal.h. Les signaux standard vont de 1 à 31, tandis que les signaux temps réel, plus nombreux, occupent généralement les numéros 32 à 64.
Un signal peut être envoyé par le noyau lui-même, par un autre processus via l’appel système kill, ou par le processus lui-même avec raise.
#include <signal.h>

int kill(pid_t pid, int sig); // pid = numéro du processus à atteindre, sig numéro du signal à lui envoyer
int raise(int sig); // équivalent à kill(getpid(),sig);
L’utilitaire en ligne de commande kill permet également d’envoyer un signal à un processus identifié par son PID, et pkill ou killall le font par nom.
Chaque signal a une action par défaut. Pour la plupart, cette action est de terminer le processus. Certains signaux comme SIGSEGV ou SIGFPE indiquent une erreur matérielle ou logicielle grave.
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.
Dans l’épisode 5 nous avons vu les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.
Dans l’épisode 6 nous nous sommes amusés avec les principaux appels système que le noyau met à disposition des processus.
Dans cet épisode 7 nous allons faire de même avec les appels système que mis à disposition des programmeurs pour manipuler les fichiers.
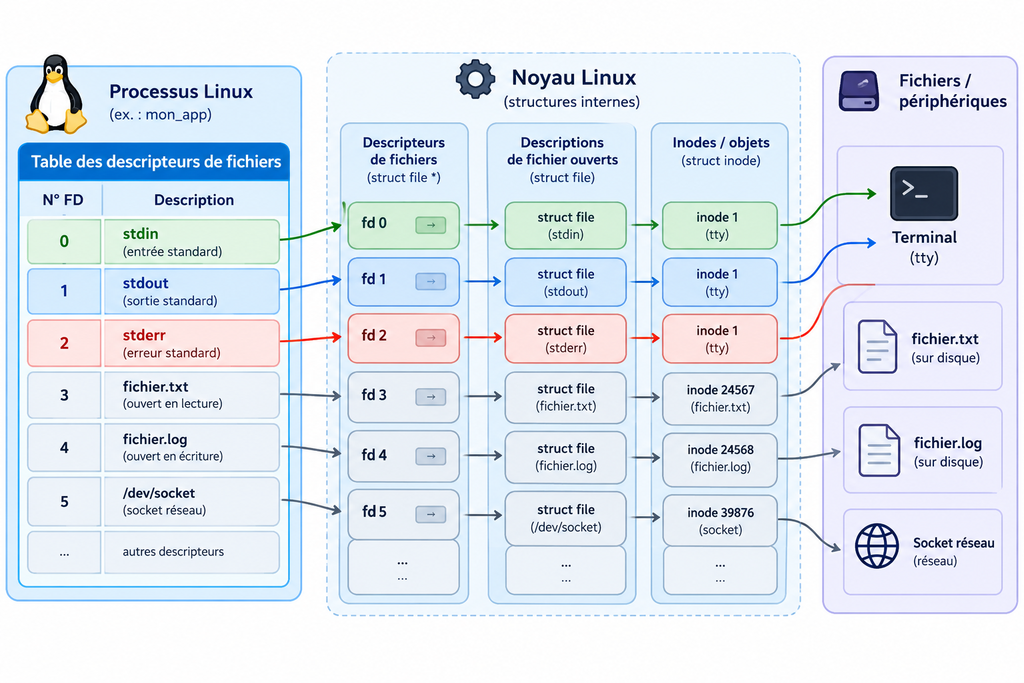
Commençons par planter le décor : chaque processus Linux comporte une table des descripteurs de fichiers, dont la taille est indiquée dans les sources du noyau avant compilation de celui-ci. On ne peut donc pas la changer sans recompiler le noyau.
Dans cette table, chaque entrée comporte un numéro et pointe, si la ligne a été ouverte, vers un fichier précis via un parcours dans les arcanes du noyau Linux. Comme tout est fichier sous Unix, ce parcours dans les arcanes prend différents chemins selon que le fichier ouvert soit un fichier sur disque, une socket réseau, un périphérique, etc.
Dans cette table, 3 entrées ont une utilisation particulière.
La première est l’entrée de numéro 0, qu’on appelle l’entrée standard (stdin en anglais). C’est l’entrée par défaut sur laquelle le processus lit les données qu’un autre processus lui envoie via un pipe par exemple.
La deuxième est l’entrée de numéro 1, qu’on appelle la sortie standard (stdout en anglais). C’est la sortie par défaut sur laquelle le processus écrit (lorsqu’on fait un printf par exemple).
La troisième est l’entrée de numéro 2, qu’on appelle l’erreur standard (stderr en anglais). Elle est prévue pour que le processus puisse communiquer au reste du monde (qui devra se brancher en lecture sur cette sortie) ses messages d’erreur.
Toutes les autres entrées de la table des descripteurs de fichiers sont lambda. A noter que l’état exact de cette table est transmis à l’identique aux processus fils dès lors qu’on les crée avec l’appel système fork() déjà vu dans l’épisode 6.
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.
Dans l’épisode 5 nous avons vu les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.
Il est temps de commencer les travaux pratiques. Dans cet épisode 6 nous allons nous amuser avec certains des appels système que le noyau met à disposition des processus.
Dans le programme prog.c ci-dessous, que nous allons utiliser pour ce TP, nous allons utiliser les appels système suivants :
getpid() qui permet à un processus de demander au noyau de lui communiquer son PID (process ID)
getppid() qui permet à un processus de demander au noyau de lui communiquer son PPID, c’est à dire le PID de son processus père (on rappelle que les processus sont rangés sous forme d’arbre, rangés sous le processus de PID 1 qui est soit init historiquement, soit systemd sur les systèmes Linux qui ont succombé à cette mode).
getuid() qui permet à un processus de demander au noyau de lui communiquer son UID, c’est à dire l’ID de l’utilisateur qui a lancé et à qui appartient le processus.
getgid() qui permet à un processus de demander au noyau de lui communiquer son GID, c’est à dire l’ID du groupe qui a lancé et à qui appartient le processus.
geteuid() qui permet à un processus de demander au noyau de lui communiquer son EUID, c’est à dire l’ID effectif de l’utilisateur qui a lancé et à qui appartient le processus. Si le programme lancé a le bit s positionné et appartient à root, alors le EUID vaut 0. Pareil si le programme a été lancé avec sudo.
getegid(), comme geteuid() mais pour le groupe effectif.
setuid() et setgid(), qui permettent au processus de demander au noyau de modifier l’UID et le GID du processus. Bien sûr le noyau ne s’exécute que si l’UID appelant est 0 c’est à dire root.
fork() qui permet de demander au noyau de créer un processus fils identique au processus appelant dans tous les détails, sauf sur le code de retour de l’appel système fork() qui vaut 0 dans le fils créé et le PID du fils créé dans le code de retour disponible pour le processus père. fork() est, avec exec, l’un des appels système les plus fondamentaux sous Unix.
execl() qui permet à un processus de demander au noyau de faire une commutation d’image, c’est à dire d’écraser le code en mémoire du processus appelant par celui d’un programme présent dans le système de fichiers. execl est l’un des nombreux appels système de la famille des exec.
exit() qui permet à un processus de demander au noyau de le tuer, et de transmettre un code de sortie jusqu’au processus père, pour l’informer par exemple du résultat de l’exécution du processus fils.
wait() qui permet à un processus de demander au noyau de le mettre en attente de la mort d’un processus fils et lui permettre de lire le code de retour envoyé par le processus fils à sa mort.
Notre programme utilise aussi la fonction sleep(), qui n’est pas à proprement parler un appel système car appartenant à la section 3 du manuel (man 3 sleep) et non à la section 2. Cette fonction est bien utile pour ralentir l’exécution pour qu’on voit ce qui se passe. sleep(n) permet au processus d’être mis en sommeil pendant n secondes. Il utilise aussi la fonction getenv() qui permet de lire le contenu d’une variable d’environnement (qu’on peut modifier par setenv() qui ne sera pas utilisé ici).
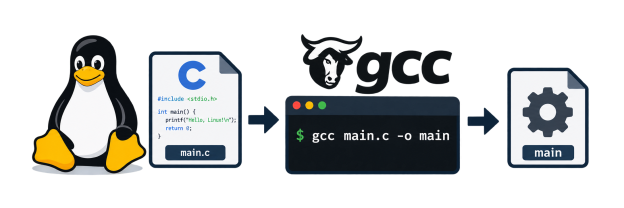
Le langage C est incontournable en environnement Linux, et pas seulement parce que le noyau Linux lui-même est programmé à 99% en C.
En effet, tous les binaires exécutables présents sur un système Linux, quel que soit le langage dans lequel ils sont développés, utilisent la librairie C, qui est le point de passage obligé pour s’interfacer avec les appels systèmes offerts par le noyau. Beaucoup de ces langages sont en réalité traduits en C avant d’être compilés (ce qui est assez cocasse), d’autres comme Python sont interprétés par un interpréteur écrit en C.
Comme nous l’avons déjà vu, les appels systèmes réellement offerts par le noyau (les vrais) sont différents des appels système offerts par la librairie C (souvent appelée libc pour faire court). Les (faux) appels système de la libc sont les seuls à être standardisés par la norme POSIX, qui définit les appels systèmes à implémenter dans un système Unix. La libc est parfaitement conforme (et offre même des appels système en plus) à la norme POSIX. Ne laissez donc jamais un incompétent vous affirmer que Linux n’est pas un Unix.
Le langage C est un langage merveilleux, très simple à apprendre (c’est ce qui a fait son succès), avec lequel on peut absolument TOUT programmer (même des applications web). C’est LE langage par excellence, celui qui, quand on le maîtrise, fait qu’on n’a plus besoin de s’intéresser aux autres langages de programmation.
Tout simple qu’il soit, il n’est pas question dans cet article d’apprendre la programmation C. Le lecteur se référera pour cela à un livre dédié comme celui-ci :
Ou mieux, le Kernighan et Ritchie original, écrit par les deux créateurs du langage C, que tout afficionado de Linux se doit d’avoir dans sa bibliothèque :
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.
Dans cet épisode 5 nous allons voir les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.
Rappelons que ces mécanismes sont indispensables car, comme nous l’avons vu dans l’épisode 2 consacré à la gestion de la mémoire, les processus vivent en mémoire virtuelle paginée utilisateur ce qui rend leur espace mémoire complètement étanche avec celui des autres processus.
Sans mécanisme particulier additionnel, la communication inter-processus ne serait tout simplement pas possible par construction.
Le noyau Linux, comme tous les Unices (pluriel d’Unix), offre 2 mécanismes de synchronisation (signaux et sémaphores) et 5 mécanismes d’échange de données (segments de mémoire partagée, files de messages, pipes, pipes nommés, et sockets Unix). Nous allons balayer le fonctionnement de ces mécanismes, dont nous étudierons l’utilisation dans des programmes en langage C dans des articles ultérieurs.
Les signaux
Les signaux sont un mécanisme de communication inter-processus qui permet d’envoyer des notifications asynchrones à un processus pour l’informer qu’un événement s’est produit. On peut les voir comme des « interruptions logicielles » qui permettent au noyau, à un autre processus ou à un utilisateur de contrôler et d’interagir avec un programme en cours d’exécution.
Un signal peut être généré par :
L’utilisateur : Par des combinaisons de touches comme Ctrl+C par exemple.
Le noyau : Pour signaler une erreur matérielle ou logicielle (par exemple, une division par zéro ou un accès mémoire invalide).
Un autre processus : Via des commandes shell comme kill ou des appels système.
Lorsqu’un signal est envoyé à un processus (en indiquant son PID), celui-ci peut y réagir de quatre manières différentes :
Exécuter l’action par défaut : Souvent, cela termine le processus. Parfois, le signal est ignoré.
Ignorer le signal : Le processus ne fait rien et continue son exécution.
Intercepter le signal (avec un gestionnaire, ou callback) : Le processus exécute une fonction personnalisée pour traiter l’événement.
Bloquer le signal : Le signal est mis en attente et ne sera délivré que lorsque le processus le débloquera.
Chaque signal est connu par un nom (SIGKILL, SIGSTOP, etc.) ou par son numéro.
Les signaux SIGKILL (signal qui porte le numéro 9) et SIGSTOP (qui porte les numéros 19, ou 23) sont des exceptions. Ils ne peuvent ni être interceptés, ni ignorés, ni bloqués. Cela garantit que l’utilisateur ou l’administrateur peut toujours stopper un processus, même s’il est défaillant.
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. Et l’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques.
Dans cet épisode 4 nous allons voir comment le noyau Linux offre aux applications un service d’appels système.
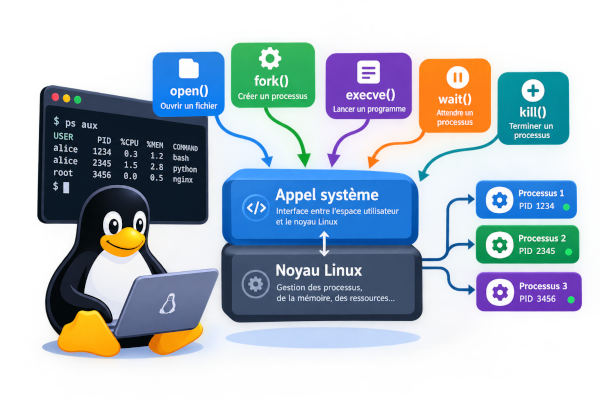
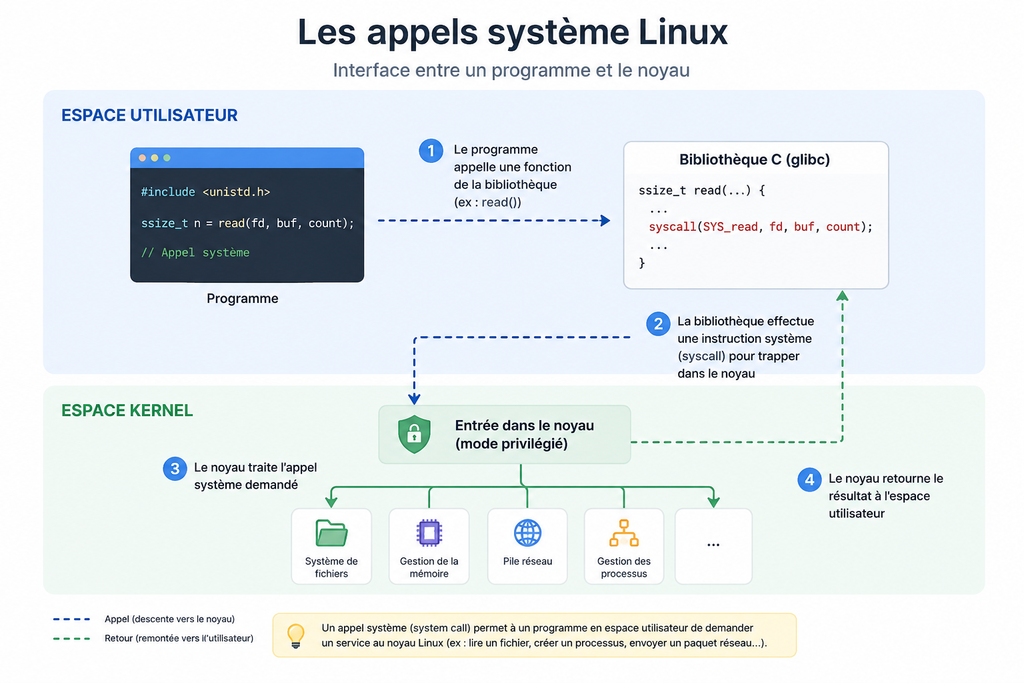
La notion même d’appels système est intimement liée au fait que le noyau est installé dans une zone mémoire à hauts privilèges (qu’on appelle par commodité l’espace noyau), alors que les applications tournent dans le reste de la mémoire, sans privilèges particuliers (qu’on appelle par commodité l’espace utilisateur). De facto, le noyau est le seul programme ayant accès au matériel.
Comme les applications ont besoin d’accéder au matériel (pour détecter un clic de souris sur un bouton par exemple, et déclencher le traitement associé), et que le noyau est le seul à avoir l’accès au matériel, de facto on n’y coupe pas : il faut impérativement que le noyau propose aux applications un service d’accès au matériel en passant par lui. Ce service ce sont les appels système.
Le noyau Linux propose un nombre variable d’appels système en fonction de l’architecture cible. Néanmoins, il y a en moyenne un peu plus de 300 appels système implémentés, couvrant tous les besoins possibles des applications : accéder aux fichiers, aux périphériques, aux couches réseaux, à la gestion des processus, etc.
Vous avez un PC portable tout neuf, vous avez installé Ubuntu dessus, tout va bien. Sauf qu’au bout de 2 ou 3 ans vous observez que l’autonomie de votre batterie interne à chuté de 50% !
Vous êtes bon pour avoir à changer la batterie.
Sans le savoir vous avez commis une erreur de débutant : vous n’avez pas installé tlp.
La solution : tlp
Sous Ubuntu, la gestion de la batterie d’un ordinateur portable est assurée par défaut par un service appelé power-profiles-daemon. Il permet de choisir entre trois profils de consommation (« Performance », « Équilibré », « Économie d’énergie ») via l’interface GNOME.
Ce service remplit correctement sa mission : ajuster la consommation électrique en fonction des besoins immédiats de l’utilisateur.
Il ne remplit en revanche pas une autre mission, pourtant essentielle à la longévité du matériel : la préservation de la capacité de la batterie dans le temps. C’est là qu’intervient tlp.
Ce qui se passe sans tlp
Lorsque vous installez Ubuntu et que vous utilisez votre ordinateur portable sans tlp voici ce qui se produit :
1. La batterie est systématiquement chargée à 100 %
Chaque fois que vous branchez votre PC, il se recharge jusqu’à 100 %. C’est le comportement standard de tous les systèmes d’exploitation grand public. Or, maintenir une batterie lithium-ion à 100 % de charge, surtout lorsqu’elle est branchée en permanence, accélère sa dégradation chimique.
2. Une usure prématurée des cellules
Après quelques centaines de cycles de charge, la capacité maximale de la batterie diminue. Ce phénomène est irréversible : les cellules lithium-ion perdent progressivement leur capacité à stocker de l’énergie.
3. Une autonomie réduite
Après 400 à 500 cycles, une batterie ayant toujours été chargée à 100 % peut avoir perdu 30 à 45 % de sa capacité d’origine. L’autonomie chute donc mécaniquement.
4. Un remplacement inévitable
À partir de 60 % de capacité restante, l’autonomie devient insuffisante pour un usage nomade confortable. Le remplacement de la batterie est alors la seule solution.
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux, ainsi que ce que celui-ci réalise en matière de gestion de processus, et dans l’épisode 2 ce qu’il réalise en termes de gestion mémoire.
Pour continuer notre exploration des fonctionnalités du noyau, nous allons, dans cet épisode, aborder la gestion des périphériques.
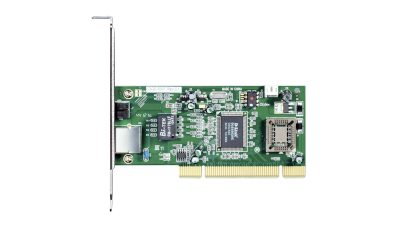
Sur un PC les périphériques sont nombreux : clavier, souris, écran, carte graphique, carte réseau, clé USB, disque dur, SSD, etc.
Dans le monde Windows, les périphériques ont été historiquement livrés par leur constructeur accompagnés par le pilote de périphérique adapté à Windows. Pendant des décennies les constructeurs n’ont pas daigné fournir les pilotes de périphériques (drivers) adaptés à Linux. Les programmeurs du noyau Linux ont donc dû s’adapter en les développant eux-mêmes.
Une technique qui a beaucoup été utilisée est la retro-ingénierie, qui consiste à décortiquer le driver pour Windows jusqu’à ce qu’on ait compris ce qu’il fait et comment il fonctionne.
Dans les années 90, lorsque les programmeurs du noyau étaient encore peu nombreux (l’époque où le contributeur numéro deux après Linus Torvalds était le légendaire Alan Cox), il n’y avait généralement presqu’une seule personne derrière chaque famille de drivers.
Alan Cox, la légende
A cette époque, les drivers pour les cartes réseau Ethernet étaient par exemple pratiquement tous codés par un programmeur de la NASA (dont j’ai oublié le nom, on pourrait le retrouver en allant farfouiller dans le code source Linux de ces drivers).
Le monde Linux a donc appris au fil des décennies à coder seul ses drivers. Le noyau est donc devenu de facto très bon pour auto-détecter le matériel.
Jusqu’à la version 0.99.14 du noyau Linux, les drivers étaient en dur dans le noyau. C’était une époque où les utilisateurs de Linux compilaient eux-mêmes un noyau aux petits oignons pour leur machine. Lors de la configuration pré-compilation, on indiquait quels drivers on voulait, et le noyau était ensuite compilé avec ces drivers. Quand on bootait dessus, on avait le support des périphériques dont on avait retenu le driver dans le noyau. Cette action était assez sportive car le driver n’était pas lié à un modèle commercial de périphérique, mais généralement à la puce électronique située au cœur de ce périphérique. Il n’était donc pas rare de devoir consulter Windows pour savoir quelle puce Windows disait détecter.
A partir de la version 0.99.15 du noyau Linux en 1994, celui-ci s’est vu ajouter la fonction de modules chargeables. On pouvait désormais monter ou démonter dynamiquement un driver dans le noyau, ce qui fut une avancée notable.
Au cours des années 2000, des distributions comme Ubuntu ont poussé très loin les mécanismes d’auto-détection du matériel, ces mécanismes se terminant par la montée dynamique du bon driver dans le noyau.
Entre temps, pour la petite histoire, Windows s’est inspiré de Linux en ayant de moins en moins la nécessité d’utiliser des drivers externes fournis par les constructeurs. Les drivers sont intégrés dans le code du noyau Windows.
La gestion des périphériques dans le noyau Linux
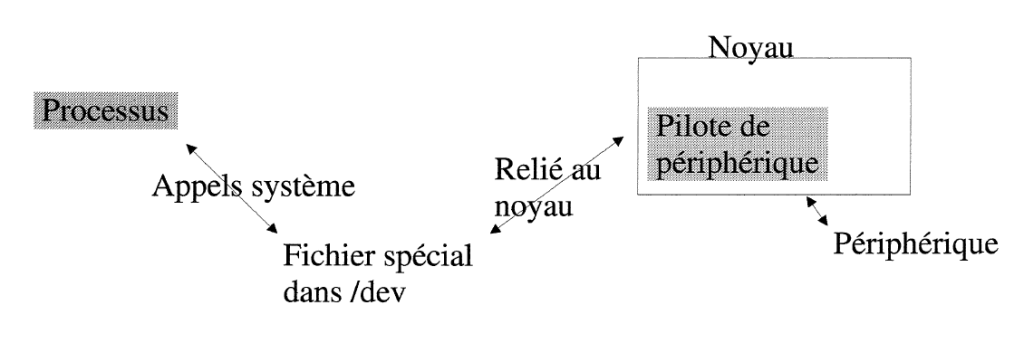
Les périphériques étant du matériel, seul le noyau a les droits pour y accéder. Ces accès se font par des pilotes de périphériques en dur dans le noyau ou montés sous forme de modules comme nous l’avons vu (commande lsmod pour voir quels modules sont montés, insmod pour monter un module, rmmod pour descendre un module).
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux, ainsi que ce qu’il réalise en matière de gestion de processus.
Dans l’épisode 2 nous allons voir comment le noyau gère la mémoire.
La mémoire dont nous parlons ici est la mémoire RAM physique installée sur l’ordinateur.
Nous avons vu dans l’épisode 1 que, lors du boot de l’ordinateur, le noyau est le premier programme monté en mémoire, et qu’il se verrouille dans une zone de haut privilège.
Le reste de la mémoire physique présente sur la machine est donc disponible pour que le noyau y fasse tourner des processus et y conserve des caches.
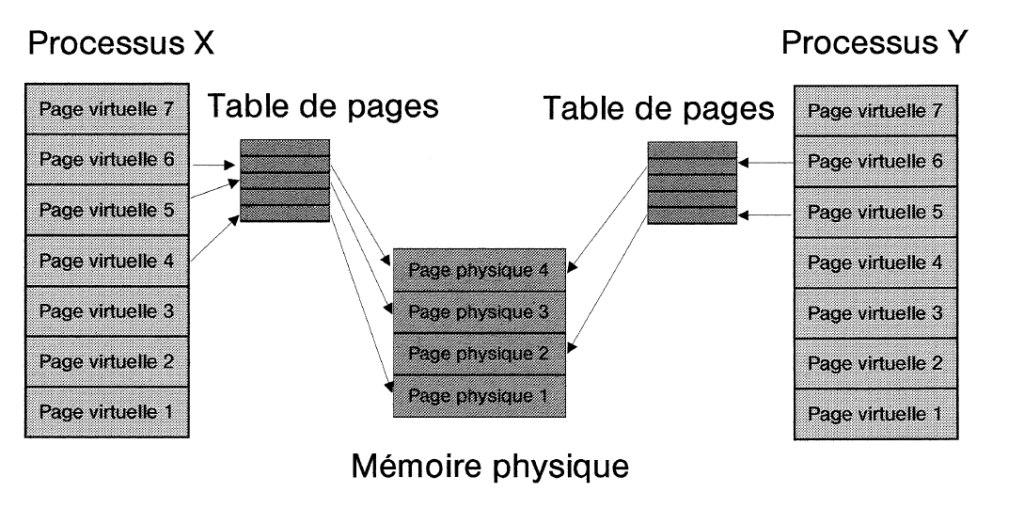
Pour faire tourner ces processus, la mémoire physique sera utilisée sous forme de mémoire virtuelle à base de pages.
Une page fait 4 Ko car c’est la taille standard pour la majorité des micro-processeurs, un bon compromis entre la gestion de la mémoire et les performances.
Pages physiques et pages virtuelles
La figure ci-dessus montre ce qui se passe réellement dans la machine.
La tâche la plus difficile qu’on puisse concevoir en informatique est d’écrire un noyau de système d’exploitation. Seuls les développeurs les plus talentueux peuvent se lancer dans une telle tâche. Nous allons découvrir pourquoi en étudiant de plus près les fonctionnalités assurées par le noyau Linux, qui assure les fonctions d’un noyau Unix classique.
Le noyau Linux a été développé depuis 1991, initialement par un jeune informaticien finlandais nommé Linus Torvalds, puis au fil des années qui ont suivi avec la contribution de dizaines de milliers de développeurs dans le monde. Au fil des années, le noyau Linux est devenu ni plus ni moins que le plus grand projet collaboratif de l’histoire de l’humanité. La taille du code source du noyau Linux est réputée dépasser aujourd’hui plus de 40 millions de lignes de code : principalement du C, un peu d’assembleur, et une dynamique naissante pour y introduire du Rust.
Pour comprendre les fonctions qu’assure ce noyau, commençons par les aspects architecturaux de base.
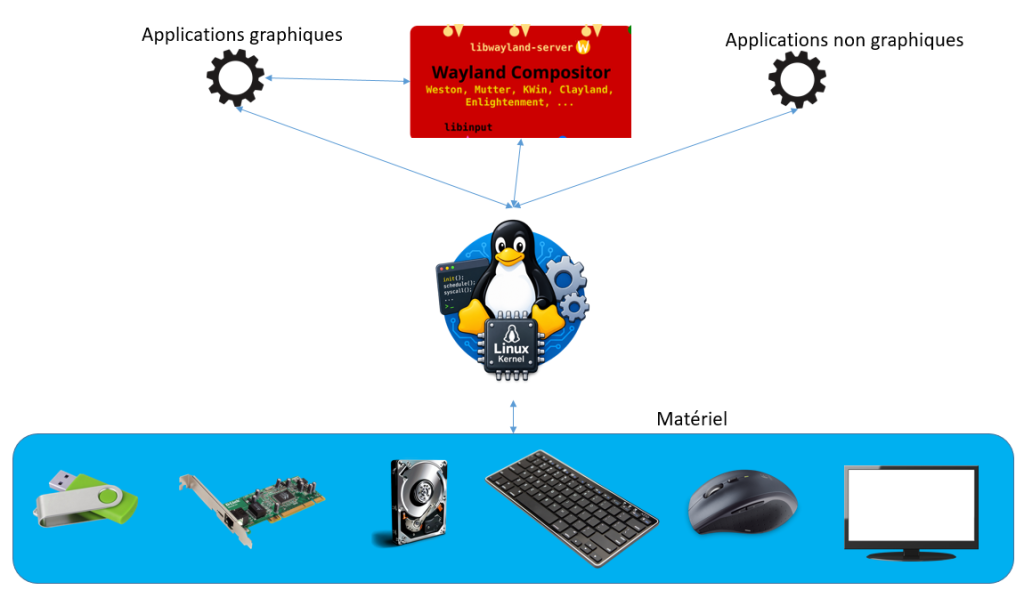
La figure ci-dessus présente ce qui se passe sur une machine Linux allumée. La partie basse représente le matériel physique de la machine (clés USB, disques durs, cartes réseaux, clavier, souris, écran, etc.).
La partie milieu représente le noyau Linux. Seul ce noyau peut accéder au matériel, que ce soit en lecture ou en écriture.
La partie haute représente les applications qui tournent sur la machine (Firefox, etc.). Les applications ne peuvent en aucun cas accéder directement au matériel, elles ne peuvent que demander au noyau de le faire. Pour recueillir ces demandes, le noyau met à disposition des applications des appels systèmes, qui peuvent être appelés par les applications.
Parmi les applications, une a une importance particulière : le gestionnaire d’interface graphique. Historiquement les systèmes Unix, dont Linux, fonctionnaient avec un gestionnaire d’interface graphique appelé X-Window. X-Window avait des qualités : il était notamment nativement réseau, c’est-à-dire qu’une application lancée sur une machine A pouvait demander à apparaitre à l’écran d’une machine B. Pour cela il y avait une simple variable d’environnement à changer pour que le routage des fenêtres soit différent (on tapait par exemple export DISPLAY=machine_B :0 et l’application tournait sur la machine A mais ses fenêtres apparaissaient sur la machine B. C’était une époque très cool, on pouvait faire des plaisanteries envoyées sur les machines des copains). Mais X-Window avait aussi des défauts (parait-il), notamment de sécurité.
Sur les systèmes Linux modernes, Xfree86 (l’implémentation libre de X-Window) a donc été remplacé par Wayland, qui a les qualités et défauts inverses. Il n’a plus de problème de sécurité, il est probablement plus performant, mais il n’est plus réseau comme l’était X-Window.
Bref, quoi qu’il en soit, que l’on utilise X-Window ou Wayland, il y a toujours besoin de cette application un peu spéciale qu’est le gestionnaire d’interface graphique. Cette application gère les fenêtres graphiques et donc propose des primitives appelables par des environnements de bureau comme Gnome ou KDE, ou directement par vos applications graphiques si vous en programmez vous-même.