Archives par étiquette : Linux

Fonctionnalités du noyau Linux (Episode 8) – Travaux pratiques sur les appels système dédiés à la synchronisation des processus par signaux

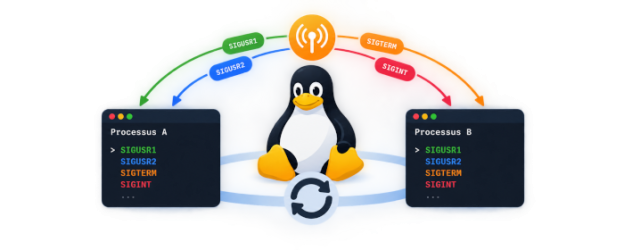
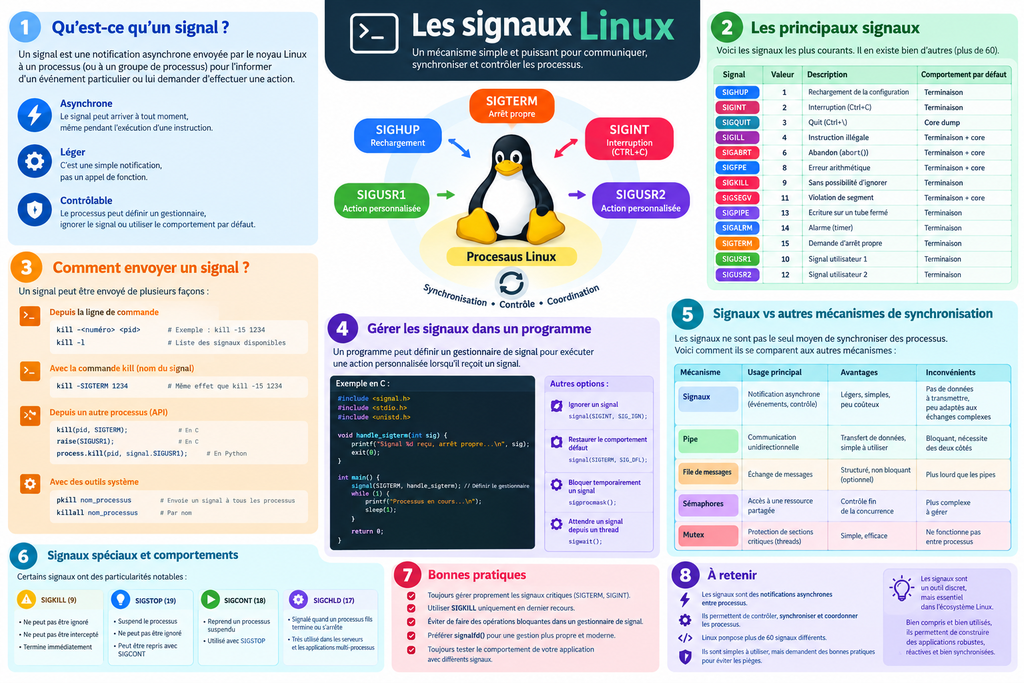
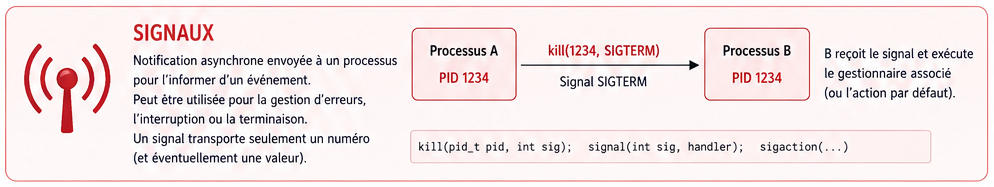
Les signaux sous Linux sont un mécanisme de communication inter-processus utilisé par le noyau pour notifier un processus qu’un événement s’est produit. Nous avons déjà consacré une introduction aux signaux dans l’épisode 5.

Contrairement aux appels système classiques, ils sont asynchrones : un processus peut recevoir un signal à n’importe quel moment, ce qui interrompt temporairement son exécution normale.

Chaque signal possède un numéro et un nom symbolique défini dans le fichier d’en-tête signal.h. Les signaux standard vont de 1 à 31, tandis que les signaux temps réel, plus nombreux, occupent généralement les numéros 32 à 64.

Un signal peut être envoyé par le noyau lui-même, par un autre processus via l’appel système kill, ou par le processus lui-même avec raise.

#include <signal.h>

int kill(pid_t pid, int sig); // pid = numéro du processus à atteindre, sig numéro du signal à lui envoyer
int raise(int sig); // équivalent à kill(getpid(),sig);

L’utilitaire en ligne de commande kill permet également d’envoyer un signal à un processus identifié par son PID, et pkill ou killall le font par nom.

Chaque signal a une action par défaut. Pour la plupart, cette action est de terminer le processus. Certains signaux comme SIGSEGV ou SIGFPE indiquent une erreur matérielle ou logicielle grave.

Continuer la lecture

Fonctionnalités du noyau Linux (Episode 7) – Travaux pratiques sur les appels système dédiés à la gestion des fichiers

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.

Dans l’épisode 5 nous avons vu les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.

Dans l’épisode 6 nous nous sommes amusés avec les principaux appels système que le noyau met à disposition des processus.

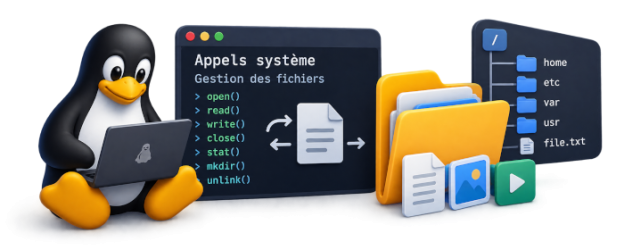
Dans cet épisode 7 nous allons faire de même avec les appels système que mis à disposition des programmeurs pour manipuler les fichiers.

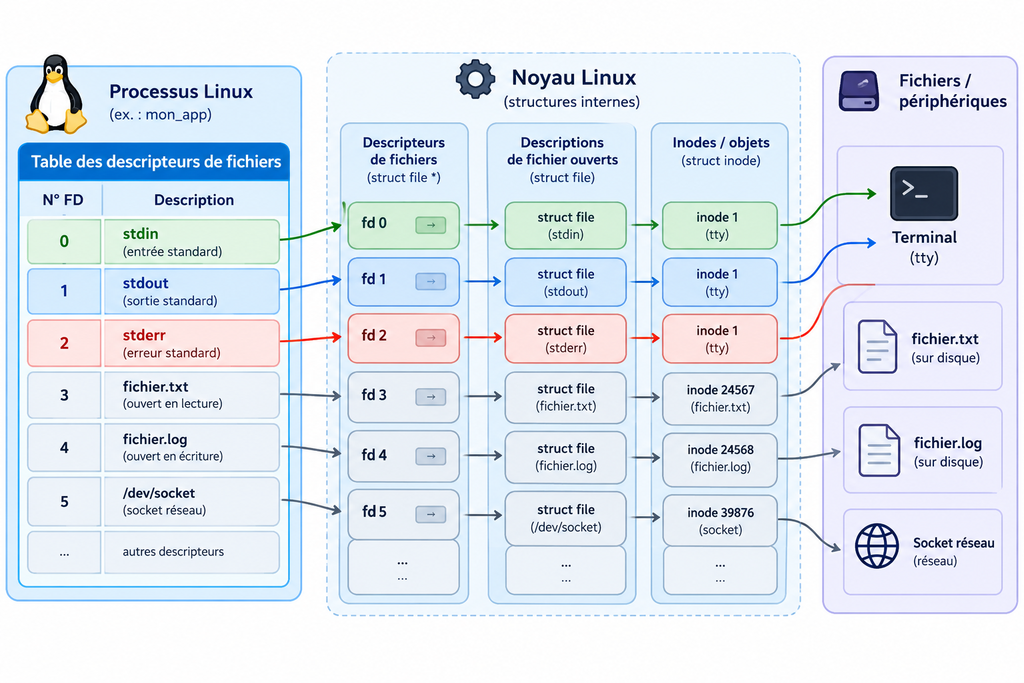
Commençons par planter le décor : chaque processus Linux comporte une table des descripteurs de fichiers, dont la taille est indiquée dans les sources du noyau avant compilation de celui-ci. On ne peut donc pas la changer sans recompiler le noyau.

Dans cette table, chaque entrée comporte un numéro et pointe, si la ligne a été ouverte, vers un fichier précis via un parcours dans les arcanes du noyau Linux. Comme tout est fichier sous Unix, ce parcours dans les arcanes prend différents chemins selon que le fichier ouvert soit un fichier sur disque, une socket réseau, un périphérique, etc.

Dans cette table, 3 entrées ont une utilisation particulière.

La première est l’entrée de numéro 0, qu’on appelle l’entrée standard (stdin en anglais). C’est l’entrée par défaut sur laquelle le processus lit les données qu’un autre processus lui envoie via un pipe par exemple.

La deuxième est l’entrée de numéro 1, qu’on appelle la sortie standard (stdout en anglais). C’est la sortie par défaut sur laquelle le processus écrit (lorsqu’on fait un printf par exemple).

La troisième est l’entrée de numéro 2, qu’on appelle l’erreur standard (stderr en anglais). Elle est prévue pour que le processus puisse communiquer au reste du monde (qui devra se brancher en lecture sur cette sortie) ses messages d’erreur.

Toutes les autres entrées de la table des descripteurs de fichiers sont lambda. A noter que l’état exact de cette table est transmis à l’identique aux processus fils dès lors qu’on les crée avec l’appel système fork() déjà vu dans l’épisode 6.

Continuer la lecture

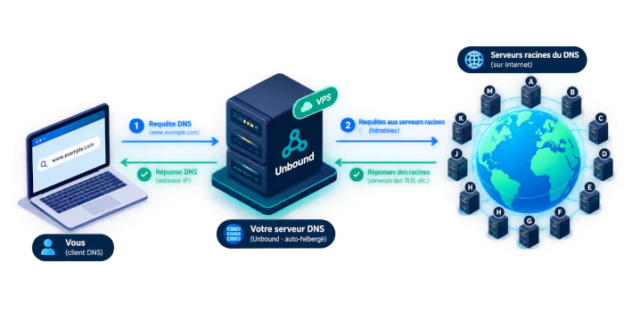
Tutoriel Linux : Installer un serveur DNS récursif sur son VPS avec Unbound

Le DNS (Domain Name System) est un service fondamental sur Internet, puisque c’est lui qui permet à notre ordinateur de joindre une machine dont on ne connait que le nom.

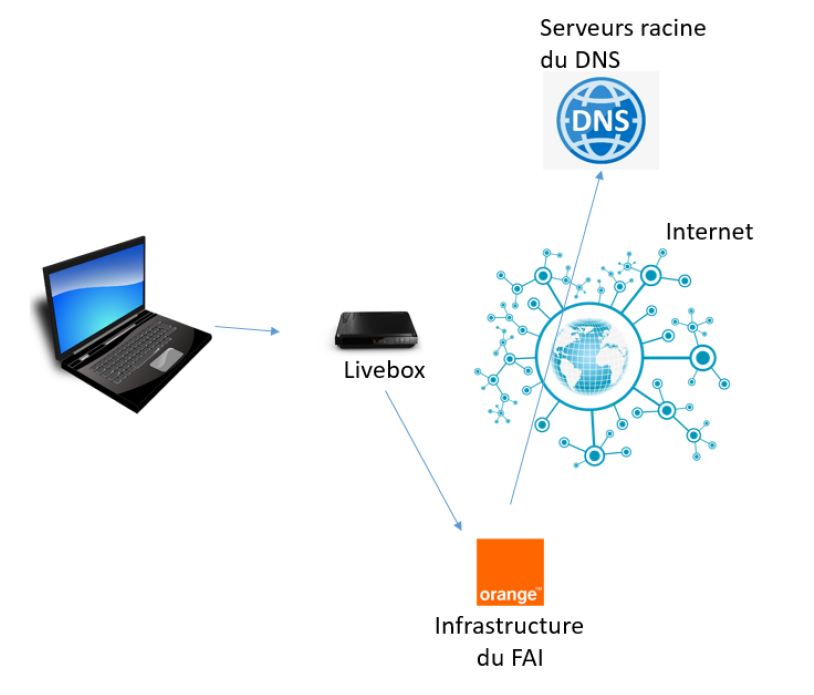
Dans une configuration typique, si l’on ne touche à aucun paramétrage particulier, le fait de taper par exemple https://cnn.com dans la barre d’URL du navigateur de notre laptop va entraîner la séquence suivante :

– Le laptop va faire une requête DNS (protocole UDP, port 53) à la Livebox (« Quelle est l’adresse IP de la machine cnn.com ? »)

– La Livebox (adresse IP 192.168.1.1 généralement) va répercuter cette demande à l’infrastructure du FAI (exemple d’Orange dans la figure ci-dessus)

– Soit l’infrastructure du FAI a déjà la réponse, parce qu’elle a déjà questionné les serveurs racines du DNS sur Internet, auquel cas elle répond. Soit elle n’a pas la réponse et elle questionne récursivement les serveurs DNS racine sur Internet, qui eux vont fournir la réponse

– La réponse (l’adresse IP de la machine cnn.com) fait le trajet en sens inverse jusqu’au laptop

– Le laptop ouvre une connexion avec la machine en utilisant l’adresse IP qu’elle a reçue en réponse.

Les serveurs racine du DNS sur Internet sont des serveurs qui sont les points d’entrée d’un système hiérarchique, c’est pourquoi on parle de récursivité. Concrètement, si l’on souhaite l’adresse IP de la machine toto.cnn.com, le serveur racine du domaine .com sera consulté en premier, puis le serveur du domaine cnn.com.

Bref, on utilise ainsi le DNS en permanence sans même s’en douter.

Cependant cette configuration pose problème. En effet, le FAI est régulièrement sommé par les autorités d’effacer certaines machines du DNS. Techniquement c’est facile à faire : si les autorités demandent d’effacer la machine cnn.com (exemple fictif), alors le FAI paramètre son architecture DNS pour renvoyer comme réponse 127.0.0.1 en IPv4, ::1 en IPv6, au lieu de la vraie adresse IP, quand une requête DNS demandant l’adresse IP de cette machine est reçue.

127.0.0.1 et ::1 sont des adresses IP locales, qui ne permettront pas au laptop demandeur d’en faire quoi que ce soit. La machine cnn.com est ainsi invisibilisée (mais elle est toujours là) d’Internet.

Continuer la lecture

Fonctionnalités du noyau Linux (Episode 6) – Travaux pratiques sur les appels système dédiés à la gestion des processus

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.

Dans l’épisode 5 nous avons vu les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.

Il est temps de commencer les travaux pratiques. Dans cet épisode 6 nous allons nous amuser avec certains des appels système que le noyau met à disposition des processus.

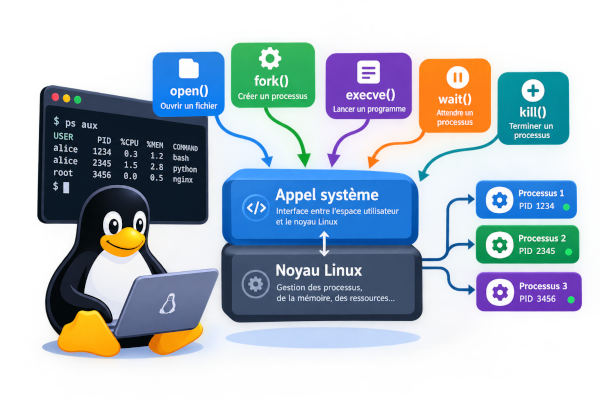
Dans le programme prog.c ci-dessous, que nous allons utiliser pour ce TP, nous allons utiliser les appels système suivants :

getpid() qui permet à un processus de demander au noyau de lui communiquer son PID (process ID)

getppid() qui permet à un processus de demander au noyau de lui communiquer son PPID, c’est à dire le PID de son processus père (on rappelle que les processus sont rangés sous forme d’arbre, rangés sous le processus de PID 1 qui est soit init historiquement, soit systemd sur les systèmes Linux qui ont succombé à cette mode).

getuid() qui permet à un processus de demander au noyau de lui communiquer son UID, c’est à dire l’ID de l’utilisateur qui a lancé et à qui appartient le processus.

getgid() qui permet à un processus de demander au noyau de lui communiquer son GID, c’est à dire l’ID du groupe qui a lancé et à qui appartient le processus.

geteuid() qui permet à un processus de demander au noyau de lui communiquer son EUID, c’est à dire l’ID effectif de l’utilisateur qui a lancé et à qui appartient le processus. Si le programme lancé a le bit s positionné et appartient à root, alors le EUID vaut 0. Pareil si le programme a été lancé avec sudo.

getegid(), comme geteuid() mais pour le groupe effectif.

setuid() et setgid(), qui permettent au processus de demander au noyau de modifier l’UID et le GID du processus. Bien sûr le noyau ne s’exécute que si l’UID appelant est 0 c’est à dire root.

fork() qui permet de demander au noyau de créer un processus fils identique au processus appelant dans tous les détails, sauf sur le code de retour de l’appel système fork() qui vaut 0 dans le fils créé et le PID du fils créé dans le code de retour disponible pour le processus père. fork() est, avec exec, l’un des appels système les plus fondamentaux sous Unix.

execl() qui permet à un processus de demander au noyau de faire une commutation d’image, c’est à dire d’écraser le code en mémoire du processus appelant par celui d’un programme présent dans le système de fichiers. execl est l’un des nombreux appels système de la famille des exec.

exit() qui permet à un processus de demander au noyau de le tuer, et de transmettre un code de sortie jusqu’au processus père, pour l’informer par exemple du résultat de l’exécution du processus fils.

wait() qui permet à un processus de demander au noyau de le mettre en attente de la mort d’un processus fils et lui permettre de lire le code de retour envoyé par le processus fils à sa mort.

Notre programme utilise aussi la fonction sleep(), qui n’est pas à proprement parler un appel système car appartenant à la section 3 du manuel (man 3 sleep) et non à la section 2. Cette fonction est bien utile pour ralentir l’exécution pour qu’on voit ce qui se passe. sleep(n) permet au processus d’être mis en sommeil pendant n secondes. Il utilise aussi la fonction getenv() qui permet de lire le contenu d’une variable d’environnement (qu’on peut modifier par setenv() qui ne sera pas utilisé ici).

Continuer la lecture

Tutoriel Linux : créer un réseau VPN Nebula

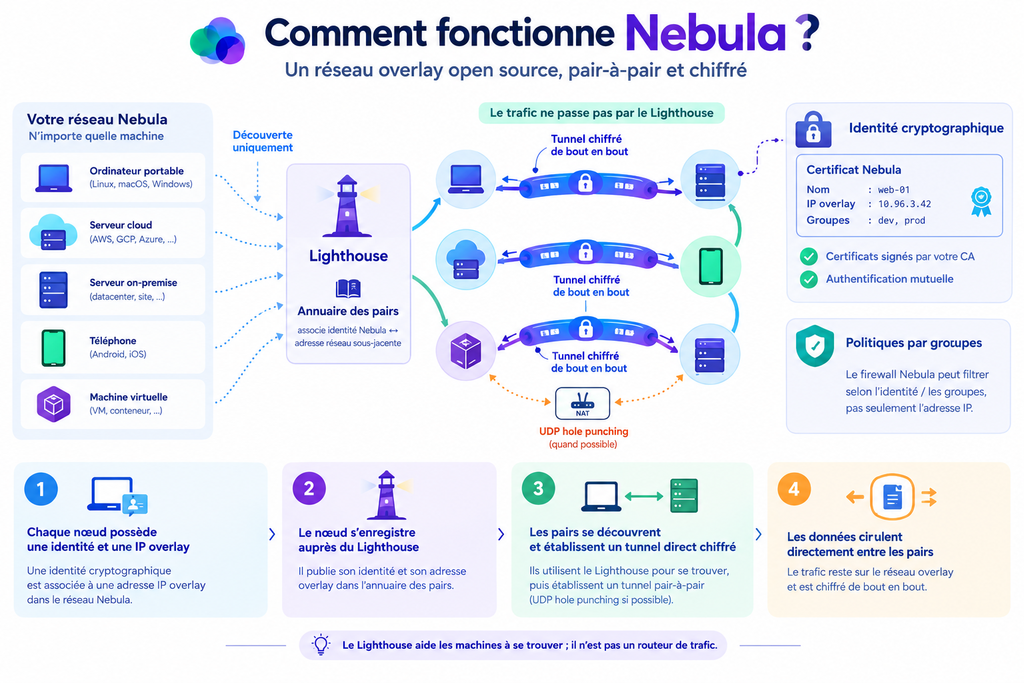
Nebula est né d’une difficulté d’ingénierie bien concrète. Vers la fin de 2016, le réseau de production de Slack connaissait une expansion rapide, et la solution IPSec utilisée alors pour relier les serveurs entre les régions commençait à montrer ses limites. Chaque paquet traversant les régions devait passer par un hôte tunnel IPSec, ajoutant un saut de latence sans contrepartie.

Plus problématique encore : à mesure que le réseau s’étendait sur plusieurs fournisseurs de cloud et des dizaines de sites, les « groupes de sécurité » propres à chaque fournisseur devenaient incompatibles entre eux, et les règles de pare-feu se réduisaient à une gestion grossière par plages d’adresses IP.

Nate Brown et Ryan Huber ont évalué toutes les solutions disponibles à l’époque. Aucune ne satisfaisait simultanément les exigences de Slack en matière de performance, d’échelle et de simplicité opérationnelle. Ils ont donc décidé de construire la leur. Le résultat de cette décision s’appelle Nebula, un système de réseau superposé qui, depuis le milieu de l’année 2017, porte l’essentiel du trafic réseau de Slack en interne, et qui n’a été basculé en open source qu’en novembre 2019.

Le principe de conception central de Nebula peut se résumer ainsi : intégrer l’identité numérique directement dans le tunnel chiffré, afin d’éliminer ce problème de distribution des clés qui empoisonne les architectures VPN traditionnelles. En effet, dans la plupart des réseaux superposés bâtis sur WireGuard, le chiffrement est assuré par WireGuard, mais la gestion des clés, l’authentification et le contrôle d’accès reposent sur un système latéral construit séparément. Cela signifie que lorsqu’une nouvelle machine rejoint le réseau, le service de coordination doit prévenir tous les nœuds existants pour qu’ils mettent à jour leur configuration. À l’échelle de Slack, c’est-à-dire plus de cinquante mille machines de production, chaque nouveau nœud impliquait d’informer cinquante mille nœuds de son existence, une approche intenable.

La solution de Nebula consiste à faire porter l’identité par des certificats PKI. Chaque machine reçoit, avant de rejoindre le réseau, un certificat signé par une autorité de certification, dans lequel sont encodés son adresse IP au sein du réseau superposé, son nom, ainsi que son appartenance à des groupes de sécurité définis par l’utilisateur. Lorsque deux machines communiquent pour la première fois, elles échangent et vérifient directement leurs certificats, confirment mutuellement leur identité, puis établissent un tunnel chiffré. Ce processus ne nécessite aucune distribution préalable de clés par un tiers, ni l’intervention d’un plan de contrôle pour coordonner les échanges. Selon les mots de Ryan Huber, ils voulaient un protocole qui traite directement l’identité et le transport, plutôt que d’accoler une identité à un VPN distinct.

Cette logique de décentralisation se retrouve également dans le mécanisme de découverte des nœuds. Il existe dans un réseau Nebula une catégorie de nœuds appelés Lighthouse (phare en français), dont l’unique fonction est de servir d’annuaire : indiquer à une machine comment en trouver une autre. Les Lighthouse ne communiquent pas entre eux et ne participent à aucun transfert de données. Si un réseau compte six Lighthouse et que cinq d’entre eux tombent en panne, le dernier continue de fonctionner normalement, et les chemins de trafic de l’ensemble du réseau restent inchangés.

Continuer la lecture

Tutoriel Linux : auto-héberger son moteur de recherche

Pour être franc, je visualise peu l’intérêt qu’il y a à auto-héberger son moteur de recherche. Quand bien même on est lassé du tracking que fait Google, il y a déjà des solutions qui permettent d’éviter ce tracking, comme le moteur de recherche StartPage par exemple, qui interroge Google pour nous, ou des moteurs alternatifs comme DuckDuckGo.

Mais bon, on peut. Donc on va voir comment faire cela.

Installer Degoog avec docker

L’installation se fait grâce à un conteneur docker, il faut donc que votre serveur soit prêt à lancer des services docker. Si ce n’est pas le cas, vous trouverez le guide d’installation docker sous Ubuntu ici et celui de Devuan ici.

Dans un répertoire dédié, créer un fichier docker-compose.yml avec pour contenu (changer le mot de passe par celui que vous choissirez) :

services:
  degoog:
    image: ghcr.io/degoog-org/degoog:latest
    container_name: degoog
    restart: unless-stopped
    ports:
      - "8100:4444"
    volumes:
      - ./data:/app/data
    environment:
      - DEGOOG_SETTINGS_PASSWORDS=MotDePasseAChanger
      - DEGOOG_PUBLIC_INSTANCE=true

Puis faites :

mkdir data
docker compose up -d
Continuer la lecture

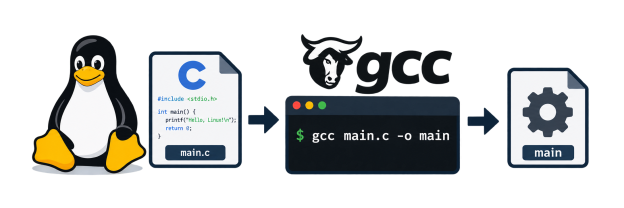
Tutoriel Linux : compiler le langage C

Le langage C est incontournable en environnement Linux, et pas seulement parce que le noyau Linux lui-même est programmé à 99% en C.

En effet, tous les binaires exécutables présents sur un système Linux, quel que soit le langage dans lequel ils sont développés, utilisent la librairie C, qui est le point de passage obligé pour s’interfacer avec les appels systèmes offerts par le noyau. Beaucoup de ces langages sont en réalité traduits en C avant d’être compilés (ce qui est assez cocasse), d’autres comme Python sont interprétés par un interpréteur écrit en C.

Comme nous l’avons déjà vu, les appels systèmes réellement offerts par le noyau (les vrais) sont différents des appels système offerts par la librairie C (souvent appelée libc pour faire court). Les (faux) appels système de la libc sont les seuls à être standardisés par la norme POSIX, qui définit les appels systèmes à implémenter dans un système Unix. La libc est parfaitement conforme (et offre même des appels système en plus) à la norme POSIX. Ne laissez donc jamais un incompétent vous affirmer que Linux n’est pas un Unix.

Le langage C est un langage merveilleux, très simple à apprendre (c’est ce qui a fait son succès), avec lequel on peut absolument TOUT programmer (même des applications web). C’est LE langage par excellence, celui qui, quand on le maîtrise, fait qu’on n’a plus besoin de s’intéresser aux autres langages de programmation.

Tout simple qu’il soit, il n’est pas question dans cet article d’apprendre la programmation C. Le lecteur se référera pour cela à un livre dédié comme celui-ci :

Ou mieux, le Kernighan et Ritchie original, écrit par les deux créateurs du langage C, que tout afficionado de Linux se doit d’avoir dans sa bibliothèque :

Continuer la lecture

Tutoriel Linux : auto-héberger Ntfy, le service de notification de smartphones

Lorsqu’on développe une application web qui ambitionne de tourner sur mobile, on n’a que peu d’accès au matériel du smartphone (notifications, GPS, etc.), contrairement à une application mobile native.

Accéder à une notification des clients sur smartphones depuis une application web n’est pas impossible, mais au prix de circonvolutions et de ruses de Sioux techniques.

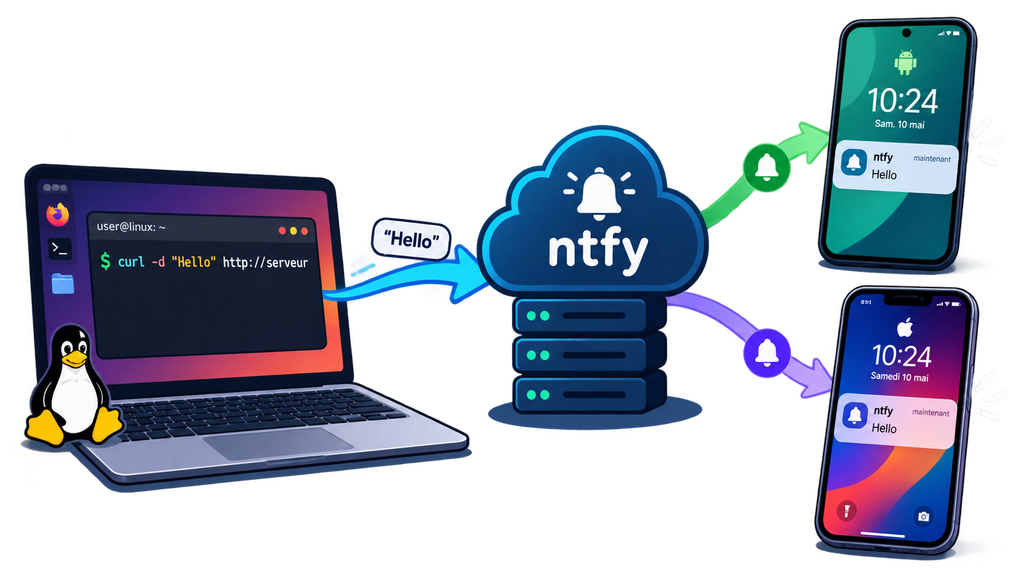
Heureusement, on peut laisser de côté la recherche de cet exploit technique puisqu’il existe un service clé en main qu’on peut utiliser pour faire notifier des smartphones depuis une application web : Ntfy (prononcer notify).

Ntfy est un service de notification. Il ne fait que cela, mais il le fait très bien. Ce service existe sous forme de SaaS ou auto-hébergeable gratuitement. C’est cette version gratuite auto-hébergée que nous allons mettre en place dans ce tutoriel.

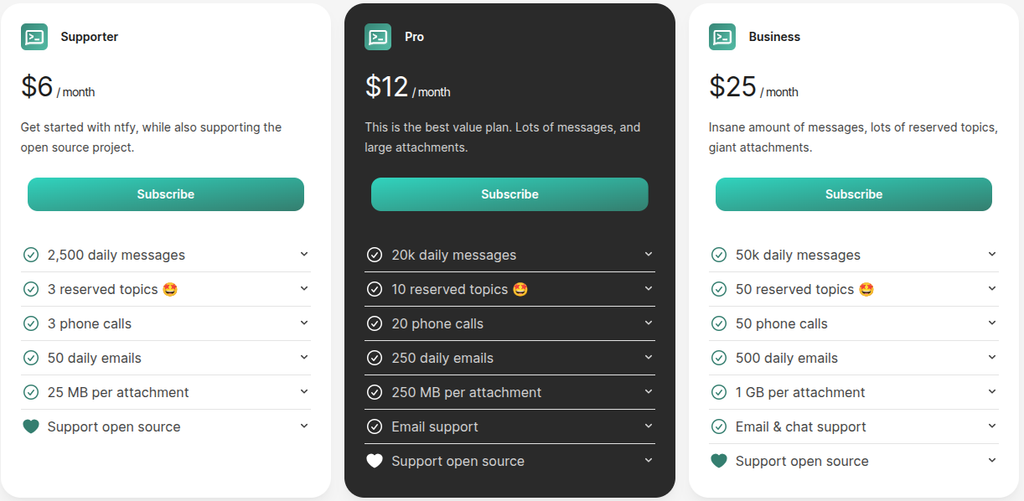
Prix des plans payants de la version SaaS
Continuer la lecture

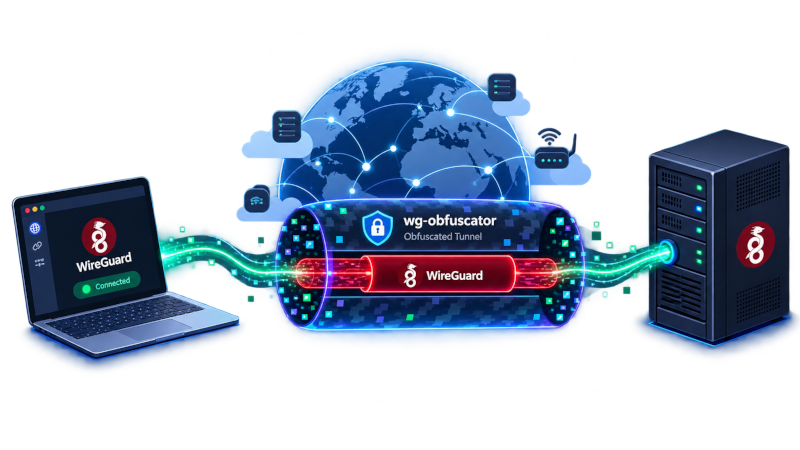
Tutoriel Linux : obfusquer le trafic Wireguard

Mettre en place un tunnel Wireguard entre des machines et un serveur est très utile mais cela n’est pas discret.

En effet, s’il est impossible pour un intervenant extérieur de visualiser en clair le trafic vu qu’il est chiffré, la nature Wireguard du trafic est par contre très facile à déterminer.

Dans un environnement réseau sous surveillance interdisant le trafic Wireguard, celui-ci sera facilement bloqué. La solution pour passer quand même est d’obfusquer le trafic en l’encapsulant dans un tunnel d’obfuscation.

Celui que nous allons utiliser dans ce tutoriel est wg-obfuscator, qui obfusque le trafic pour le faire ressembler à une visio-conférence, soit une nature de trafic moins sujet à des filtrages.

Rappel : l’installation de Wireguard sans obfuscation a déjà été couverte dans cet article.

Continuer la lecture

Fonctionnalités du noyau Linux (Episode 5) – Communication inter-processus

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.

Dans cet épisode 5 nous allons voir les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.

Rappelons que ces mécanismes sont indispensables car, comme nous l’avons vu dans l’épisode 2 consacré à la gestion de la mémoire, les processus vivent en mémoire virtuelle paginée utilisateur ce qui rend leur espace mémoire complètement étanche avec celui des autres processus.

Sans mécanisme particulier additionnel, la communication inter-processus ne serait tout simplement pas possible par construction.

Le noyau Linux, comme tous les Unices (pluriel d’Unix), offre 2 mécanismes de synchronisation (signaux et sémaphores) et 5 mécanismes d’échange de données (segments de mémoire partagée, files de messages, pipes, pipes nommés, et sockets Unix). Nous allons balayer le fonctionnement de ces mécanismes, dont nous étudierons l’utilisation dans des programmes en langage C dans des articles ultérieurs.

Les signaux

Les signaux sont un mécanisme de communication inter-processus qui permet d’envoyer des notifications asynchrones à un processus pour l’informer qu’un événement s’est produit. On peut les voir comme des « interruptions logicielles » qui permettent au noyau, à un autre processus ou à un utilisateur de contrôler et d’interagir avec un programme en cours d’exécution.

Un signal peut être généré par :

  • L’utilisateur : Par des combinaisons de touches comme Ctrl+C par exemple.
  • Le noyau : Pour signaler une erreur matérielle ou logicielle (par exemple, une division par zéro ou un accès mémoire invalide).
  • Un autre processus : Via des commandes shell comme kill ou des appels système.

Lorsqu’un signal est envoyé à un processus (en indiquant son PID), celui-ci peut y réagir de quatre manières différentes :

  1. Exécuter l’action par défaut : Souvent, cela termine le processus. Parfois, le signal est ignoré.
  2. Ignorer le signal : Le processus ne fait rien et continue son exécution.
  3. Intercepter le signal (avec un gestionnaire, ou callback) : Le processus exécute une fonction personnalisée pour traiter l’événement.
  4. Bloquer le signal : Le signal est mis en attente et ne sera délivré que lorsque le processus le débloquera.

Chaque signal est connu par un nom (SIGKILL, SIGSTOP, etc.) ou par son numéro.

Les signaux SIGKILL (signal qui porte le numéro 9) et SIGSTOP (qui porte les numéros 19, ou 23) sont des exceptions. Ils ne peuvent ni être interceptés, ni ignorés, ni bloqués. Cela garantit que l’utilisateur ou l’administrateur peut toujours stopper un processus, même s’il est défaillant.

Continuer la lecture