Archives de catégorie : Tutoriel

Tutoriel Linux : développement web avec backend en langage C (Episode 6 – Dialogue avec MySQL depuis un programme en C)

Le backend d’une application web doit très souvent stocker et lire des données dans une base de données. Souvent cette base de données fonctionne avec SQL, et parfois il s’agit de MySQL.

Je vais présenter ci-dessous les 7 fonctions que j’utilise en langage C pour accéder à une base MySQL située sur la même machine que le script C de backend.

J’ai mis ces fonctions dans un fichier climb.h et climb.c, dans lesquels il y a des fonctions relatives à beaucoup d’autres sujets, mais aussi les fonctions relatives au dialogue avec MySQL.

La librairie CLIMB (C LIbrary for Modern Backends)

CLIMB est donc la librairie qui regroupe toutes les fonctions utiles perso que j’utilise.

Voici les fonctions utiles, déclarées dans climb.h :

// MySQL functions
#define _MYSQL

typedef struct CLIMB_MYSQL_RESULT_STRUCT CLIMB_MYSQL_RESULT_STRUCT;
typedef CLIMB_MYSQL_RESULT_STRUCT *CLIMB_MYSQL_DBRESULT;

#define CLIMB_MYSQL_DBHANDLER MYSQL *
#define CLIMB_MYSQL_DBSTMT MYSQL_STMT *

CLIMB_MYSQL_DBHANDLER climb_mysql_opendatabase(char *databasename, char *host, char *login, char *password);
int climb_mysql_ntuples(CLIMB_MYSQL_DBRESULT result);
void climb_mysql_clear_result(CLIMB_MYSQL_DBRESULT result);
void climb_mysql_closedatabase(CLIMB_MYSQL_DBHANDLER handler);
void climb_mysql_getvalue(CLIMB_MYSQL_DBRESULT result, int row, int col, char *value, int max);
CLIMB_MYSQL_DBRESULT climb_mysql_query_prepare(CLIMB_MYSQL_DBHANDLER handler, char *query);
CLIMB_MYSQL_DBRESULT climb_mysql_do_query(int nparams, ...);

climb_mysql_opendatabase : ouvre une connexion avec la base MySQL dont le nom est databasename, située sur la machine dont le nom DNS est host (donc localhost pour nous), dont l’utilisateur propriétaire s’appelle login, et son mot de passe password. Si elle réussit, cette fonction ramène un handler qui permet de poursuivre le dialogue.

climb_mysql_query_prepare : prépare une requête query (préparée donc) pour la base de données ouverte (handler).

climb_mysql_do_query : envoie une quantité de nparams paramètres à la requête préparée par climb_mysql_query_prepare, et exécute cette requête SQL. Cette fonction ramène un résultat result.

climb_mysql_ntuples : compte le nombre de lignes (enregistrements) résultats de l’exécution de la requête.

climb_mysql_getvalue : récupère dans la variable value (de taille max) l’enregistrement de ligne row et de colonne col de la requête dont le résultat a été mis dans result.

climb_mysql_clear_result : ferme la requête courante pour permettre de passer ensuite une nouvelle requête.

climb_mysql_closedatabase : ferme la connexion à la base ouverte (handler).

Voici le code source ce ces fonctions dans climb.c :

Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 5 – Installation et configuration de MySQL)

Rares sont les applications web qui n’ont pas besoin de stocker des données dans une base de données. Bien que ce soit PostgreSQL qui ait le vent en poupe, je préfère personnellement utiliser MySQL, ou sa version communautaire MariaDB (MySQL ayant été acheté par Oracle). Elle s’installe et se configure facilement sous Linux, et surtout elle est facile à interférer avec depuis un programme en langage C.

Installation de MySQL sous Ubuntu

sudo apt update
sudo apt install mysql-server mysql-client libmysqlclient-dev

mysql-server est un paquet générique qui installe la dernière version en vigueur du serveur de base de données

mysql-client est un paquet qui installe la commande mysql, qui permet de se connecter au SGBD à la main

libmysqlclient-dev installe un paquet qui fournit ce qu’il faut pour se connecter à MySQL depuis un programme en C

Configuration initiale de MySQL (à faire une seule fois)

Une fois les paquets installés, on lance la sécurisation de MySQL par :

sudo mysql_secure_installation

Ce programme va poser des questions auxquelles il faut répondre. Il faudra notamment donner le mot de passe MySQL de root qu’on choisit, confirmer la suppression des utilisateurs anonymes et des bases de test, et désactiver la connexion à distance de root.

Ensuite on va permettre à root de se connecter facilement. Pour faire ce paramétrage, on tape dans le shell la commande :

sudo mysql

On arrive dans le shell de mysql, dans lequel on tape (remplacer le mot de passe par celui que vous avez choisi pour root) :

ALTER USER 'root'@'localhost' IDENTIFIED WITH caching_sha2_password BY 'VotreMotDePasseDeRoot';

FLUSH PRIVILEGES;

EXIT;

Désormais MySQL est configuré et root peut s’y connecter en tapant la commande :

mysql -u root -p mysql

Cette commande se lit : lancer l’utilitaire mysql (qui est le client MySQL) en utilisant l’utilisateur (-u) root, en demandant le mot de passe (-p) et si l’identification est ok, le connecter à la base mysql (qui est mentionnée derrière -p).

Créer une base de données et un utilisateur pour une future application en C

Maintenant que MySQL est opérationnel, on peut y créer autant de base de données, et d’utilisateurs propriétaires de ces bases de données, que l’on veut.

Chaque application web aura sa base de données (utilisable en lecture et écriture depuis ses scripts en C, on verra par la suite comment faire), et son utilisateur propriétaire de cette base de données.

Imaginons que notre application s’appelle tartemuche. On va donc créer une base de données tartemuche, un utilisateur local (uniquement, il ne pourra pas se connecter à distance par sécurité. Les scripts en C devront donc tourner sur le même serveur que celui qui héberge MySQL) tartemuche qui aura tous les droits sur la base de données tartemuche et qui aura comme mot de passe de connexion à cette base de données tartemolle.

Voyons comment préparer cela. Tout d’abord on se connecte en tant que root à la base de données mysql :

Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 4 – L’extraction et le décodage des données du formulaire)

Dans l’épisode 3 nous avons vu comment coupler un formulaire HTML (form) présenté au client web et rempli par lui, et un script écrit en C qui reçoit et traite ces données.

Nous avons vu que le script en C récupère pour le formulaire une chaine de caractère unique, comme par exemple :

texte=C%27est+une+vir%C3%A9e+ma%C3%A7onnique+v%C3%A9n%C3%A8re+%23%24*&motdepasse=re%C3%A7u

Cette chaine reprend les champs définis par le formulaire (texte et motdepasse) séparés par le caractère &, et les valeurs envoyées par le formulaire pour ces champs (C%27est+une+vir%C3%A9e+ma%C3%A7onnique+v%C3%A9n%C3%A8re+%23%24* pour texte, et re%C3%A7u pour motdepasse).

Ces valeurs doivent maintenant pouvoir être extraites une par une, et surtout doivent pouvoir être retraitées pour que le codage HTML effectué par le navigateur du client soit décodé pour retrouver les frappes exactes réalisées par l’utilisateur.

C’est pourquoi nous allons ajouter quelques fonctions au programme script.c que nous avons vu à l’épisode 3.

Nous allons notamment ajouter la fonction http_request_body_item qui permet de lire la valeur de rang n dans la chaine de caractère unique (n=1 pour la dernière valeur de la chaine, n=2 pour l’avant dernière valeur de la chaine, etc.), et la fonction http_translate qui décode la valeur passée en paramètre.

Voici donc le nouveau programme script.c complet, avec capacité d’extraction et de décodage des champs :

#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <string.h>

char* http_post_request_body()
{
int query_size;

query_size=atoi(getenv("CONTENT_LENGTH"));
char* query_string = (char*) malloc(query_size+10);
if (query_string != NULL) fread(query_string,query_size,1,stdin);
return query_string;
}

int http_request_body_item(char *in_string,int pos,char *out_string)
{
int i,n,start;

i=strlen(in_string);
for(n=0; n<pos;n++) 
	{
	while(in_string[i]!='=') i--;
	i--;
	}
i+=2;
start=i;
do
	{
	out_string[i-start]=in_string[i];
	i++;
	}
while(in_string[i-1]!=0 && in_string[i-1]!='&');
out_string[i-start-1]=0;
}

void http_urldecode(char *string)
{
int i,start;
char *res,buf[50];

start=i=0;
res=(char *)malloc(10*strlen(string));
while(i<=strlen(string))
	{
	if(string[i]!='%') 
		{
		res[start]=string[i];
		i++;
		start++;
		}
	else
		{
		if(string[i+1]=='0' && string[i+2]=='A')
			{
			res[start]='\\';
			res[start+1]='\\';
			res[start+2]='n';
			start = start+3;
			i = i+3;
			}
		else
			{
			if(string[i+1]!='3' || string[i+2]!='C')
				{
				sprintf(buf,"0x%c%c",string[i+1],string[i+2]);
				res[start]=strtol(buf,NULL,16);
				start++;
				i = i+3;
				}
			else
				{
				res[start]='&';
				res[start+1]='l';
				res[start+2]='t';
				res[start+3]=';';
				start = start+4;
				i = i+3;
				}
			}
		}
	}
strcpy(string,res);
free(res);
}

void http_prepare(char *string)
{
int i,start;
char *res;

res=(char *)malloc(strlen(string)*2);
i=start=0;
do
	{
	if(string[i]!=';' && string[i]!='\'' && string[i]!='"') res[start]=string[i];
	else res[start]=' ';
	start++;
	i++;
	}
while(i<=strlen(string));
strcpy(string,res);
free(res);
}

void http_translate(char *in_string)
{
int i;

for(i=0;i<strlen(in_string);i++)
	{
	if(in_string[i]=='+') in_string[i]=' ';
	}
http_urldecode(in_string);
http_prepare(in_string);
}

int main()
{
char *request_body;
extern char **environ;
char **e;
char *texte,*motdepasse;

request_body=http_post_request_body(); // on récupère les données envoyées par le formulaire
// On initialise la taille des deux variables qui vont accueillir les données tapées par l'utilisateur dans le formulaire.
// Cette manière de faire garantit que le débordement de tampon (buffer overflow) sera impossible
texte=(char *)malloc(strlen(request_body));
motdepasse=(char *)malloc(strlen(request_body));
http_request_body_item(request_body,2,texte); // On récupère l'avant dernière (position 2 par rapport à la fin) information brute transmise par le formulaire, donc le texte tapé codé HTML
http_translate(texte); // On réalise le décodage texte tel que l'utilisateur l'a tapé
http_request_body_item(request_body,1,motdepasse); // On récupère la dernière (position 1 par rapport à la fin) information transmise par le formulaire, donc le mot de passe tapé
http_translate(motdepasse);
// on construit maintenant la page html de réponse, en écrivant sur la sortie standard. NginX intercepera cette sortie et l'enverra tout seul au client web
printf("Content-type: text/html\n\n"); // Cette ligne d'entête est fondamentale. Sans elle le format de réponse ne serait pas respecté
printf("<!DOCTYPE html>\n\
<html lang=\"fr\">\n\
<head>\n\
	<meta charset=\"UTF-8\">\n\
    <title>Page de réponse du script</title>\n\
</head>\n\
<body>\n");
printf("Données reçues du formulaire : %s<br>Texte tapé : %s<br>\nMot de passe tapé : %s<br><br>\n",request_body,texte,motdepasse);
printf("Variables d'environnement du formulaire : <br><br>\n");
for(e=environ;*e;e++) printf("%s<br>\n",*e);
printf("</body>\n\
</html>\n");
}

Comme dans l’épisode 3, on le compile et installe par les commandes :

gcc script.c -o script.cgi
sudo cp ./script.cgi /usr/lib/cgi-bin

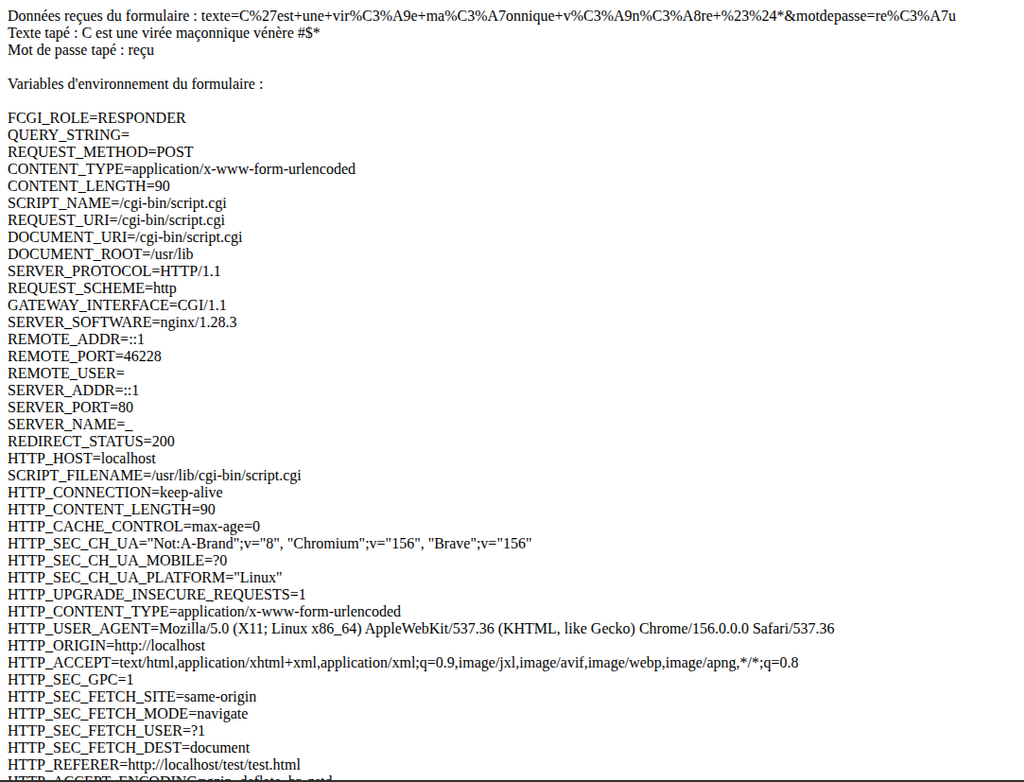
Voici ce que donne la réponse du script en C quand on saisit des données dans le formulaire :

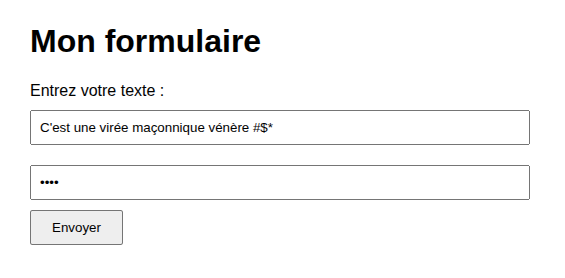
Le script a bien extrait et décodé les données du formulaire puisqu’il affiche :

Texte tapé : C est une virée maçonnique vénère #$*
Mot de passe tapé : reçu

Pour être franc, le script a retiré l’apostrophe de C’est. On peut la garder mais c’est le genre de détail dangereux si le script en C est couplé à une base MySQL (ce qui n’est pas le cas ici), car le maintient de l’apostrophe sans ruser ouvrirait la porte à une attaque par injection SQL.

Il est bien évident que les fonctions C d’extraction et de décodage que nous avons ajoutées seront à utiliser dans tous les futurs scripts. Le réflexe naturel est donc de regrouper ces fonctions dans un fichier C à part, réutilisable.

Si l’on met à part ces fonctions, le corps du script en C restant devient finalement très simple, puisque cela se résume à la fonction main :

int main()
{
char *request_body;
extern char **environ;
char **e;
char *texte,*motdepasse;

request_body=http_post_request_body(); // on récupère les données envoyées par le formulaire
// On initialise la taille des deux variables qui vont accueillir les données tapées par l'utilisateur dans le formulaire.
// Cette manière de faire garantit que le débordement de tampon (buffer overflow) sera impossible
texte=(char *)malloc(strlen(request_body));
motdepasse=(char *)malloc(strlen(request_body));
http_request_body_item(request_body,2,texte); // On récupère l'avant dernière (position 2 par rapport à la fin) information brute transmise par le formulaire, donc le texte tapé codé HTML
http_translate(texte); // On réalise le décodage texte tel que l'utilisateur l'a tapé
http_request_body_item(request_body,1,motdepasse); // On récupère la dernière (position 1 par rapport à la fin) information transmise par le formulaire, donc le mot de passe tapé
http_translate(motdepasse);
// on construit maintenant la page html de réponse, en écrivant sur la sortie standard. NginX intercepera cette sortie et l'enverra tout seul au client web
printf("Content-type: text/html\n\n"); // Cette ligne d'entête est fondamentale. Sans elle le format de réponse ne serait pas respecté
printf("<!DOCTYPE html>\n\
<html lang=\"fr\">\n\
<head>\n\
	<meta charset=\"UTF-8\">\n\
    <title>Page de réponse du script</title>\n\
</head>\n\
<body>\n");
printf("Données reçues du formulaire : %s<br>Texte tapé : %s<br>\nMot de passe tapé : %s<br><br>\n",request_body,texte,motdepasse);
printf("Variables d'environnement du formulaire : <br><br>\n");
for(e=environ;*e;e++) printf("%s<br>\n",*e);
printf("</body>\n\
</html>\n");
}

Dans l’épisode 5 nous verrons un fichier C réutilisable dans les scripts qui contient tout ce dont on a besoin d’y piocher pour gérer les cas de figure les plus courants, et notamment le dialogue avec une base de données MySQL depuis un script en C.

Stay tuned 😎
Tutoriel Linux : développement web avec backend en langage C (Episode 3 – Le couple form / script)

Maintenant que notre serveur NginX est installé et configuré pour être en mesure de transférer les requêtes des clients web aux scripts CGI, nous allons voir dans cet épisode 3 comment se fait ce dialogue entre le client web et le script CGI.

Côté client web : la form

La page web affichée sur le poste client web va utiliser des forms (formulaires HTML en français).

Il s’agit d’un formulaire contenant des items à afficher dans le formulaire (de différents types comme des inputs pour saisir du texte, des boutons radio, des cases à cocher, des zones de saisie de mot de passe, des listes déroulantes, etc.), un script cible (qui pour nous sera écrit en langage C), et un bouton pour activer le formulaire.

Activer le formulaire signifie que le navigateur web du client va lire les données saisies ou choisies par l’utilisateur, et les envoyer au script CGI.

La nature de l’envoi vers le script CGI est indiquée dans le formulaire. Elle peut être GET ou POST.

Si GET est utilisé, les données saisies dans la form seront transmises sur l’URL du script appelé, ce qui n’est pas top pour la sécurité. C’est pourquoi nous utiliserons que la méthode POST, qui envoie les données vers le script dans le flux html, donc non visible des hommes du milieu dès lors qu’on est en https.

Dans l’exemple que nous allons utiliser, voici la page web que l’on affiche sur le client web :

<!DOCTYPE html>
<html lang="fr">
<head>
    <meta charset="UTF-8">
    <title>Formulaire CGI</title>
    <style>
        body { font-family: sans-serif; max-width: 500px; margin: 50px auto; padding: 20px; }
        input[type="text"] { width: 100%; padding: 8px; margin: 10px 0; box-sizing: border-box; }
	input[type="password"] { width: 100%; padding: 8px; margin: 10px 0; box-sizing: border-box; }
        input[type="submit"] { padding: 8px 20px; cursor: pointer; }
        .result { padding: 15px; background: #eef; border-radius: 5px; }
    </style>
</head>
<body>
    <h1>Mon formulaire</h1>
    <form action="/cgi-bin/script.cgi" method="post">
        <label for="texte">Entrez votre texte :</label>
        <input type="text" placeholder="Entrez du texte ici" id="texte" name="texte" required>
	<input type="password" placeholder="Entrez un mot de passe ici" id="mdp" name="motdepasse" required>
        <input type="submit" value="Envoyer">
    </form>
</body>
</html>

Cette page web comporte un petit script CSS pour l’esthétique, mais surtout elle contient une form (visible en gras), dans laquelle on voit que le formulaire contient comme items à afficher un label (du texte), un input requis (ie on ne pourra pas déclencher le formulaire si ce champ est vide) pour saisir du texte, un mot de passe, et un bouton submit pour déclencher le formulaire.

Comme on peut le voir, ce formulaire a pour cible le script dont l’URL est /cgi-bin/script.cgi en utilisant la méthode POST.

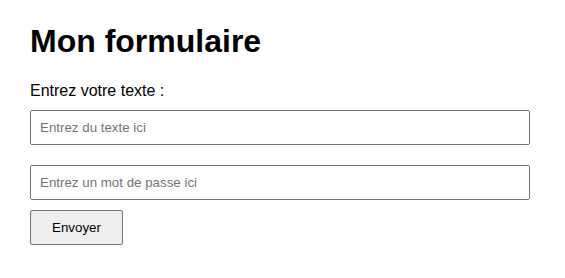
On met ce fichier test.html dans /var/www/html sur le serveur web, ce qui affiche la page suivante sur le navigateur du client lorsqu’il se connecte sur cette URL https://serveur/test.html :

Voici ce qui s’affiche quand l’utilisateur saisit les données :

Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 2 – Installation et configuration de NginX)

Nous avons introduit dans l’épisode 1 ce que nous allons faire (apprendre à construire des sites web dont le backend est en langage C).

Dans cet épisode 2 nous allons installer le serveur web NginX et le configurer de sorte qu’il soit en mesure de faire tourner des unités de traitement écrites en C.

Sur le serveur, dans un shell bash, nous allons taper :

1) Installer les paquets nécessaires :
sudo apt-get update
sudo apt-get install nginx fcgiwrap

2) Paramétrer le serveur web Nginx :
sudo cp /usr/share/doc/fcgiwrap/examples/nginx.conf /etc/nginx/fcgiwrap.conf
sudo mkdir /usr/lib/cgi-bin
sudo nano /etc/nginx/sites-available/default

Dans la rubrique “server” du fichier, il faut ajouter la ligne ci-dessous juste après l’accolade fermante de location
include fcgiwrap.conf;

Relancer Nginx :
sudo service nginx restart

3) Vérifier maintenant que NginX est capable d'exécuter un script CGI :
sudo nano /usr/lib/cgi-bin/test

Mettre dans ce fichier /usr/lib/cgi-bin/test.cgi le contenu suivant :
#!/bin/bash
echo "Content-Type: text/html"
echo
echo "<html><body>Succes</body></html>"

Puis changer les paramétrages de droits et de propriétaires de ce fichier :
sudo chown www-data.www-data /usr/lib/cgi-bin/test
sudo chmod 755 /usr/lib/cgi-bin/test

Si la page d'URL http://serveur/cgi-bin/test affiche bien à l'écran le mot "Succes", tout est Ok, NginX est installé et sait gérer des unités de traitements scripts CGI.
Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 1 – Introduction)

Le développement web se fait aujourd’hui grâce à des langages modernes : Javascript, Typescript, React pour le frontend, PHP, node.js notamment pour le backend.

Quand j’explique à des programmeurs que je programme mes backends en langage C, ils sont généralement très étonnés que ce soit même faisable.

Et pourtant, ça marche très bien. Ce n’est probablement pas le langage le plus adapté, mais ce n’est pas compliqué et ça marche.

Quels avantages en tirer ?

Tout d’abord la simplicité. Avec le C il n’y a aucune bibliothèque ou framework externe à charger. Le programme ne fera que ce que vous écrivez. Vous maîtrisez la compréhension du code de A à Z. Ce qui ne vous empêche pas bien sûr de vous créer votre propre bibliothèque de routines réutilisables en C.

Deuxièmement, la vélocité. A part l’assembleur, aucun langage n’est aussi rapide que le C. Votre serveur web sera donc hyper véloce.

Troisièmement, l’indépendance. Comme vous n’utilisez aucune bibliothèque ou framework externe, vous n’aurez pas de mise à jour de ceux-ci qui mettent par terre votre mécanique.

Comment ça marche ?

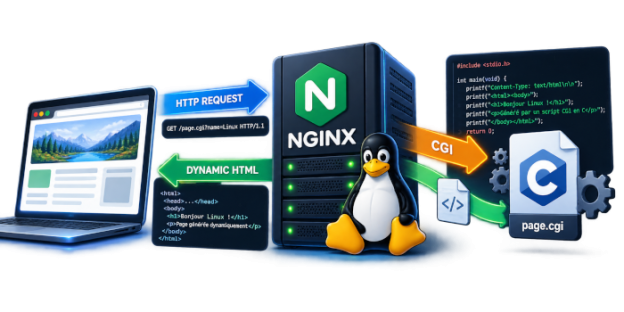
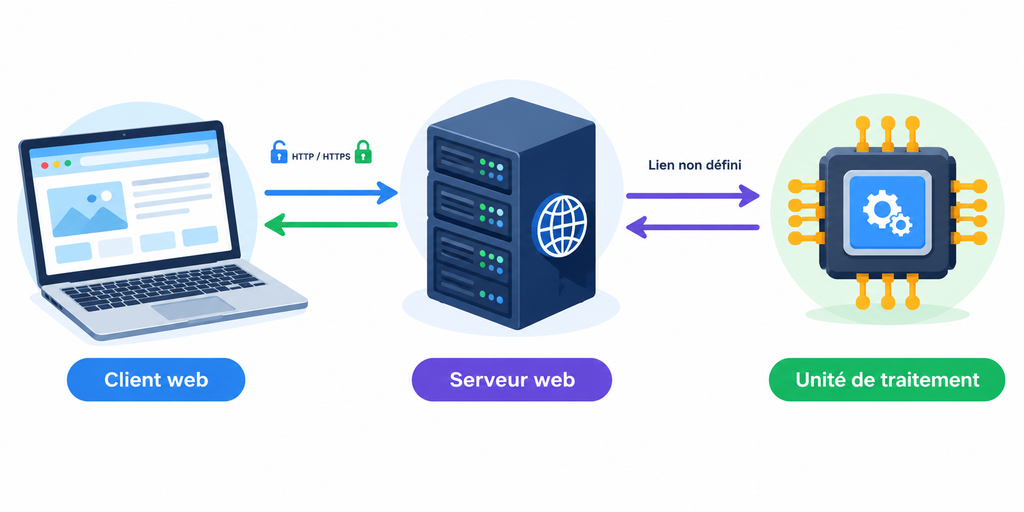
Servir dynamiquement des pages web relève toujours de la même mécanique, représentée ci-dessous :

Le client web à servir (le navigateur) communique avec un serveur sur lequel 2 services tournent : le serveur web et l’unité de traitement.

Le serveur web s’occupe d’un côté de communiquer avec le client en http ou en https, selon comment il est configuré. Et de l’autre côté il s’occupe de transmettre à l’unité de traitement les data des requêtes que le client web lui a envoyées.

L’unité de traitement sait quoi faire des données de requête reçues du client (consulter ou mettre à jour une base de données par exemple), et sait générer une page html de réponse qu’il transmet au serveur web.

Le serveur web récupère la page html générée par l’unité de traitement, et la transmet au navigateur du client qui l’affiche.

NB : Nous nous plaçons ici dans le cas où la page entière est mise à jour, pas la cas où une partie seulement de la page est mise à jour dynamiquement sans recharge de la page entière. Ce cas de figure se traite en effet avec des websockets et a déjà été traité dans l’article sur les websockets en C.

Concrètement, quand on utilise node.js, celui-ci prend en charge seul le serveur web et l’unité de traitement qui est le programme qu’on est en train d’écrire. Ce script est interprété par le moteur V8 mais certaines parties qui sont exécutées souvent sont compilées à la volée pour améliorer la vélocité.

Les sites bâtis avec PHP fonctionnent avec un vrai serveur web (Nginx, Apache, …) et l’unité de traitement est le Zend engine (écrit en C) qui interprète le script de traitement PHP à exécuter (le terme interprète est légèrement abusif puisque le Zend engine fait en réalité une pseudo compilation en bytecode avec d’exécuter le script).

Et le C là dedans ?

Continuer la lecture →

Tutoriel Linux : programmer avec les POSIX Threads

Nous avons vu dans l’épisode consacré aux processus que le noyau Linux offre deux appels systèmes pour lui demander de créer des processus fils : fork et exec.

C’est une mécanique parfaitement fonctionnelle, mais elle a le défaut d’être lourde à gérer pour le noyau puisqu’à chaque création de processus fils celui-ci doit réaliser des tâches très lourdes qui vont avec, comme faire hériter ce nouveau processus de l’environnement du père, de la table des descripteurs de fichiers du père, des variables du père, etc.

C’est pourquoi on appelle ces processus normaux des processus lourds.

Dans les serveurs notamment, pour lesquels chaque nouvelle connexion d’un client amène à la création d’un processus fils, la montée en charge est synonyme de multiplication de processus lourds qui peuvent mettre à genou la machine.

Pour palier à ces défauts, le monde Unix a spécifié des processus légers, appelés threads, sous une norme POSIX : les POSIX threads (ou pthreads).

Les pthreads sont disponibles sous tous les Unices (pluriel d’Unix) qui les ont implémentés : BSD, MacOS, Solaris, et bien sûr Linux.

Les POSIX threads

Contrairement à un processus lourd fils, un pthread tourne au sein du processus père (qui ne s’appelle plus père en fait, puisqu’il n’a pas de fils).

La mécanique est assez simple : dans le main d’un processus on va lancer autant de pthreads qu’on le souhaite (via l’appel système pthread_create), chacun sur une fonction de traitement qui peut lui être propre. Tous ces pthreads vont tourner en parallèle dans l’unique processus courant : ils vont donc tous avoir accès aux variables globales du processus, ce qui va poser exactement le même problème d’incertitude lié aux accès concurrents que nous avions vus pour lors de l’article sur les sémaphores.

C’est pourquoi l’accès en lecture ou en écriture aux variables globales du processus doit être considéré comme une section critique à protéger par un sémaphore. Ce problème étant un classique, les pthreads viennent avec leur propres sémaphores (les pthreads_mutex_t), beaucoup plus simples à utiliser mais tout aussi efficaces (la prise de jeton se demande avec pthread_mutex_lock, et l’abandon de jeton se fait avec pthread_mutex_unlock). La suppression d’un sémaphore se fait avec pthread_mutex_destroy.

Pour en revenir aux pthreads eux-mêmes, ils font leur travail en parallèle comme on l’a dit, puis ils meurent, soit en faisant un return à la fin de leur fonction de traitement (cas général), soit en appelant pthread_exit (cas particulier quand on veut faire mourir le thread en cours de fonction de traitement et non à la fin, par exemple si l’on rencontre une erreur).

Continuer la lecture →

Tutoriel Linux : Maintenir à jour les images docker avec Tugtainer

Lorsqu’on dispose d’un VPS Linux actif en ligne 24/7, et que l’on fait tourner dessus moulte services docker ou docker compose, se pose la question du maintien à jour de ces images et services.

En effet, de nombreuses images docker font l’objet d’un MCO dynamique de la part des équipes qui les maintiennent. Du coup, les questions légitimes à se poser pour son VPS sont :

  • Quelles sont mes images qui font l’objet d’une mise à jour ?
  • Comment minimiser l’énergie que ces mises à jour vont me prendre (surtout si l’on a plusieurs VPS) ?
  • Comment purger automatiquement les anciennes images qui sont toujours sur le disque mais qui ne servent plus ?
  • Comment minimiser le délai de perte de services pendant ces maintenances ?

En amont de ces questions il y en a une plus fondamentale encore, mais hors scope de cet article, dois-je effectuer les mises à jour ? Il n’est en effet pas rare qu’une mise à jour d’image docker amène des régressions, voire casse carrément la prod. Ce problème s’adresse normalement par des tests préalables en environnement de pré-prod.

Quel outil choisir pour le MCO des images et conteneurs ?

On peut utiliser le classique WatchTower, ou What’s up docker (WUD), mais je préfère utiliser Tugtainer.

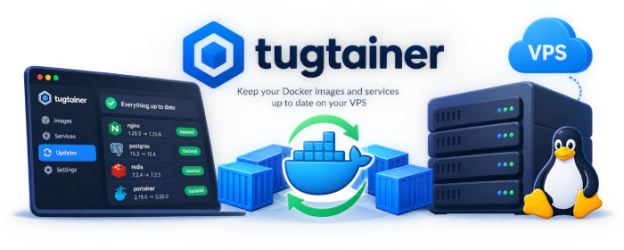
Son principe est simple : on fait tourner sur le VPS un agent Tugtainer sous forme de conteneur docker, et un client web également en conteneur docker sur la machine distante qu’on utilise pour la maintenance du VPS (un laptop par exemple).

Sur l’interface web du laptop on déclare comme machine l’agent distant qui tourne sur tous les VPS qu’on veut maintenir. Depuis cette interface web laptop on peut alors demander à chacun des agents Tugtainer distants de réaliser seul les tâches fondamentales suivantes :

  • Nous dire quelles sont les images docker qui disposent d’une mise à jour à télécharger (individuellement ou pour toutes les images du VPS)
  • Mettre à jour les images docker disposant d’une mise à jour à télécharger, individuellement ou pour toutes les images du VPS, en arrêtant et relançant les services sur les nouvelles images tout en optimisant le délai d’arrêt du service
  • Purger toutes les images docker du VPS devenues inutiles

Avec un tel outil, il n’y a presque plus besoin de se connecter à la mano au VPS pour y faire ces travaux. Presque car Tugtainer ne sait pas mettre à jour … Tugtainer ! (Pour tugtainer lui-même, et ses agents, il faudra se connecter et le faire à la mano. Mais il est capable de nous dire si des mises à jour de ces images sont disponibles).

Tugtainer est un outil performant qui est régulièrement mis à jour.

Continuer la lecture →

Tutoriel Android / Linux : Installer et utiliser SimpleX chat, la messagerie chiffrée sans identifiant

SimpleX Chat part d’un constat simple : la plupart des messageries chiffrées protègent le contenu des messages, mais laissent fuiter l’essentiel : qui parle à qui.

Signal et WhatsApp savent que vous existez, que vous avez un numéro ou un compte, et quels contacts vous échangez. SimpleX pousse la logique un cran plus loin en supprimant purement et simplement la notion d’identifiant utilisateur.

En effet, SimpleX Chat est une application de messagerie open source qui se présente comme le premier réseau de messagerie sans identifiant utilisateur d’aucune sorte, pas même un identifiant aléatoire .

Concrètement, il n’y a ni numéro de téléphone, ni nom d’utilisateur, ni adresse email à fournir. Votre profil et vos contacts sont stockés uniquement sur votre appareil, et les serveurs relais n’y ont pas accès .

L’application est disponible sur Android, iOS, Linux, macOS et Windows . Elle est gratuite et son code source est public.

Fonctionnement : des files d’attente plutôt que les identités

Le fonctionnement de SimpleX repose sur un renversement architectural. Au lieu d’attribuer à chaque utilisateur une adresse unique par laquelle transiteraient tous ses messages, SimpleX crée des files d’attente unidirectionnelles (queues) pour chaque conversation. Une file sert à recevoir les messages, une autre à les envoyer. Ces files ont des identifiants éphémères et aléatoires, sans lien avec votre personne .

Pour contacter quelqu’un, vous ne cherchez pas son nom d’utilisateur : vous lui transmettez un lien d’invitation à usage unique (ou un QR code), par un canal externe (de vive voix, SMS, etc.). Une fois la connexion établie, vos messages transitent par des serveurs relais qui ne voient qu’un flux chiffré entrant et sortant, sans pouvoir relier les deux files à une même conversation ni identifier les personnes .

Le chiffrement de bout en bout est assuré par un protocole de double ratchet résistant aux attaques quantiques, et il est activé par défaut pour tous les échanges, y compris les fichiers, les appels audio/vidéo et les messages vocaux .

Ce qui distingue SimpleX de Signal et WhatsApp

La différence tient en un mot : les métadonnées.

WhatsApp appartient à Meta et repose sur un numéro de téléphone comme identifiant. Même avec le chiffrement de bout en bout, l’entreprise sait qui vous êtes, qui sont vos contacts, et quand vous communiquez.

Signal est bien meilleur élève : l’application est open source, à but non lucratif, et ne conserve quasiment aucune métadonnée. Mais elle repose toujours sur un numéro de téléphone comme identifiant, et son architecture centralisée implique que les serveurs Signal savent quels comptes existent et quand ils se connectent, même s’ils ne savent pas qui parle à qui.

SimpleX élimine l’identifiant lui-même. Il n’y a pas de « compte » à proprement parler. Chaque conversation utilise des files d’attente anonymes et jetables. Le serveur relais ne peut pas reconstruire de graphe social parce qu’il n’y a pas de nœuds à relier . Cette approche a un coût : pas d’annuaire, pas de découverte de contacts, une ergonomie d’ajout de contact moins fluide. C’est le prix de la confidentialité des métadonnées.

Continuer la lecture →

Tutoriel Linux : Installer et utiliser la reconnaissance vocale par IA sous Ubuntu

Canonical vient d’annoncer que sa reconnaissance vocale assistée par IA, Myna, est disponible en preview technologique, ce qui signifie que si elle sera livrée bientôt en standard dans la distribution elle nécessite pour l’instant d’être installée à la main, et comporte encore potentiellement quelques bugs.

La technologie Myna consiste à installer une IA en local sur la machine, de sorte que la reconnaissance vocale se fasse uniquement en local et donc ne sorte pas de la machine.

L’installation sous Ubuntu 26.04 LTS se fait en installant le ppa officiel :

sudo add-apt-repository ppa:canonical-desktop-team/myna
sudo apt update
sudo apt install myna-config
myna-config

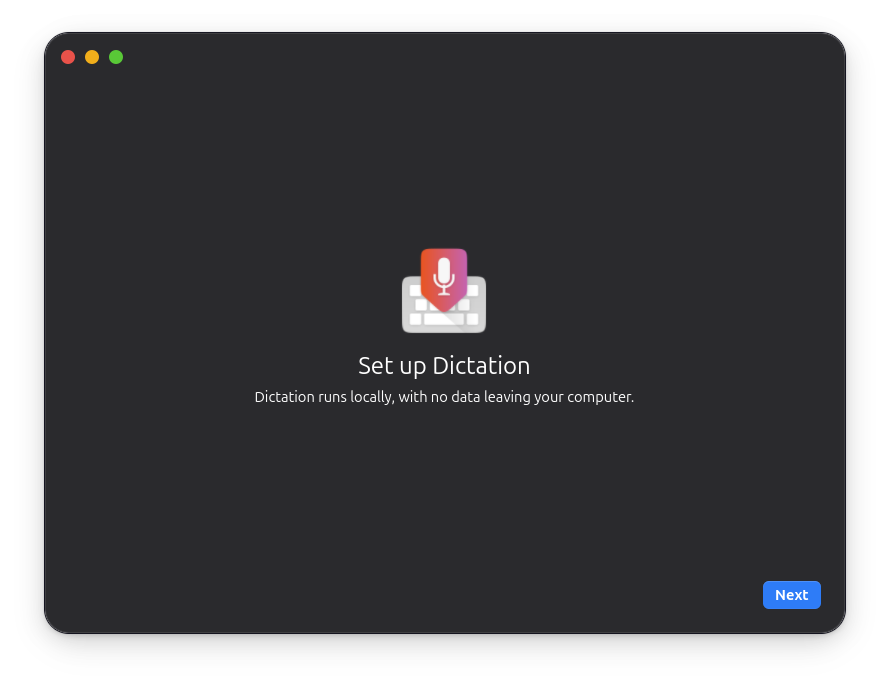
On entre alors en phase de configuration (en anglais).

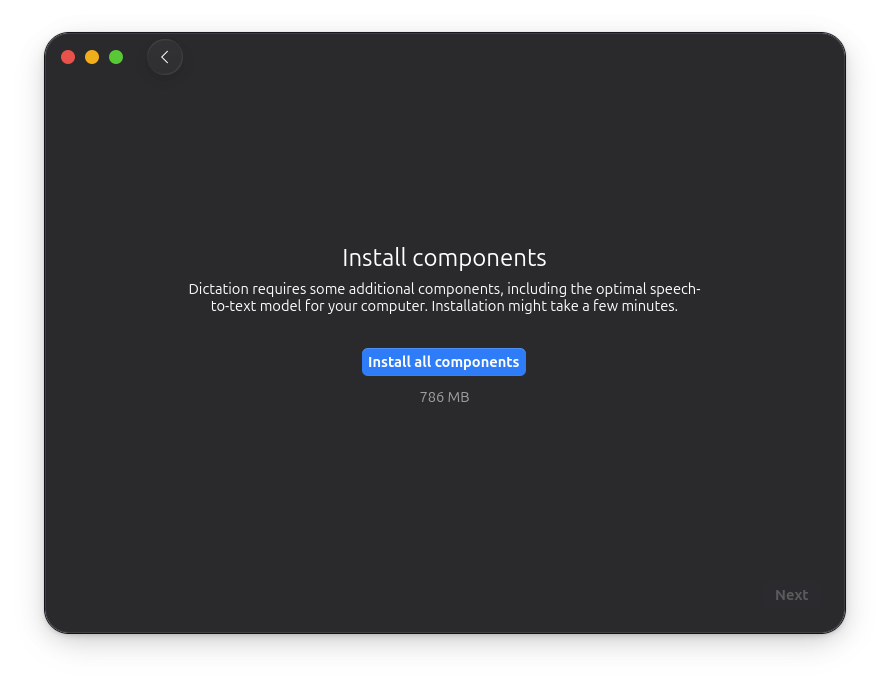
Il est proposé d’installer les composants nécessaires (IA capable de comprendre le français).

L’installation prend quand même un certain temps.

Le logiciel finit en indiquant que la reconnaissance vocale s’active et se désactive par défaut par la combinaison de touches Win + J

Continuer la lecture →