Tutoriel Linux : développement web avec backend en langage C (Episode 9 – Une web app complète en C)

Pour mettre en œuvre tous les concepts vus dans les épisodes précédents, voici une web app en C opensource, que j’ai conçue et réalisée à titre de démo sans prétention.

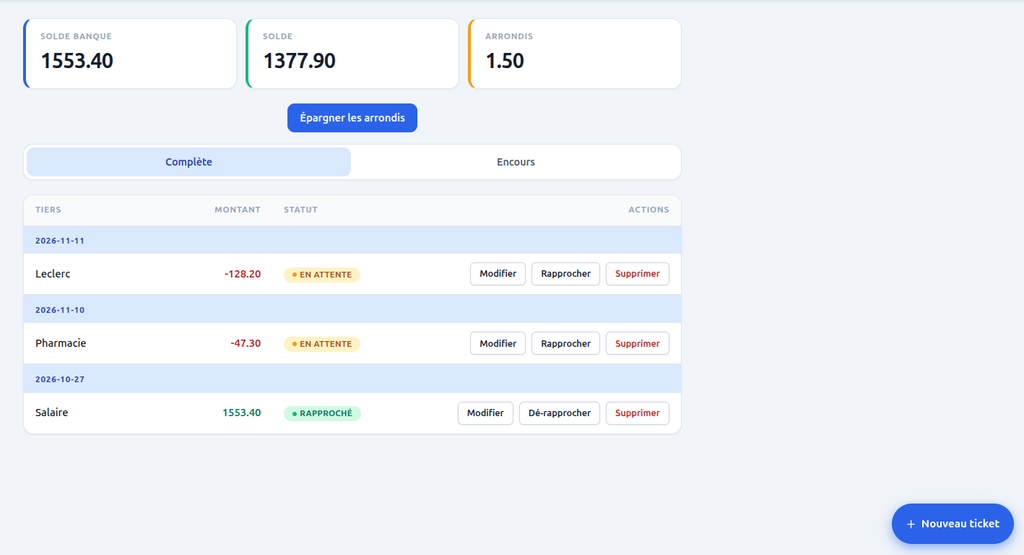
Il s’agit d’une application qui permet de faire le suivi et la gestion d’un compte bancaire complet. Les quatre fonctionnalités implémentées sont simples, mais fonctionnelles: ajout, modification, suppression, et rapprochement de tickets.

Le logiciel réalise les totaux banque (tickets rapprochés uniquement) et personnel (tous tickets) et permet même d’épargner les arrondis.

Le lecteur intéressé peut le tester avec un compte de démo et le télécharger sur un dépôt public.

Compte de démo : login demo, mot de passe demotickechic.

Ou alors aller sur la page d’accueil de la démo.

Voici à quoi ressemble le logiciel :

Code source complet et instructions d’installation

Qu’est-ce qu’un harnais en IA ?

Dans le domaine de l’intelligence artificielle, le terme harnais (harness en anglais) désigne la couche logicielle qui entoure un grand modèle de langage pour le transformer en un agent capable d’exécuter réellement des tâches. Une formule résume bien cette idée : Agent = Modèle + Harnais.

Pourquoi est-ce nécessaire

Un modèle de langage brut, comme GPT ou Claude, est un cerveau très performant mais isolé. Il ne peut que générer du texte, ne se souvient de rien d’une session à l’autre et n’agit sur rien. Le harnais joue le rôle de système nerveux et de manuel d’utilisation. Il fournit au modèle des données à consulter, des outils à manipuler et des règles à respecter. C’est ce qui lui permet de passer de la capacité à parler à la capacité à agir.

Ce que contient concrètement un harnais

Un harnais complet comprend généralement plusieurs composants. D’abord une invite système, qui définit le rôle de l’agent, ses objectifs et les règles qu’il doit suivre en permanence. Ensuite des outils et un mécanisme d’exécution : le modèle décide quoi faire, le harnais se charge d’exécuter l’action réelle, comme un appel d’API ou l’exécution de code, puis renvoie le résultat au modèle. Vient également la gestion de la mémoire et du contexte, qui détermine quelles informations conserver et lesquelles résumer. S’y ajoute une boucle de vérification et de rétroaction, qui permet à l’agent de tester son propre travail et de corriger ses erreurs. Enfin, des garde-fous et un environnement isolé encadrent les permissions de l’agent et exigent une confirmation humaine avant les opérations risquées.

Une analogie simple

On peut imaginer le modèle comme un cheval puissant mais qui pourrait s’emballer. Le harnais est l’équipement complet : la selle, le mors et les rênes. Il ne change pas la force du cheval, mais il permet au cavalier de contrôler sa direction et son allure, de le faire tirer un chariot en sécurité vers la destination voulue au lieu de foncer dans le décor.

Les configurations de harnais courantes en 2026

Tous les harnais ne se ressemblent pas. Le choix d’une configuration dépend de l’usage visé, du niveau de contrôle souhaité et du contexte de déploiement. Voici les principales familles que l’on rencontre aujourd’hui, illustrées par des produits ou projets réels.

La première est le harnais en boucle simple, parfois appelé boucle ReAct. Le modèle alterne raisonnement, action et observation, sans planificateur externe ni état persistant sophistiqué. C’est l’approche la plus légère et la plus rapide à mettre en place. Un exemple représentatif est youtu-agent de Tencent Cloud, décrit comme un harnais minimal de tool-calling. Cette configuration convient bien aux tâches courtes et aux prototypes. En revanche, elle dérive facilement sur les tâches longues : sans mécanisme de rappel de l’objectif, l’agent peut s’éloigner du but initial après une dizaine d’actions.

La deuxième famille est le harnais avec planificateur ou superviseur. Un composant séparé établit un plan, surveille son exécution et déclenche une replanification en cas d’échec. C’est la configuration qui gagne en production lorsque la fiabilité prime sur la vitesse. Claude Code d’Anthropic et Deep Agents illustrent bien ce modèle : ils implémentent le motif planification-plus-sandbox de manière suffisamment aboutie pour être recommandés lorsqu’on veut qu’un seul agent termine une tâche de codage de bout en bout de façon fiable.

La troisième famille est le harnais modulaire, où les composants sont interchangeables. OpenCode en est un exemple important : il s’agit d’un backend d’agent de codage qui peut être utilisé comme runtime par d’autres harnais, comme le montre son intégration dans lh-harness aux côtés de Claude Code, Codex CLI et DeepSeek Harness . OpenCode est également à la base de dérivés comme DrizzyAgent, qui étend OpenCode avec une orchestration multi-agents . Cette modularité facilite les tests A/B et l’évolution indépendante de chaque brique.

La quatrième famille est le harnais multi-agents, où plusieurs agents spécialisés collaborent sous la coordination d’un agent manager. MetaGPT en est le représentant historique : il simule une « entreprise logicielle IA » avec des agents qui jouent les rôles de chef de produit, architecte et ingénieur. CrewAI et AgentVerse s’inscrivent dans la même veine. DrizzyAgent, mentionné plus haut, illustre cette approche appliquée au codage avec ses rôles de Coder, Planner, Oracle, Librarian et Atlas . Cette configuration brille lorsque les sous-tâches sont indépendantes et que la spécialisation apporte un gain réel.

La cinquième famille est le harnais de type microkernel ou plan de contrôle. L’idée centrale est de séparer strictement le plan de contrôle (ordonnancement, état, sécurité, mémoire, audit) du plan d’exécution, où les agents sont hébergés dans des sandbox. QM de YCombinator en est un exemple frappant : il fournit une séparation au niveau de l’organisation, où chaque employé, salon Slack et projet dispose de sa propre mémoire, de ses fichiers, de ses identifiants, de ses permissions et de son environnement sandboxé. Cette architecture offre une stabilité de production et un contrôle multi-tenant.

OpenClaw occupe une place particulière dans cette famille. Il ne se présente pas comme un harnais unique mais comme une plateforme d’exécution d’agents qui peut accueillir plusieurs harnais natifs. Sa documentation décrit explicitement un « harnais Codex » qui permet à OpenClaw de déléguer l’exécution à un serveur d’application Codex natif, tout en conservant la maîtrise du plan de contrôle : résolution du fournisseur et du modèle, authentification, budget de contexte, politique d’outils, sandbox et livraison des réponses . OpenClaw propose également un harnais acpx pour les agents compatibles ACP, avec des alias intégrés pour factory-droid, cursor et d’autres . Cette architecture illustre la tendance à traiter le harnais comme un exécuteur interchangeable, branché sur un noyau qui reste stable.

Enfin, une catégorie plus récente mérite d’être mentionnée : le harnais de flux de travail, qui impose une discipline de phases (spécification, conception, implémentation, vérification, intégration) avec un contexte frais à chaque phase et une persistance d’état dans des fichiers explicites. GSD (Get Shit Done) en est l’exemple canonique : il enveloppe une session de codage IA dans un cycle de vie en six étapes, avec un état de projet stocké dans un répertoire versionné qui survit aux réinitialisations de contexte.

Il faut également citer Pi, qui se distingue par une philosophie de « harnais auto-modifiable ». Pi n’est pas seulement un harnais de codage : c’est un environnement que l’agent peut lui-même inspecter et modifier, avec un système de plugins et d’extensions. Son package pi-harness-runtime illustre cette approche en fournissant une configuration runtime complète, avec gestion des clés API, intégrations Telegram, LangChain et PaperClip, et un mécanisme de boucle planificateur-coder-relecteur-fixeur . Dans une interview accordée à InfoQ, les créateurs de Pi décrivent leur outil comme « une preuve de concept d’un logiciel agentique auto-modifiable », et citent DeepSeek Harness comme une inspiration conceptuelle sur cette même voie . Un package communautaire comme @minhduydev/pi-harness pousse la logique plus loin en proposant un harnais portable avec extensions, compétences, modèles de prompts et thèmes, ainsi qu’un contrat de coordination gouverné pour les sous-agents .

Un point important

Le harnais ne consiste pas à corriger ponctuellement un problème en modifiant une invite. Son objectif central est de corriger une erreur commise par l’IA en modifiant son environnement d’exécution, de sorte que cette erreur ne puisse plus se reproduire. C’est pourquoi on considère souvent que la qualité du harnais détermine le degré de maturité d’un modèle dans des scénarios complexes. Une étude arXiv de 2026 va plus loin : le choix du harnais expliquerait une part plus importante de la variance des résultats aux benchmarks d’agents que le choix du modèle lui-même. Autrement dit, à modèle égal, un bon harnais fait une différence mesurable.
Tutoriel Linux : développement web avec backend en langage C (Episode 8 – Génération de page HTML / CSS / Javascript en C)

Comme on l’a vu dans l’épisode précédent, le script en C qui traite les données envoyées par le formulaire suit 4 étapes :

  1. Recevoir et lire les données brutes envoyées par le formulaire
  2. Retraiter ces données pour qu’elles soient exploitables
  3. Effectuer les traitements requis
  4. Produire et renvoyer une page HTML de réponse

Dans cet épisode nous allons nous intéresser à l’étape 4.

Vous n’y coupez pas, si votre code C doit écrire une page HTML / CSS / Javascript via des printfs, vous devez maîtriser les langages HTML, CSS et Javascript. Ou maîtriser une IA.

Personnellement je n’aime pas particulièrement cette partie, alors je demande à une IA gratuite (DeepSeek en ce qui me concerne) de me générer un couple index.html / styles.css qui donne un look moderne aux widgets (boutons, zones de saisie de texte, zone de saisie de mot de passe, boutons radio, cases à cocher, etc).

Une fois que le fichier styles.css contient le look pile poil aux petits oignons pour tous les widgets, l’IA me génère le fichier index.html qui montre comment invoquer chaque widget dans ce look. Après au niveau du programme en C ce n’est plus que de l’assemblage de lego.

Voici par exemple la page d’accueil de mon réseau social entièrement codé en C, utilisant un look Matrix concocté par DeepSeek :

Sans aller dans un extrême psychédélique comme celui ci-dessus, voici ci-dessous par exemple une page HTML / CSS d’exemple au look moderne, générée par DeepSeek, que j’utilise dans d’autres projets en C :

L’analyse du code source de index.html montre par exemple comment générer en C la zone de saisie de texte « Votre adresse email » :

printf(\"<div class=\"input-group\">\n\
                    <span class=\"input-icon\">✉️</span>\n\
                    <input type=\"email\" name=\"email\" placeholder=\"Votre adresse email\" class=\"input-field\" required>\n\
                </div>\n");

Vous voyez le principe ? Je n’invente rien, mes scripts C ne font qu’afficher via printf ce que l’IA dit qu’il faut afficher pour avoir la zone de saisie de texte dans le look moderne souhaité.

Tutoriel Linux : développement web avec backend en langage C (Episode 7 – Structure type d’un script en C)

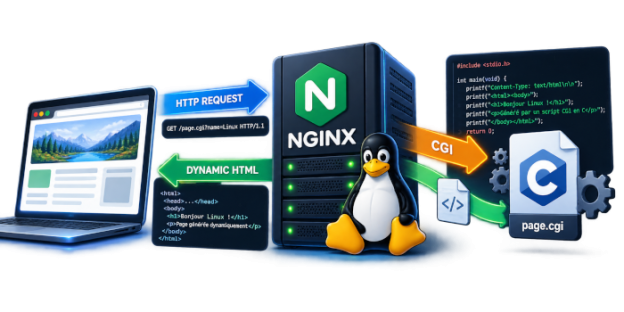
Comme nous l’avons vu dans les épisodes précédents, la mécanique est de coupler un formulaire (form) HTML rempli par le client, envoyé au serveur NginX qui renvoie lui-même les données à un script de traitement, que nous ambitionnons d’écrire en langage C.

Ce script aura toujours la même structure :

  1. Recevoir et lire les données brutes envoyées par le formulaire
  2. Retraiter ces données pour qu’elles soient exploitables
  3. Effectuer les traitements requis
  4. Produire et renvoyer une page HTML de réponse

Pour faire tout cela, nous allons utiliser la librairie climb téléchargeable ici.

Recevoir et lire les données brutes envoyées par le formulaire

Voici le code type :

int main()
{
char *request_body;
char *parametre1;
int nb;

request_body=climb_http_post_request_body();
parametre1=(char *)malloc(strlen(request_body));
nb=climb_http_request_body_items_number(request_body);
if(nb>0) climb_http_request_body_item(request_body,1,parametre1);
}

climb_http_post_request_body lit la chaine de caractères brute reçue du formulaire du client

climb_http_request_body_items_number compte le nombre de champs qu’il y a dans cette chaine de caractères brute (ie le nombre d’items renseignés par le client dans le formulaire)

climb_http_request_body_item recopie dans parametre1 la valeur du champ n (ici n=1 donc c’est le dernier champ, 2 pour l’avant dernier, etc.)

Notez comment la variable parametre1 est initialisée : par malloc sur la taille complète de la chaine reçue. C’est un moyen très simple mais pourtant très efficace de ne pas être attaqué par débordement de tampon.

Retraiter ces données pour qu’elles soient exploitables

Comme on l’a vu dans les épisodes précédents, la chaine de caractères envoyée par le formulaire est codée selon les codages HTML, ce qui signifie que ce que le script C reçoit n’a plus que peu à voir avec ce que l’utilisateur a tapé dans son formulaire.

Pour retrouver ce que l’utilisateur a tapé, notre programme C va donc maintenant exécuter :

climb_http_translate(parametre1);

Cette fonction permet à la fois de retrouver ce qu’a tapé l’utilisateur mais empêche également les attaques de type XSS (Cross site scripting).

Effectuer les traitements requis

Nous avons vu dans l’épisode 6 comment notre programme C peut interférer avec une base de données MySQL. Comme mentionné, pour faire cela il faut connaître un minimum les requêtes SQL : nous en verrons le B-A-BA dans un épisode ultérieur.

La librairie climb ne fournit pas que des fonctions utiles au dialogue avec MySQL. Il y aussi :

Une fonction pour hacher une chaine de caractères, que nous utiliserons pour stocker les mots de passe en base de données. Vous savez déjà en effet qu’un mot de passe ne se stocke jamais en clair, mais haché :

void climb_sha56_hash(char *string); 

climb fournit aussi des fonctions utiles pour la gestion du temps, du format JSON, des sémaphores et des cookies HTML :

// Time functions
int climb_time_dayoftheweek(char * date_string);
void climb_time_zeroize(int num, char *out_string);

// JSON functions
struct json_response *climb_json_init();
void climb_json_status_seterror(struct json_response *jr, char *errorstatus);
void climb_json_status_unseterror(struct json_response *jr);
void climb_json_data_record_add_keyvalue_(struct json_response *jr, char *key, char *value);
void climb_json_data_add_record_(struct json_response *jr);
void climb_json_response_(struct json_response *jr);

// Semaphore functions
void climb_semaphore_init(int *sem, int pack);
int climb_semaphore_get(int *sem, int pack);
void climb_semaphore_take_token(int *sem);
void climb_semaphore_release_token(int *sem);

// Cookies functions
int climb_cookies_get_how_many(char *chaine);
int climb_cookies_get_cookie_name(char *chain,int pos,char *result);
int climb_cookies_get_cookie_value(char *chain,int pos,char *result);
int climb_cookies_is_cookie_present(char *chain, char *name); // returns cookie position if yes, -1 otherwise

Produire et renvoyer une page HTML de réponse

Pour envoyer une réponse au client web, le script en C a juste à faire des printf puisque sa sortie standard est de facto connectée à NginX, qui sert de passe plat vers le navigateur du client.

Cependant, il faut veiller à ce que la première partie de la réponse soit :

printf("Content-type: text/html\n\n");

En effet, sans cet entête la réponse HTML envoyée par notre programme ne sera pas considérée comme valide.

De même, si notre script en C devait répondre en JSON et non en HTML, l’entête devra obligatoirement être :

Content-Type: application/json 

Pour info, c’est déjà ce qu’envoie la fonction :

void climb_http_response_init();

Une fois envoyé l’entête HTML, le script en C doit construire une page de réponse en HTML5 / CSS / Javascript, ou utiliser un framework (j’ai longtemps utilisé JQUERY MOBILE mais il est désuet).

Généralement je travaille un look moderne de page avec une IA comme DeepSeek, et l’IA me génère le fichier styles.css aux petits oignons que j’utilise ensuite dans mes réponses en C.

Conclusion

Au final on voit qu’avec la librairie climb tout est super simple : 4 fonctions pour lire l’entrée, quelques fonctions bien senties pour faciliter les traitements, et de simples printf en sortie pour générer la réponse.

Cours Microsoft gratuit en 18 leçons en français pour apprendre l’IA (spécial débutants)

Joignez l’utile à l’agréable, c’est gratuit et en français 😎

Si l’audio des vidéos est en anglais, vous pouvez la basculer en français dans la fenêtre de chaque vidéo.

Leçon 1 : Introduction aux agents IA et cas d’utilisation des agents

Introduction aux agents IA et cas d’utilisation des agents

Leçon 2 : Exploration des cadres agentiques IA

Exploration des cadres agentiques IA

Leçon 3 : Compréhension des modèles de conception agentique IA

Compréhension des modèles de conception agentique IA

Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 6 – Dialogue avec MySQL depuis un programme en C)

Le backend d’une application web doit très souvent stocker et lire des données dans une base de données. Souvent cette base de données fonctionne avec SQL, et parfois il s’agit de MySQL.

Je vais présenter ci-dessous les 7 fonctions que j’utilise en langage C pour accéder à une base MySQL située sur la même machine que le script C de backend.

J’ai mis ces fonctions dans un fichier climb.h et climb.c, dans lesquels il y a des fonctions relatives à beaucoup d’autres sujets, mais aussi les fonctions relatives au dialogue avec MySQL.

La librairie CLIMB (C LIbrary for Modern Backends)

CLIMB est donc la librairie qui regroupe toutes les fonctions utiles perso que j’utilise.

Voici les fonctions utiles, déclarées dans climb.h :

// MySQL functions
#define _MYSQL

typedef struct CLIMB_MYSQL_RESULT_STRUCT CLIMB_MYSQL_RESULT_STRUCT;
typedef CLIMB_MYSQL_RESULT_STRUCT *CLIMB_MYSQL_DBRESULT;

#define CLIMB_MYSQL_DBHANDLER MYSQL *
#define CLIMB_MYSQL_DBSTMT MYSQL_STMT *

CLIMB_MYSQL_DBHANDLER climb_mysql_opendatabase(char *databasename, char *host, char *login, char *password);
int climb_mysql_ntuples(CLIMB_MYSQL_DBRESULT result);
void climb_mysql_clear_result(CLIMB_MYSQL_DBRESULT result);
void climb_mysql_closedatabase(CLIMB_MYSQL_DBHANDLER handler);
void climb_mysql_getvalue(CLIMB_MYSQL_DBRESULT result, int row, int col, char *value, int max);
CLIMB_MYSQL_DBRESULT climb_mysql_query_prepare(CLIMB_MYSQL_DBHANDLER handler, char *query);
CLIMB_MYSQL_DBRESULT climb_mysql_do_query(int nparams, ...);

climb_mysql_opendatabase : ouvre une connexion avec la base MySQL dont le nom est databasename, située sur la machine dont le nom DNS est host (donc localhost pour nous), dont l’utilisateur propriétaire s’appelle login, et son mot de passe password. Si elle réussit, cette fonction ramène un handler qui permet de poursuivre le dialogue.

climb_mysql_query_prepare : prépare une requête query (préparée donc) pour la base de données ouverte (handler).

climb_mysql_do_query : envoie une quantité de nparams paramètres à la requête préparée par climb_mysql_query_prepare, et exécute cette requête SQL. Cette fonction ramène un résultat result.

climb_mysql_ntuples : compte le nombre de lignes (enregistrements) résultats de l’exécution de la requête.

climb_mysql_getvalue : récupère dans la variable value (de taille max) l’enregistrement de ligne row et de colonne col de la requête dont le résultat a été mis dans result.

climb_mysql_clear_result : ferme la requête courante pour permettre de passer ensuite une nouvelle requête.

climb_mysql_closedatabase : ferme la connexion à la base ouverte (handler).

Voici le code source ce ces fonctions dans climb.c :

Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 5 – Installation et configuration de MySQL)

Rares sont les applications web qui n’ont pas besoin de stocker des données dans une base de données. Bien que ce soit PostgreSQL qui ait le vent en poupe, je préfère personnellement utiliser MySQL, ou sa version communautaire MariaDB (MySQL ayant été acheté par Oracle). Elle s’installe et se configure facilement sous Linux, et surtout elle est facile à interférer avec depuis un programme en langage C.

Installation de MySQL sous Ubuntu

sudo apt update
sudo apt install mysql-server mysql-client libmysqlclient-dev

mysql-server est un paquet générique qui installe la dernière version en vigueur du serveur de base de données

mysql-client est un paquet qui installe la commande mysql, qui permet de se connecter au SGBD à la main

libmysqlclient-dev installe un paquet qui fournit ce qu’il faut pour se connecter à MySQL depuis un programme en C

Configuration initiale de MySQL (à faire une seule fois)

Une fois les paquets installés, on lance la sécurisation de MySQL par :

sudo mysql_secure_installation

Ce programme va poser des questions auxquelles il faut répondre. Il faudra notamment donner le mot de passe MySQL de root qu’on choisit, confirmer la suppression des utilisateurs anonymes et des bases de test, et désactiver la connexion à distance de root.

Ensuite on va permettre à root de se connecter facilement. Pour faire ce paramétrage, on tape dans le shell la commande :

sudo mysql

On arrive dans le shell de mysql, dans lequel on tape (remplacer le mot de passe par celui que vous avez choisi pour root) :

ALTER USER 'root'@'localhost' IDENTIFIED WITH caching_sha2_password BY 'VotreMotDePasseDeRoot';

FLUSH PRIVILEGES;

EXIT;

Désormais MySQL est configuré et root peut s’y connecter en tapant la commande :

mysql -u root -p mysql

Cette commande se lit : lancer l’utilitaire mysql (qui est le client MySQL) en utilisant l’utilisateur (-u) root, en demandant le mot de passe (-p) et si l’identification est ok, le connecter à la base mysql (qui est mentionnée derrière -p).

Créer une base de données et un utilisateur pour une future application en C

Maintenant que MySQL est opérationnel, on peut y créer autant de base de données, et d’utilisateurs propriétaires de ces bases de données, que l’on veut.

Chaque application web aura sa base de données (utilisable en lecture et écriture depuis ses scripts en C, on verra par la suite comment faire), et son utilisateur propriétaire de cette base de données.

Imaginons que notre application s’appelle tartemuche. On va donc créer une base de données tartemuche, un utilisateur local (uniquement, il ne pourra pas se connecter à distance par sécurité. Les scripts en C devront donc tourner sur le même serveur que celui qui héberge MySQL) tartemuche qui aura tous les droits sur la base de données tartemuche et qui aura comme mot de passe de connexion à cette base de données tartemolle.

Voyons comment préparer cela. Tout d’abord on se connecte en tant que root à la base de données mysql :

Continuer la lecture →

Ginux : le père de CentOS fait bosser une IA pour produire un noyau Rust expérimental compatible Linux (rapport inclus en français)

Ginux est un prototype de recherche de noyau indépendant, écrit principalement en Rust, dont l’objectif est de permettre l’exécution de programmes en espace utilisateur Linux sans s’appuyer sur le noyau Linux. Il ne s’agit ni d’une distribution Linux, ni d’un fork du noyau Linux. Le projet a été annoncé le 27 octobre 2026 par Gregory Kurtzer, fondateur de CentOS et Rocky Linux. Son objectif principal n’est pas de remplacer Linux, mais de vérifier si un ingénieur expérimenté, assisté par un agent d’IA, peut construire et valider un système logiciel de complexité extrême en très peu de temps.

Origine du projet et méthode de développement

Le nom « Ginux » est une combinaison de GPT/Greg et Linux. Kurtzer a défini l’architecture, les contraintes, les jalons et les critères d’acceptation, puis a utilisé OpenAI Codex (modèle GPT-5.6 Sol) pour exécuter une tâche de codage persistante. L’agent d’IA a été chargé de l’implémentation, de la compilation, des tests de démarrage, du diagnostic et des corrections, produisant finalement environ 139 000 lignes de code conservées. Kurtzer appelle cette méthode Human-Directed Agentic Engineering (HDAE) et a publié un rapport technique sur Zenodo. Le coût estimé des appels API est d’environ 8 000 dollars.

Voici ce rapport traduit en français :

Architecture technique : noyau indépendant, et non fork de Linux

Ginux est un noyau indépendant pour l’architecture x86-64, démarrant directement via UEFI. Il implémente lui-même la gestion de la mémoire, l’ordonnanceur, le modèle de processus, le système de fichiers virtuel, la pile réseau et une partie du support des périphériques. Linux n’y existe que sous forme de « personnalité » (personality), c’est-à-dire une couche de compatibilité vers laquelle les programmes en espace utilisateur émettent des appels système.

Le noyau, le plan de contrôle d’administration et les composants de démarrage sont empaquetés dans un unique fichier GINUX.EFI, le plan de contrôle s’exécutant en espace utilisateur (ring 3). L’environnement de validation actuel se limite à la machine virtuelle QEMU (profil Q35, OVMF, Intel IOMMU, périphériques virtio), fonctionnant avec KVM sur un hôte Linux x86-64 ou en émulation TCG sur Mac Apple Silicon.

Compatibilité Linux : implémentation partielle avec frontières explicites

Selon le registre des appels système de Linux 6.12 x86-64 publié par le projet, sur les 375 numéros d’appels système :

ÉtatNombre
Implémentation complète82
Implémentation partielle245
Refus pour raison de politique de sécurité48

Le projet précise explicitement que cette classification signifie uniquement que chaque numéro d’appel système a un mode de traitement défini, et ne représente pas une conformité Linux complète. Les programmes dont l’exécution est vérifiée incluent certains programmes Alpine Linux (chaîne musl/BusyBox) et Rocky Linux (glibc), et permettent à l’espace utilisateur de Rocky Linux 10 avec systemd d’atteindre multi-user.target. Le projet souligne qu’un scénario de test réussi ne constitue qu’une preuve pour ce scénario spécifique et ne garantit pas que n’importe quel binaire ou distribution Linux puisse s’exécuter.

État actuel et limites

Ginux est explicitement positionné comme un prototype de recherche, et non comme un noyau de production ni un substitut à Linux. Les limitations actuelles incluent :

  • Prise en charge matérielle extrêmement limitée : aucun support pour les GPU, NVMe, l’ensemble du matériel physique ou une ABI stable pour les pilotes tiers.
  • Compatibilité incomplète : absence de sysfs compatible Linux, d’ABI cgroups, et de nombreuses opérations de montage/namespace refusées pour raison de politique de sécurité.
  • Isolation non mature : l’isolation des ressources et des périphériques entre domaines présente encore des lacunes sur plusieurs chemins.
  • Tests agrégés non réussis : sur le point de contrôle évalué le 23 octobre 2026, make test n’a pas réussi, la sonde de cycle de vie du superviseur système après execve() continuant d’échouer.
  • Aucun audit de sécurité indépendant : le projet ne prétend pas avoir été audité de manière indépendante ni être prêt pour la production.

En termes de performances, une comparaison préliminaire dans QEMU (1 vCPU, 2 Gio de mémoire, émulation Apple Silicon) montre que Rocky Linux 10 sur Ginux atteint multi-user.target en 12,9 secondes, contre 42,6 secondes avec le noyau Linux. Cependant, Ginux ne charge pas de second noyau ni d’initramfs et restaure un système de fichiers déjà en cache, ce qui rend cette comparaison non équitable. Kurtzer lui-même reconnaît que ces données doivent être refaites sur un hôte Linux x86-64 avec KVM.

Position officielle et perspectives

Kurtzer a clairement déclaré que « le code est jetable » et que « Ginux n’est pas le produit, le processus de développement est l’expérience, le noyau en est la preuve ». Il a également souligné que la valeur de Linux ne réside pas tant dans son code que dans son écosystème : « ce qui est difficile, ce sont les workflows, la compatibilité, la maintenance et la communauté ». Le code est open source sous licence Apache 2.0 et publié sur GitHub.

Article rédigé par l’IA DeepSeek

Tutoriel Linux : développement web avec backend en langage C (Episode 4 – L’extraction et le décodage des données du formulaire)

Dans l’épisode 3 nous avons vu comment coupler un formulaire HTML (form) présenté au client web et rempli par lui, et un script écrit en C qui reçoit et traite ces données.

Nous avons vu que le script en C récupère pour le formulaire une chaine de caractère unique, comme par exemple :

texte=C%27est+une+vir%C3%A9e+ma%C3%A7onnique+v%C3%A9n%C3%A8re+%23%24*&motdepasse=re%C3%A7u

Cette chaine reprend les champs définis par le formulaire (texte et motdepasse) séparés par le caractère &, et les valeurs envoyées par le formulaire pour ces champs (C%27est+une+vir%C3%A9e+ma%C3%A7onnique+v%C3%A9n%C3%A8re+%23%24* pour texte, et re%C3%A7u pour motdepasse).

Ces valeurs doivent maintenant pouvoir être extraites une par une, et surtout doivent pouvoir être retraitées pour que le codage HTML effectué par le navigateur du client soit décodé pour retrouver les frappes exactes réalisées par l’utilisateur.

C’est pourquoi nous allons ajouter quelques fonctions au programme script.c que nous avons vu à l’épisode 3.

Nous allons notamment ajouter la fonction http_request_body_item qui permet de lire la valeur de rang n dans la chaine de caractère unique (n=1 pour la dernière valeur de la chaine, n=2 pour l’avant dernière valeur de la chaine, etc.), et la fonction http_translate qui décode la valeur passée en paramètre.

Voici donc le nouveau programme script.c complet, avec capacité d’extraction et de décodage des champs :

#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <string.h>

char* http_post_request_body()
{
int query_size;

query_size=atoi(getenv("CONTENT_LENGTH"));
char* query_string = (char*) malloc(query_size+10);
if (query_string != NULL) fread(query_string,query_size,1,stdin);
return query_string;
}

int http_request_body_item(char *in_string,int pos,char *out_string)
{
int i,n,start;

i=strlen(in_string);
for(n=0; n<pos;n++) 
	{
	while(in_string[i]!='=') i--;
	i--;
	}
i+=2;
start=i;
do
	{
	out_string[i-start]=in_string[i];
	i++;
	}
while(in_string[i-1]!=0 && in_string[i-1]!='&');
out_string[i-start-1]=0;
}

void http_urldecode(char *string)
{
int i,start;
char *res,buf[50];

start=i=0;
res=(char *)malloc(10*strlen(string));
while(i<=strlen(string))
	{
	if(string[i]!='%') 
		{
		res[start]=string[i];
		i++;
		start++;
		}
	else
		{
		if(string[i+1]=='0' && string[i+2]=='A')
			{
			res[start]='\\';
			res[start+1]='\\';
			res[start+2]='n';
			start = start+3;
			i = i+3;
			}
		else
			{
			if(string[i+1]!='3' || string[i+2]!='C')
				{
				sprintf(buf,"0x%c%c",string[i+1],string[i+2]);
				res[start]=strtol(buf,NULL,16);
				start++;
				i = i+3;
				}
			else
				{
				res[start]='&';
				res[start+1]='l';
				res[start+2]='t';
				res[start+3]=';';
				start = start+4;
				i = i+3;
				}
			}
		}
	}
strcpy(string,res);
free(res);
}

void http_prepare(char *string)
{
int i,start;
char *res;

res=(char *)malloc(strlen(string)*2);
i=start=0;
do
	{
	if(string[i]!=';' && string[i]!='\'' && string[i]!='"') res[start]=string[i];
	else res[start]=' ';
	start++;
	i++;
	}
while(i<=strlen(string));
strcpy(string,res);
free(res);
}

void http_translate(char *in_string)
{
int i;

for(i=0;i<strlen(in_string);i++)
	{
	if(in_string[i]=='+') in_string[i]=' ';
	}
http_urldecode(in_string);
http_prepare(in_string);
}

int main()
{
char *request_body;
extern char **environ;
char **e;
char *texte,*motdepasse;

request_body=http_post_request_body(); // on récupère les données envoyées par le formulaire
// On initialise la taille des deux variables qui vont accueillir les données tapées par l'utilisateur dans le formulaire.
// Cette manière de faire garantit que le débordement de tampon (buffer overflow) sera impossible
texte=(char *)malloc(strlen(request_body));
motdepasse=(char *)malloc(strlen(request_body));
http_request_body_item(request_body,2,texte); // On récupère l'avant dernière (position 2 par rapport à la fin) information brute transmise par le formulaire, donc le texte tapé codé HTML
http_translate(texte); // On réalise le décodage texte tel que l'utilisateur l'a tapé
http_request_body_item(request_body,1,motdepasse); // On récupère la dernière (position 1 par rapport à la fin) information transmise par le formulaire, donc le mot de passe tapé
http_translate(motdepasse);
// on construit maintenant la page html de réponse, en écrivant sur la sortie standard. NginX intercepera cette sortie et l'enverra tout seul au client web
printf("Content-type: text/html\n\n"); // Cette ligne d'entête est fondamentale. Sans elle le format de réponse ne serait pas respecté
printf("<!DOCTYPE html>\n\
<html lang=\"fr\">\n\
<head>\n\
	<meta charset=\"UTF-8\">\n\
    <title>Page de réponse du script</title>\n\
</head>\n\
<body>\n");
printf("Données reçues du formulaire : %s<br>Texte tapé : %s<br>\nMot de passe tapé : %s<br><br>\n",request_body,texte,motdepasse);
printf("Variables d'environnement du formulaire : <br><br>\n");
for(e=environ;*e;e++) printf("%s<br>\n",*e);
printf("</body>\n\
</html>\n");
}

Comme dans l’épisode 3, on le compile et installe par les commandes :

gcc script.c -o script.cgi
sudo cp ./script.cgi /usr/lib/cgi-bin

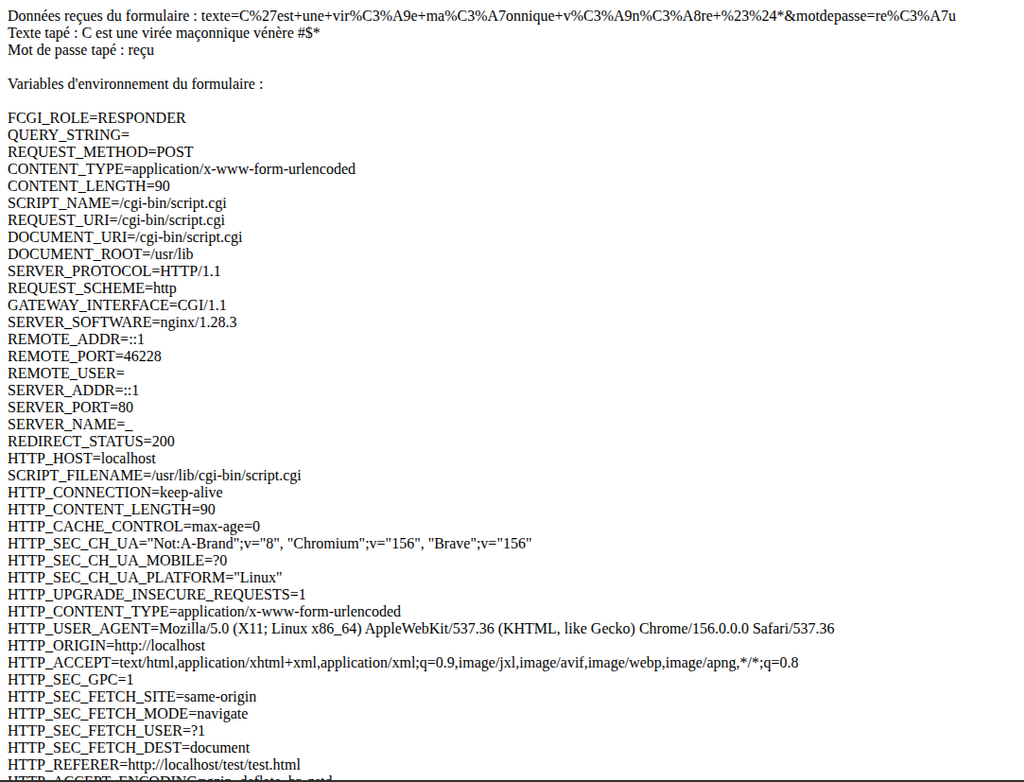
Voici ce que donne la réponse du script en C quand on saisit des données dans le formulaire :

Le script a bien extrait et décodé les données du formulaire puisqu’il affiche :

Texte tapé : C est une virée maçonnique vénère #$*
Mot de passe tapé : reçu

Pour être franc, le script a retiré l’apostrophe de C’est. On peut la garder mais c’est le genre de détail dangereux si le script en C est couplé à une base MySQL (ce qui n’est pas le cas ici), car le maintient de l’apostrophe sans ruser ouvrirait la porte à une attaque par injection SQL.

Il est bien évident que les fonctions C d’extraction et de décodage que nous avons ajoutées seront à utiliser dans tous les futurs scripts. Le réflexe naturel est donc de regrouper ces fonctions dans un fichier C à part, réutilisable.

Si l’on met à part ces fonctions, le corps du script en C restant devient finalement très simple, puisque cela se résume à la fonction main :

int main()
{
char *request_body;
extern char **environ;
char **e;
char *texte,*motdepasse;

request_body=http_post_request_body(); // on récupère les données envoyées par le formulaire
// On initialise la taille des deux variables qui vont accueillir les données tapées par l'utilisateur dans le formulaire.
// Cette manière de faire garantit que le débordement de tampon (buffer overflow) sera impossible
texte=(char *)malloc(strlen(request_body));
motdepasse=(char *)malloc(strlen(request_body));
http_request_body_item(request_body,2,texte); // On récupère l'avant dernière (position 2 par rapport à la fin) information brute transmise par le formulaire, donc le texte tapé codé HTML
http_translate(texte); // On réalise le décodage texte tel que l'utilisateur l'a tapé
http_request_body_item(request_body,1,motdepasse); // On récupère la dernière (position 1 par rapport à la fin) information transmise par le formulaire, donc le mot de passe tapé
http_translate(motdepasse);
// on construit maintenant la page html de réponse, en écrivant sur la sortie standard. NginX intercepera cette sortie et l'enverra tout seul au client web
printf("Content-type: text/html\n\n"); // Cette ligne d'entête est fondamentale. Sans elle le format de réponse ne serait pas respecté
printf("<!DOCTYPE html>\n\
<html lang=\"fr\">\n\
<head>\n\
	<meta charset=\"UTF-8\">\n\
    <title>Page de réponse du script</title>\n\
</head>\n\
<body>\n");
printf("Données reçues du formulaire : %s<br>Texte tapé : %s<br>\nMot de passe tapé : %s<br><br>\n",request_body,texte,motdepasse);
printf("Variables d'environnement du formulaire : <br><br>\n");
for(e=environ;*e;e++) printf("%s<br>\n",*e);
printf("</body>\n\
</html>\n");
}

Dans l’épisode 5 nous verrons un fichier C réutilisable dans les scripts qui contient tout ce dont on a besoin d’y piocher pour gérer les cas de figure les plus courants, et notamment le dialogue avec une base de données MySQL depuis un script en C.

Stay tuned 😎

Tutoriel Linux : développement web avec backend en langage C (Episode 3 – Le couple form / script)

Maintenant que notre serveur NginX est installé et configuré pour être en mesure de transférer les requêtes des clients web aux scripts CGI, nous allons voir dans cet épisode 3 comment se fait ce dialogue entre le client web et le script CGI.

Côté client web : la form

La page web affichée sur le poste client web va utiliser des forms (formulaires HTML en français).

Il s’agit d’un formulaire contenant des items à afficher dans le formulaire (de différents types comme des inputs pour saisir du texte, des boutons radio, des cases à cocher, des zones de saisie de mot de passe, des listes déroulantes, etc.), un script cible (qui pour nous sera écrit en langage C), et un bouton pour activer le formulaire.

Activer le formulaire signifie que le navigateur web du client va lire les données saisies ou choisies par l’utilisateur, et les envoyer au script CGI.

La nature de l’envoi vers le script CGI est indiquée dans le formulaire. Elle peut être GET ou POST.

Si GET est utilisé, les données saisies dans la form seront transmises sur l’URL du script appelé, ce qui n’est pas top pour la sécurité. C’est pourquoi nous utiliserons que la méthode POST, qui envoie les données vers le script dans le flux html, donc non visible des hommes du milieu dès lors qu’on est en https.

Dans l’exemple que nous allons utiliser, voici la page web que l’on affiche sur le client web :

<!DOCTYPE html>
<html lang="fr">
<head>
    <meta charset="UTF-8">
    <title>Formulaire CGI</title>
    <style>
        body { font-family: sans-serif; max-width: 500px; margin: 50px auto; padding: 20px; }
        input[type="text"] { width: 100%; padding: 8px; margin: 10px 0; box-sizing: border-box; }
	input[type="password"] { width: 100%; padding: 8px; margin: 10px 0; box-sizing: border-box; }
        input[type="submit"] { padding: 8px 20px; cursor: pointer; }
        .result { padding: 15px; background: #eef; border-radius: 5px; }
    </style>
</head>
<body>
    <h1>Mon formulaire</h1>
    <form action="/cgi-bin/script.cgi" method="post">
        <label for="texte">Entrez votre texte :</label>
        <input type="text" placeholder="Entrez du texte ici" id="texte" name="texte" required>
	<input type="password" placeholder="Entrez un mot de passe ici" id="mdp" name="motdepasse" required>
        <input type="submit" value="Envoyer">
    </form>
</body>
</html>

Cette page web comporte un petit script CSS pour l’esthétique, mais surtout elle contient une form (visible en gras), dans laquelle on voit que le formulaire contient comme items à afficher un label (du texte), un input requis (ie on ne pourra pas déclencher le formulaire si ce champ est vide) pour saisir du texte, un mot de passe, et un bouton submit pour déclencher le formulaire.

Comme on peut le voir, ce formulaire a pour cible le script dont l’URL est /cgi-bin/script.cgi en utilisant la méthode POST.

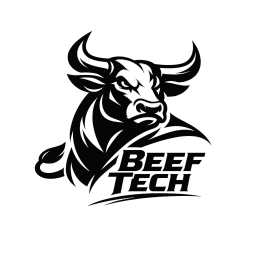
On met ce fichier test.html dans /var/www/html sur le serveur web, ce qui affiche la page suivante sur le navigateur du client lorsqu’il se connecte sur cette URL https://serveur/test.html :

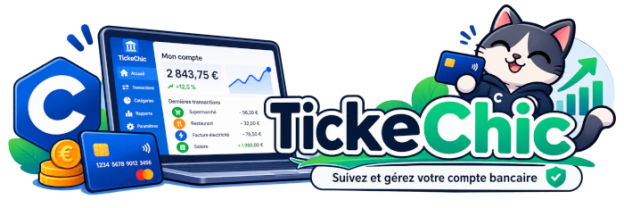
Voici ce qui s’affiche quand l’utilisateur saisit les données :

Continuer la lecture →