Archives de catégorie : Culture

Qu’est-ce qu’un harnais en IA ?

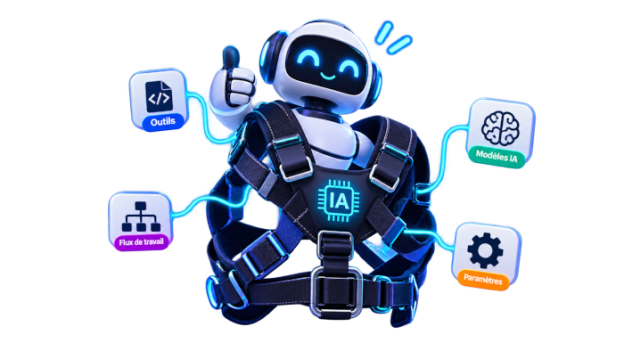
Dans le domaine de l’intelligence artificielle, le terme harnais (harness en anglais) désigne la couche logicielle qui entoure un grand modèle de langage pour le transformer en un agent capable d’exécuter réellement des tâches. Une formule résume bien cette idée : Agent = Modèle + Harnais.

Pourquoi est-ce nécessaire

Un modèle de langage brut, comme GPT ou Claude, est un cerveau très performant mais isolé. Il ne peut que générer du texte, ne se souvient de rien d’une session à l’autre et n’agit sur rien. Le harnais joue le rôle de système nerveux et de manuel d’utilisation. Il fournit au modèle des données à consulter, des outils à manipuler et des règles à respecter. C’est ce qui lui permet de passer de la capacité à parler à la capacité à agir.

Ce que contient concrètement un harnais

Un harnais complet comprend généralement plusieurs composants. D’abord une invite système, qui définit le rôle de l’agent, ses objectifs et les règles qu’il doit suivre en permanence. Ensuite des outils et un mécanisme d’exécution : le modèle décide quoi faire, le harnais se charge d’exécuter l’action réelle, comme un appel d’API ou l’exécution de code, puis renvoie le résultat au modèle. Vient également la gestion de la mémoire et du contexte, qui détermine quelles informations conserver et lesquelles résumer. S’y ajoute une boucle de vérification et de rétroaction, qui permet à l’agent de tester son propre travail et de corriger ses erreurs. Enfin, des garde-fous et un environnement isolé encadrent les permissions de l’agent et exigent une confirmation humaine avant les opérations risquées.

Une analogie simple

On peut imaginer le modèle comme un cheval puissant mais qui pourrait s’emballer. Le harnais est l’équipement complet : la selle, le mors et les rênes. Il ne change pas la force du cheval, mais il permet au cavalier de contrôler sa direction et son allure, de le faire tirer un chariot en sécurité vers la destination voulue au lieu de foncer dans le décor.

Les configurations de harnais courantes en 2026

Tous les harnais ne se ressemblent pas. Le choix d’une configuration dépend de l’usage visé, du niveau de contrôle souhaité et du contexte de déploiement. Voici les principales familles que l’on rencontre aujourd’hui, illustrées par des produits ou projets réels.

La première est le harnais en boucle simple, parfois appelé boucle ReAct. Le modèle alterne raisonnement, action et observation, sans planificateur externe ni état persistant sophistiqué. C’est l’approche la plus légère et la plus rapide à mettre en place. Un exemple représentatif est youtu-agent de Tencent Cloud, décrit comme un harnais minimal de tool-calling. Cette configuration convient bien aux tâches courtes et aux prototypes. En revanche, elle dérive facilement sur les tâches longues : sans mécanisme de rappel de l’objectif, l’agent peut s’éloigner du but initial après une dizaine d’actions.

La deuxième famille est le harnais avec planificateur ou superviseur. Un composant séparé établit un plan, surveille son exécution et déclenche une replanification en cas d’échec. C’est la configuration qui gagne en production lorsque la fiabilité prime sur la vitesse. Claude Code d’Anthropic et Deep Agents illustrent bien ce modèle : ils implémentent le motif planification-plus-sandbox de manière suffisamment aboutie pour être recommandés lorsqu’on veut qu’un seul agent termine une tâche de codage de bout en bout de façon fiable.

La troisième famille est le harnais modulaire, où les composants sont interchangeables. OpenCode en est un exemple important : il s’agit d’un backend d’agent de codage qui peut être utilisé comme runtime par d’autres harnais, comme le montre son intégration dans lh-harness aux côtés de Claude Code, Codex CLI et DeepSeek Harness . OpenCode est également à la base de dérivés comme DrizzyAgent, qui étend OpenCode avec une orchestration multi-agents . Cette modularité facilite les tests A/B et l’évolution indépendante de chaque brique.

La quatrième famille est le harnais multi-agents, où plusieurs agents spécialisés collaborent sous la coordination d’un agent manager. MetaGPT en est le représentant historique : il simule une « entreprise logicielle IA » avec des agents qui jouent les rôles de chef de produit, architecte et ingénieur. CrewAI et AgentVerse s’inscrivent dans la même veine. DrizzyAgent, mentionné plus haut, illustre cette approche appliquée au codage avec ses rôles de Coder, Planner, Oracle, Librarian et Atlas . Cette configuration brille lorsque les sous-tâches sont indépendantes et que la spécialisation apporte un gain réel.

La cinquième famille est le harnais de type microkernel ou plan de contrôle. L’idée centrale est de séparer strictement le plan de contrôle (ordonnancement, état, sécurité, mémoire, audit) du plan d’exécution, où les agents sont hébergés dans des sandbox. QM de YCombinator en est un exemple frappant : il fournit une séparation au niveau de l’organisation, où chaque employé, salon Slack et projet dispose de sa propre mémoire, de ses fichiers, de ses identifiants, de ses permissions et de son environnement sandboxé. Cette architecture offre une stabilité de production et un contrôle multi-tenant.

OpenClaw occupe une place particulière dans cette famille. Il ne se présente pas comme un harnais unique mais comme une plateforme d’exécution d’agents qui peut accueillir plusieurs harnais natifs. Sa documentation décrit explicitement un « harnais Codex » qui permet à OpenClaw de déléguer l’exécution à un serveur d’application Codex natif, tout en conservant la maîtrise du plan de contrôle : résolution du fournisseur et du modèle, authentification, budget de contexte, politique d’outils, sandbox et livraison des réponses . OpenClaw propose également un harnais acpx pour les agents compatibles ACP, avec des alias intégrés pour factory-droid, cursor et d’autres . Cette architecture illustre la tendance à traiter le harnais comme un exécuteur interchangeable, branché sur un noyau qui reste stable.

Enfin, une catégorie plus récente mérite d’être mentionnée : le harnais de flux de travail, qui impose une discipline de phases (spécification, conception, implémentation, vérification, intégration) avec un contexte frais à chaque phase et une persistance d’état dans des fichiers explicites. GSD (Get Shit Done) en est l’exemple canonique : il enveloppe une session de codage IA dans un cycle de vie en six étapes, avec un état de projet stocké dans un répertoire versionné qui survit aux réinitialisations de contexte.

Il faut également citer Pi, qui se distingue par une philosophie de « harnais auto-modifiable ». Pi n’est pas seulement un harnais de codage : c’est un environnement que l’agent peut lui-même inspecter et modifier, avec un système de plugins et d’extensions. Son package pi-harness-runtime illustre cette approche en fournissant une configuration runtime complète, avec gestion des clés API, intégrations Telegram, LangChain et PaperClip, et un mécanisme de boucle planificateur-coder-relecteur-fixeur . Dans une interview accordée à InfoQ, les créateurs de Pi décrivent leur outil comme « une preuve de concept d’un logiciel agentique auto-modifiable », et citent DeepSeek Harness comme une inspiration conceptuelle sur cette même voie . Un package communautaire comme @minhduydev/pi-harness pousse la logique plus loin en proposant un harnais portable avec extensions, compétences, modèles de prompts et thèmes, ainsi qu’un contrat de coordination gouverné pour les sous-agents .

Un point important

Le harnais ne consiste pas à corriger ponctuellement un problème en modifiant une invite. Son objectif central est de corriger une erreur commise par l’IA en modifiant son environnement d’exécution, de sorte que cette erreur ne puisse plus se reproduire. C’est pourquoi on considère souvent que la qualité du harnais détermine le degré de maturité d’un modèle dans des scénarios complexes. Une étude arXiv de 2026 va plus loin : le choix du harnais expliquerait une part plus importante de la variance des résultats aux benchmarks d’agents que le choix du modèle lui-même. Autrement dit, à modèle égal, un bon harnais fait une différence mesurable.
Cours Microsoft gratuit en 18 leçons en français pour apprendre l’IA (spécial débutants)

Joignez l’utile à l’agréable, c’est gratuit et en français 😎

Si l’audio des vidéos est en anglais, vous pouvez la basculer en français dans la fenêtre de chaque vidéo.

Leçon 1 : Introduction aux agents IA et cas d’utilisation des agents

Introduction aux agents IA et cas d’utilisation des agents

Leçon 2 : Exploration des cadres agentiques IA

Exploration des cadres agentiques IA

Leçon 3 : Compréhension des modèles de conception agentique IA

Compréhension des modèles de conception agentique IA

Continuer la lecture →

Ginux : le père de CentOS fait bosser une IA pour produire un noyau Rust expérimental compatible Linux (rapport inclus en français)

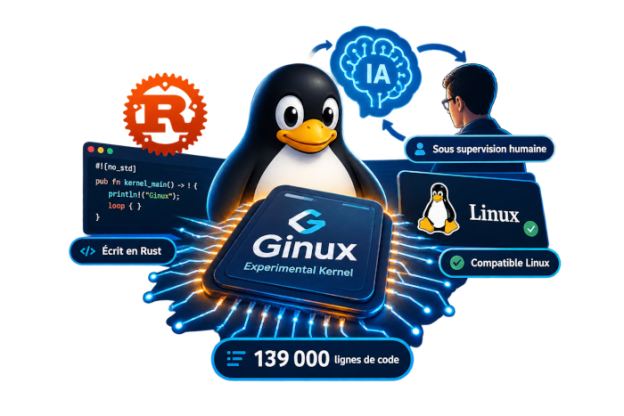
Ginux est un prototype de recherche de noyau indépendant, écrit principalement en Rust, dont l’objectif est de permettre l’exécution de programmes en espace utilisateur Linux sans s’appuyer sur le noyau Linux. Il ne s’agit ni d’une distribution Linux, ni d’un fork du noyau Linux. Le projet a été annoncé le 27 octobre 2026 par Gregory Kurtzer, fondateur de CentOS et Rocky Linux. Son objectif principal n’est pas de remplacer Linux, mais de vérifier si un ingénieur expérimenté, assisté par un agent d’IA, peut construire et valider un système logiciel de complexité extrême en très peu de temps.

Origine du projet et méthode de développement

Le nom « Ginux » est une combinaison de GPT/Greg et Linux. Kurtzer a défini l’architecture, les contraintes, les jalons et les critères d’acceptation, puis a utilisé OpenAI Codex (modèle GPT-5.6 Sol) pour exécuter une tâche de codage persistante. L’agent d’IA a été chargé de l’implémentation, de la compilation, des tests de démarrage, du diagnostic et des corrections, produisant finalement environ 139 000 lignes de code conservées. Kurtzer appelle cette méthode Human-Directed Agentic Engineering (HDAE) et a publié un rapport technique sur Zenodo. Le coût estimé des appels API est d’environ 8 000 dollars.

Voici ce rapport traduit en français :

Architecture technique : noyau indépendant, et non fork de Linux

Ginux est un noyau indépendant pour l’architecture x86-64, démarrant directement via UEFI. Il implémente lui-même la gestion de la mémoire, l’ordonnanceur, le modèle de processus, le système de fichiers virtuel, la pile réseau et une partie du support des périphériques. Linux n’y existe que sous forme de « personnalité » (personality), c’est-à-dire une couche de compatibilité vers laquelle les programmes en espace utilisateur émettent des appels système.

Le noyau, le plan de contrôle d’administration et les composants de démarrage sont empaquetés dans un unique fichier GINUX.EFI, le plan de contrôle s’exécutant en espace utilisateur (ring 3). L’environnement de validation actuel se limite à la machine virtuelle QEMU (profil Q35, OVMF, Intel IOMMU, périphériques virtio), fonctionnant avec KVM sur un hôte Linux x86-64 ou en émulation TCG sur Mac Apple Silicon.

Compatibilité Linux : implémentation partielle avec frontières explicites

Selon le registre des appels système de Linux 6.12 x86-64 publié par le projet, sur les 375 numéros d’appels système :

ÉtatNombre
Implémentation complète82
Implémentation partielle245
Refus pour raison de politique de sécurité48

Le projet précise explicitement que cette classification signifie uniquement que chaque numéro d’appel système a un mode de traitement défini, et ne représente pas une conformité Linux complète. Les programmes dont l’exécution est vérifiée incluent certains programmes Alpine Linux (chaîne musl/BusyBox) et Rocky Linux (glibc), et permettent à l’espace utilisateur de Rocky Linux 10 avec systemd d’atteindre multi-user.target. Le projet souligne qu’un scénario de test réussi ne constitue qu’une preuve pour ce scénario spécifique et ne garantit pas que n’importe quel binaire ou distribution Linux puisse s’exécuter.

État actuel et limites

Ginux est explicitement positionné comme un prototype de recherche, et non comme un noyau de production ni un substitut à Linux. Les limitations actuelles incluent :

  • Prise en charge matérielle extrêmement limitée : aucun support pour les GPU, NVMe, l’ensemble du matériel physique ou une ABI stable pour les pilotes tiers.
  • Compatibilité incomplète : absence de sysfs compatible Linux, d’ABI cgroups, et de nombreuses opérations de montage/namespace refusées pour raison de politique de sécurité.
  • Isolation non mature : l’isolation des ressources et des périphériques entre domaines présente encore des lacunes sur plusieurs chemins.
  • Tests agrégés non réussis : sur le point de contrôle évalué le 23 octobre 2026, make test n’a pas réussi, la sonde de cycle de vie du superviseur système après execve() continuant d’échouer.
  • Aucun audit de sécurité indépendant : le projet ne prétend pas avoir été audité de manière indépendante ni être prêt pour la production.

En termes de performances, une comparaison préliminaire dans QEMU (1 vCPU, 2 Gio de mémoire, émulation Apple Silicon) montre que Rocky Linux 10 sur Ginux atteint multi-user.target en 12,9 secondes, contre 42,6 secondes avec le noyau Linux. Cependant, Ginux ne charge pas de second noyau ni d’initramfs et restaure un système de fichiers déjà en cache, ce qui rend cette comparaison non équitable. Kurtzer lui-même reconnaît que ces données doivent être refaites sur un hôte Linux x86-64 avec KVM.

Position officielle et perspectives

Kurtzer a clairement déclaré que « le code est jetable » et que « Ginux n’est pas le produit, le processus de développement est l’expérience, le noyau en est la preuve ». Il a également souligné que la valeur de Linux ne réside pas tant dans son code que dans son écosystème : « ce qui est difficile, ce sont les workflows, la compatibilité, la maintenance et la communauté ». Le code est open source sous licence Apache 2.0 et publié sur GitHub.

Article rédigé par l’IA DeepSeek

Tutoriel Linux : passer de docker à podman

Podman est un moteur de conteneurs développé par Red Hat à partir de 2017.

Sa différence fondamentale avec Docker ne réside pas dans les commandes, mais dans l’architecture.

Docker repose sur un démon qui tourne en permanence avec les privilèges root, et c’est ce service en arrière-plan qui crée et supervise les conteneurs. Podman fonctionne lui sur un modèle fork-exec : lorsque vous tapez une commande, il appelle directement le runtime OCI pour lancer le conteneur, et le processus du conteneur devient un enfant de Podman lui-même. Cette conception réduit la surface d’attaque puisqu’il n’y a pas de service root résident à compromettre, et elle fait du mode rootless le comportement par défaut.

Red Hat a développé Podman précisément parce que l’architecture de Docker posait problème dans les environnements de production critiques. Le démon Docker, constamment actif et disposant des droits root, constitue un point de défaillance unique et une cible de choix pour un attaquant. Podman élimine ce niveau intermédiaire : chaque conteneur est lancé par le processus utilisateur lui-même, ce qui signifie qu’une évasion de conteneur ne donne accès qu’aux droits de cet utilisateur, pas à ceux du système entier.

Sur le plan des parts de marché, Docker reste largement dominant. L’enquête Stack Overflow de 2025 indiquait que 71,1 % des développeurs utilisaient intensivement Docker, contre 11,1 % pour Podman. Ce dernier progresse toutefois rapidement, passant d’environ 5 % en 2024 à 11,1 % en 2025. Dans les environnements d’entreprise, sa part est plus élevée, estimée entre 19 et 23 %, portée par des exigences de sécurité, l’absence de coût de licence et son intégration native avec Red Hat Enterprise Linux et OpenShift.

Installation et utilisation de Podman

Sur Ubuntu 26.04, Podman est disponible directement dans les dépôts officiels.

sudo apt update
sudo apt install podman -y

Vérifiez que l’installation s’est bien déroulée.

podman --version
Continuer la lecture →

Linux : Gnome moderne et véloce sur un vieux PC avec Devuan

Vous avez un vieux PC, qui tourne sous Ubuntu, et vous constatez que, version après version, Ubuntu est de plus en plus lent. Vous êtes pourtant contraint de migrer car la durée de vie des versions d’Ubuntu, même LTS, est finalement assez courte.

Au final, années après années, votre PC sous Ubuntu devient plus lent, limite presqu’inutilisable maintenant tellement c’est lent.

Le problème n’est pas l’interface Gnome, qui deviendrait de plus en plus gourmande en ressources au fil de ses versions, mais systemd.

Pour comprendre ce qu’est systemd, il faut revenir aux origines du monde Unix, basé sur la philosophie KISS (Keep It Simple, Stupid), c’est à dire basé sur des briques logicielles simples, ne faisant qu’une chose mais la faisant de manière excellente.

L’exemple type est la commande Unix « sort« , qui permet de trier ce qu’on lui donne en entrée. Quel que soit votre talent, si vous programmez vous-même une fonction de tri, elle sera assurément moins performante que le programme sort. Pour une bonne et simple raison : il y a des gens dans le monde qui font des thèses de doctorat sur les algorithmes de tri, et les algorithmes les plus avancés dans la recherche sont implémentés dans la commande sort. Vous ne pourrez pas lutter avec l’un de vos programmes. C’est un exemple typique du KISS : la commande est simple, ne sait faire qu’une chose, mais le fait vraiment très très bien.

Conformément à la philosophie KISS, les systèmes Unix, dont Linux, démarrent traditionnellement en bootant le noyau, qui finit par donner la main à un programme d’initialisation dont le processus est lancé en ayant le PID 1. Ce programme a pour tâche de lancer tous les autres processus de sorte que le système entier soit opérationnel. Ce programme d’initialisation traditionnel est init, et provient de son ancêtre init system V.

Tout comme sort, init est léger, ne sait faire qu’une chose mais le fait très bien : lancer tout le système.

Tout allait bien jusqu’à ce qu’en 2010, un ayatollah de chez Red Hat, Lennart Poettering, change la donne en décrétant qu’init n’était plus assez bien, qu’il fallait l’abandonner au profit de son bébé systemd, qui ne respecte plus le principe KISS. En effet, systemd permet d’initialiser comme init, mais il donne également un cadre global pour créer des services (les services existent aussi sous System V, mais assurés par un autre programme qu’init).

Continuer la lecture →

Passkeys : l’adieu aux mots de passe, mode d’emploi

Les mots de passe ont régné sans partage pendant quarante ans. Quarante ans à les réinitialiser, à les oublier, à les réutiliser, à les voir fuiter par millions. Quarante ans à expliquer aux utilisateurs qu’il faut des majuscules, des chiffres, des symboles, et qu’il ne faut surtout pas les noter sur un post-it.

Cette ère touche à sa fin. En 2026, plus de cinq milliards de passkeys sont en circulation, et trois utilisateurs sur quatre en ont déjà activé au moins une sur un compte. Ce n’est pas une mode. C’est un basculement.

Ce qu’est vraiment une passkey

Derrière ce terme un peu mystérieux se cache un mécanisme cryptographique d’une simplicité élégante. Lorsque vous créez un compte avec une passkey, votre téléphone, votre ordinateur ou votre clé USB génère une paire de clés : une clé publique que le service en ligne conserve, et une clé privée qui, elle, ne quitte jamais votre appareil. Cette clé privée est enfermée dans un coffre-fort numérique – la Secure Enclave des iPhone, le TPM des PC, le Titan M des Pixel. Pour l’utiliser, vous n’avez pas besoin de la connaître, ni de la taper, ni de la retenir. Un simple geste suffit : votre empreinte, votre visage ou votre code PIN.

Quand vous vous connectez, le site vous envoie un défi aléatoire. Votre appareil le signe avec la clé privée, et le site vérifie la signature avec la clé publique. Aucun secret ne transite sur le réseau. Et parce que la signature est liée au nom de domaine du site, une passkey créée pour votre banque ne fonctionnera jamais sur un site pirate. Le phishing, qui reste la porte d’entrée de la majorité des cyberattaques, devient mathématiquement impossible.

La révolution des clés de sécurité matérielles

Mais il faut distinguer deux réalités bien différentes. D’un côté, les passkeys dites « synchronisées » – celles qui voyagent dans votre trousseau iCloud, votre compte Google ou votre gestionnaire Bitwarden. Elles sont pratiques, accessibles, et suffisantes pour la plupart des usages. Elles sont toutefois hébergées dans le cloud, et leur sécurité dépend de celle de votre compte et de votre fournisseur.

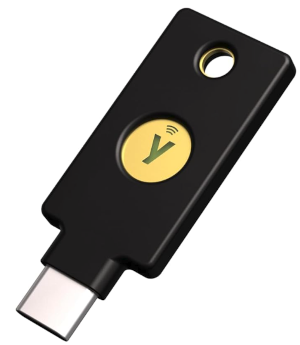
YubiKey 5C NFC

De l’autre, il y a les passkeys « liées à un appareil », et parmi elles, les clés de sécurité matérielles comme les YubiKey, SoloKey ou Google Titan. Ces petits objets en forme de clé USB – parfois dotés du NFC pour fonctionner sans fil avec les téléphones.

Continuer la lecture →

BSD sur PC – Parce qu’il n’y a pas que Linux

Petite incursion culturelle dans le monde parallèle à celui de Linux : le monde fabuleux des Unices (eh oui, le pluriel d’Unix est Unices) de la famille BSD (Berkeley Software Distribution).

Dans l’écosystème des systèmes d’exploitation de type Unix, Linux occupe une place prépondérante, mais une famille plus discrète, plus ancienne, continue d’incarner une philosophie de la stabilité et de la conception intégrée : les systèmes BSD. Loin d’être une relique, cette famille, comprenant FreeBSD, OpenBSD, NetBSD et DragonFly BSD, alimente des infrastructures critiques, des appliances réseau aux serveurs de streaming, en passant par l’automatisation industrielle.

Un héritage prestigieux pour une philosophie unique

L’histoire des BSD commence à l’Université de Californie à Berkeley dans les années 1970, comme une distribution du système UNIX d’AT&T. Rapidement, les chercheurs de Berkeley y apportent des améliorations fondamentales, dont l’implémentation de la pile TCP/IP qui a permis l’essor d’Internet. Après des démêlés judiciaires avec AT&T, le code est libéré en 1994 sous forme de 4.4BSD-Lite, donnant naissance aux projets que nous connaissons aujourd’hui.

Contrairement à Linux, qui n’est qu’un noyau autour duquel on assemble des distributions, un système BSD est un tout cohérent. Le noyau, les utilitaires système (ls, cat, le compilateur C) et la documentation sont développés et maintenus par un seul projet. Cette approche « système complet » garantit une intégration et une stabilité que peu de distributions Linux peuvent égaler.

Au cœur de cette philosophie se trouve aussi la licence BSD, qui se distingue radicalement de la GPL de Linux. Cette licence permissive permet d’utiliser, de modifier et même d’intégrer le code dans des logiciels propriétaires, sans obligation de redistribuer les modifications. C’est ce qui a permis son adoption massive dans des produits commerciaux comme MacOS, iOS, ou même des composants de Windows.

Continuer la lecture →

Boris Cherny, père de Claude code, explique comment prompter

Claude Code est bien plus qu’un simple assistant conversationnel spécialisé dans la programmation. Il s’agit d’un agent de codage autonome, capable de lire, comprendre et modifier votre code, d’exécuter des commandes et d’interagir avec vos outils de développement, le tout directement depuis votre terminal ou votre environnement de développement intégré. Conçu pour accompagner les développeurs à chaque étape du cycle de vie d’un projet, Claude Code se présente comme un véritable partenaire, aussi à l’aise pour explorer un codebase inconnu que pour corriger un bug critique en production.

Au cœur de Claude Code se trouve ce que l’on appelle le « cerveau » de l’agent, également désigné sous le terme d’« agentic harness ». Ce cerveau est piloté par les modèles les plus avancés de la famille Claude, comme Sonnet ou Opus, et se distingue par sa capacité à agir de manière autonome grâce à un ensemble d’outils intégrés. Contrairement à un assistant conversationnel classique qui se contente de prodiguer des conseils, Claude Code peut lire vos fichiers, les modifier, lancer des tests, interagir avec Git, et bien plus encore.

Il est accessible sur plusieurs supports : depuis un terminal grâce à une interface en ligne de commande, via des extensions pour les IDE populaires comme VS Code ou JetBrains, mais aussi depuis une application de bureau dédiée ou directement sur le web à l’adresse claude.ai/code.

Continuer la lecture →