
Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.
Dans cet épisode 5 nous allons voir les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.
Rappelons que ces mécanismes sont indispensables car, comme nous l’avons vu dans l’épisode 2 consacré à la gestion de la mémoire, les processus vivent en mémoire virtuelle paginée utilisateur ce qui rend leur espace mémoire complètement étanche avec celui des autres processus.
Sans mécanisme particulier additionnel, la communication inter-processus ne serait tout simplement pas possible par construction.
Le noyau Linux, comme tous les Unices (pluriel d’Unix), offre 2 mécanismes de synchronisation (signaux et sémaphores) et 5 mécanismes d’échange de données (segments de mémoire partagée, files de messages, pipes, pipes nommés, et sockets Unix). Nous allons balayer le fonctionnement de ces mécanismes, dont nous étudierons l’utilisation dans des programmes en langage C dans des articles ultérieurs.
Les signaux
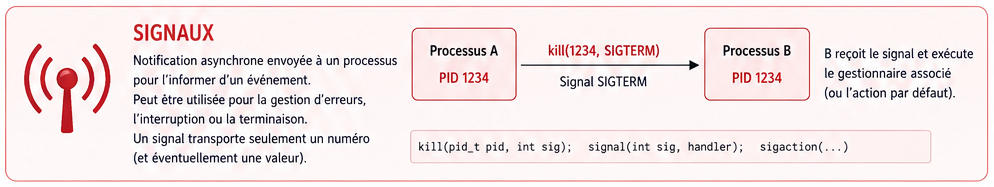
Les signaux sont un mécanisme de communication inter-processus qui permet d’envoyer des notifications asynchrones à un processus pour l’informer qu’un événement s’est produit. On peut les voir comme des « interruptions logicielles » qui permettent au noyau, à un autre processus ou à un utilisateur de contrôler et d’interagir avec un programme en cours d’exécution.
Un signal peut être généré par :
- L’utilisateur : Par des combinaisons de touches comme
Ctrl+Cpar exemple. - Le noyau : Pour signaler une erreur matérielle ou logicielle (par exemple, une division par zéro ou un accès mémoire invalide).
- Un autre processus : Via des commandes shell comme
killou des appels système.
Lorsqu’un signal est envoyé à un processus (en indiquant son PID), celui-ci peut y réagir de quatre manières différentes :
- Exécuter l’action par défaut : Souvent, cela termine le processus. Parfois, le signal est ignoré.
- Ignorer le signal : Le processus ne fait rien et continue son exécution.
- Intercepter le signal (avec un gestionnaire, ou callback) : Le processus exécute une fonction personnalisée pour traiter l’événement.
- Bloquer le signal : Le signal est mis en attente et ne sera délivré que lorsque le processus le débloquera.
Chaque signal est connu par un nom (SIGKILL, SIGSTOP, etc.) ou par son numéro.
Les signaux SIGKILL (signal qui porte le numéro 9) et SIGSTOP (qui porte les numéros 19, ou 23) sont des exceptions. Ils ne peuvent ni être interceptés, ni ignorés, ni bloqués. Cela garantit que l’utilisateur ou l’administrateur peut toujours stopper un processus, même s’il est défaillant.
Voici un résumé des signaux les plus importants, leur action par défaut et leurs cas d’utilisation typiques.
| Signal | Valeur | Action par défaut | Cas d’utilisation typique |
|---|---|---|---|
| SIGINT | 2 | Termine le processus | Interrompt un processus en cours d’exécution, généralement via Ctrl+C. |
| SIGTERM | 15 | Termine le processus | Demande polie de terminaison. C’est le signal envoyé par défaut avec la commande kill. Permet au processus de faire un nettoyage avant de se terminer. |
| SIGKILL | 9 | Termine le processus immédiatement | Force l’arrêt brutal d’un processus qui ne répond pas. Il ne peut pas être intercepté. |
| SIGHUP | 1 | Termine le processus | Signale qu’une ligne de communication (ex: terminal) est coupée. Utilisé par les démons (services) pour demander un rechargement de leur fichier de configuration sans redémarrer le processus. |
| SIGSTOP | 17, 19, 23 | Arrête (suspend) le processus | Suspend le processus. Ne peut pas être intercepté. Souvent suivi d’un SIGCONT pour reprendre. |
| SIGCONT | 19, 18, 25 | Continue le processus | Reprend un processus qui a été arrêté, par exemple avec SIGSTOP ou Ctrl+Z. |
| SIGSEGV | 11 | Termine avec vidage mémoire (core dump) | Erreur de segmentation : le processus tente d’accéder à une zone mémoire invalide (ex: déréférencement d’un pointeur nul). |
| SIGUSR1, SIGUSR2 | 30,10,16 / 31,12,17 | Termine le processus | Signaux définis par l’utilisateur. Les développeurs peuvent les utiliser pour des besoins de communication sur mesure entre des processus. |
| SIGALRM | 14 | Termine le processus | Signale qu’un temporisateur, créé avec la fonction alarm(), a expiré. |
La commande shell kill est l’outil principal pour envoyer un signal à un processus. Sa syntaxe est simple :
kill -SIGNAL PIDPar exemple :
kill -SIGTERM 1234: Demande gentiment au processus de PID 1234 de se terminer.kill -9 1234: Force l’arrêt immédiat du processus de PID 1234.
La commande shell killall permet d’envoyer un signal à tous les processus portant un nom donné. Exemple : killall -SIGKILL firefox.
Ces signaux sont également omniprésents en programmation système. Un développeur peut, par exemple, écrire un gestionnaire de signal pour capturer SIGINT et effectuer des opérations de sauvegarde avant que son programme ne se termine.
Les segments de mémoire partagée
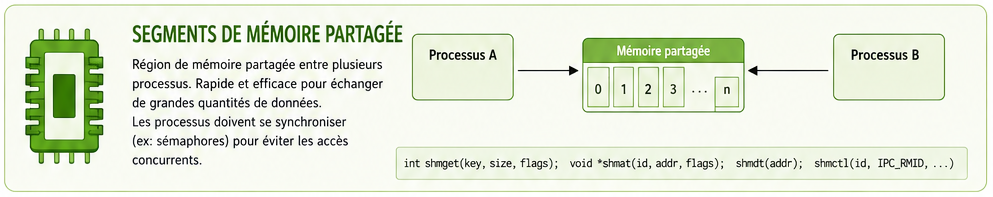
Le noyau peut allouer des pages de mémoire virtuelle partagées que les processus peuvent monter dans leur espace mémoire. Ces pages, appelés segments de mémoire partagés, peuvent être montés par plusieurs processus, créant ainsi une zone d’échange de données permettant de traiter de (relativement) gros volumes de données.
Mais attention, l’accès concurrent à des données partagées pose des problèmes de stabilité et de fiabilité de ces données qui sont insoupçonnables tant qu’on n’a pas expérimenté ce type de programmation. C’est un sujet qu’on étudie lorsqu’on fait ses études d’informatique. La solution est simple pourtant : aucun processus ne doit accéder à ses données en même temps qu’un autre processus, ce qui oblige à considérer les sections d’accès aux données comme du code critique, dont l’accès doit être protégé par un sémaphore.
Nous verrons dans un article ultérieur comment utiliser les segments de mémoire partagés de manière pratique.
Les sémaphores
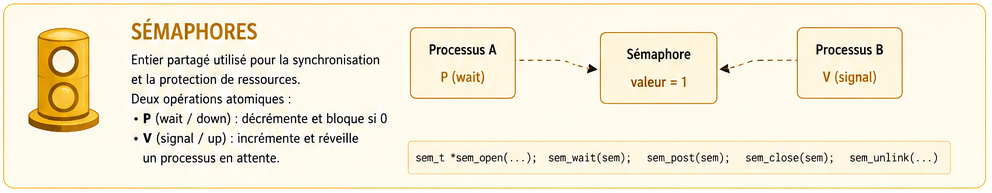
Les sémaphores sont des grappes de jetons qui permettent de protéger l’accès à des sections de code critiques. Critiques dans le sens où : si deux processus ou deux processus légers (threads) exécutent la même section de code en même temps la valeur des variables devient indéterminée.
Le cas typique est du code qui lit ou écrit des variables dans un segment de mémoire partagée. Si deux processus accèdent à la même variable dans un segment de mémoire partagée, même si l’un ne fait que lire le contenu de la variable et l’autre ne fait qu’y écrire, l’accès à la variable doit être protégé par un sémaphore.
Un sémaphore est un jeton, qu’on décrémente en réalisant une opération P (via un appel système au noyau) et qu’on incrémente en faisant une opération V (via un autre appel système au noyau).
Si un processus fait une opération P, la valeur du jeton (qu’on fixe initialement) est décrémentée. Tant que cette valeur n’atteint pas 0, rien d’autre ne se passe. Si par contre l’opération de décrémentation donne 0, alors le processus appelant cet appel système est bloqué par le noyau en attente qu’un autre processus fasse une opération V pour rendre un jeton.
Ainsi, un sémaphore initialisé à la valeur 1 garantit qu’un seul processus à la fois sera dans une section de code critique donnée. Et un sémaphore initialisé à la valeur N garantit qu’au plus N processus pourront se retrouver simultanément dans une section de code critique.
Vous l’avez compris, les sémaphores sont un mécanisme très puissant et indispensable, mais un mécanisme dangereux car il peut y avoir une perte de jeton. Les deux cas dans lesquels les programmeurs doivent impérativement éviter de tomber sont :
- le cas où un programme « oublie » de rendre le jeton lorsqu’il quitte la section de code critique. Dans ce cas, tous les autres processus qui attendent la libération du jeton pour y rentrer sont bloqués ad vitam
- Et le cas qu’on appelle « Etreinte fatale » (deadlock en anglais) qui est celui où un processus A disposant du jeton 1 demande le jeton 2 (non disponible car détenu par B), et où un processus B disposant du jeton 2 demande le jeton 1 (non disponible car détenu par A). Chaque processus attend la libération du jeton de l’autre.
Les sémaphores sont très souvent initialisés à 1. Dans ce cas on les appelle des mutex (exclusion mutuelle). Cependant, par commodité, les appels système permettant de les manipuler les manipulent par grappe de plusieurs sémaphores.
Les pipes
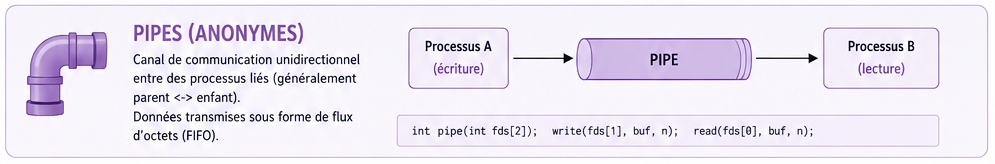
Les pipes sont des tuyaux stockés par le noyau dans son espace, sur lesquels les processus peuvent demander à se connecter via un appel système au noyau. Cette connexion leur donne un accès en écriture ou en lecture.
Si un processus A utilise le pipe en écriture, et un processus B utilise le même pipe en lecture, alors ce qu’écrit A dans le pipe peut être lu, dans le même ordre d’octets qu’à l’émission, par B.
Ce mécanisme est utilisé par exemple par le shell bash quand on tape une commande utilisant un pipe comme par exemple la commande ci-dessous qui compte le nombre de fichiers présents dans un répertoire :
ls | wc -lLorsqu’on tape cette commande, bash :
- Réclame au noyau la connexion à un pipe (appel système pipe)
- Crée un processus fils 1 (appel système fork) dont il connecte la sortie standard au pipe (appels système close puis dup)
- Crée un processus fils 2 (appel système fork) dont il connecte l’entrée standard au pipe (appels système close puis dup)
- Ecrase le code du processus fils 1 par le code exécutable de /bin/ls (appel système exec)
- Ecrase le code du processus fils 2 par le code exécutable de /bin/wc (appel système exec)
- Attend que les deux processus fils aient terminé leur travail et soient morts (double appel système wait)
Cela parait compliqué comme cela mais il n’en est rien : nous verrons dans un article ultérieur comment programmer ce comportement de shell vis à vis des pipes.
Les pipes peuvent être utilisés par un programmeur pour faire communiquer deux processus liés (père fils). Si deux processus ne sont pas liés par cette relation de filiation, il faut utiliser à la place les pipes nommés.
Les pipes nommés
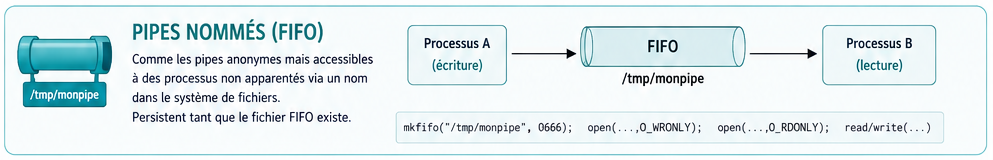
Les pipes nommés, appelés aussi FIFO (First In, First Out), fonctionnent exactement comme les pipes, sauf que les processus ne s’y connectent pas en faisant l’appel système pipe au noyau mais en ouvrant un fichier représentant le pipe dans le système de fichiers. On voit donc le pipe sur le disque dur.
Pour pouvoir utiliser un tel pipe, il faut donc au préalable qu’il ait été créé dans le système de fichiers. La commande shell mkfifo est prévue pour cela :
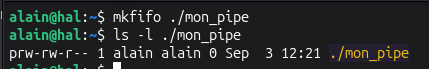
Notez le p à gauche de la zone de droits du fichier créé, qui révèle qu’il s’agit d’un pipe nommé.
Les sockets Unix
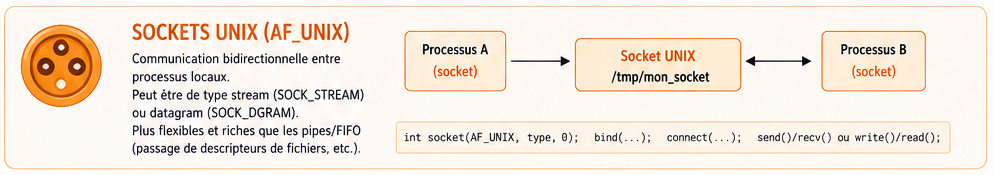
A ne pas confondre avec les sockets réseaux qui, elles, servent à faire communiquer des processus qui ne sont pas sur la même machine.
Les sockets Unix ressemblent beaucoup aux pipes nommés, en ce sens qu’elles utilisent une communication via un fichier à créer au préalable dans le système de fichiers. Cependant une socket Unix est multi-directionnelle contrairement aux pipes nommés (qui n’ont qu’un sens). On utilise généralement une socket Unix plutôt qu’un pipe nommé lorsqu’on a des données structurées à transmettre entre les processus. C’est un choix d’architecture (2 pipes nommés pouvant permettre d’obtenir un résultat architectural proche de celui de la socket Unix).
Autre différence fondamentale, les sockets unix s’utilisent avec les mêmes appels système que les sockets réseau (TCP/IP), qui n’ont rien à voir avec les appels système d’un FIFO.
Contrairement aux pipes nommés, pour lesquels il existe une commande (mkfifo) pour les créer dans le système de fichier, il n’y a pas franchement de commande permettant de créer les sockets Unix. Cependant, quand on maîtrise bien le langage C et les appels système, il n’est pas compliqué de se créer soi-même la commande qui manque.
Voici par exemple le code source du programme que j’utilise et que je me suis écrit pour réaliser cette tâche : mksocketunix.c
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <fcntl.h>
#include <sys/un.h>
#include <sys/socket.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <unistd.h>

int main(int argc, char **argv)
{
char * mysocketpath = argv[1];
struct sockaddr_un namesock;
int fd;

if(argc!=2)
    {
    printf("Veuillez passer le nom de la socket nommée à créer en paramètre\n");
    exit(0);
    }
namesock.sun_family = AF_UNIX;
strncpy(namesock.sun_path, (char *)mysocketpath, sizeof(namesock.sun_path));
fd = socket(AF_UNIX, SOCK_DGRAM, 0);
bind(fd, (struct sockaddr *) &namesock, sizeof(struct sockaddr_un));
close(fd);
}
On compile ce programme par la commande :
gcc mksocketunix.c -o mksocketunix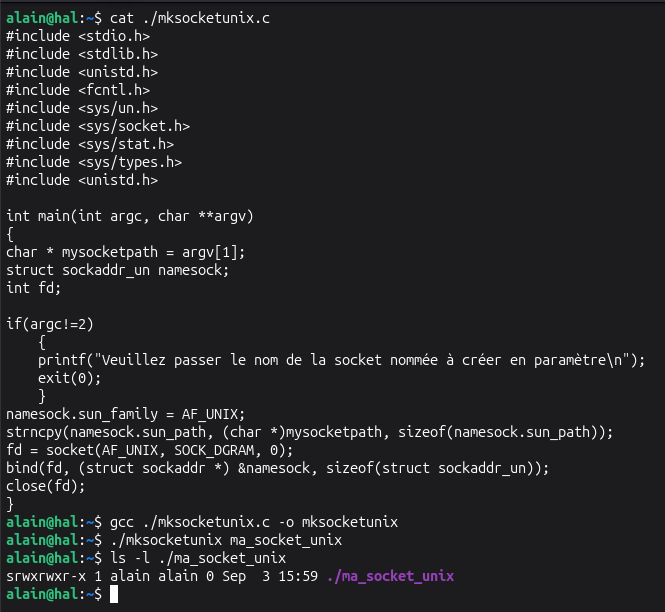
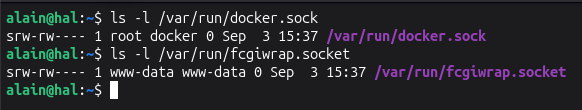
Et voilà, avec cette nouvelle commande que nous avons programmée en utilisant les appels système socket, bind et close nous pouvons créer à volonté des sockets Unix dans le système de fichiers (ou recréer une socket Unix qui aurait disparu). Notez le s à gauche au début de la zone de droits d’accès du fichier qui indique qu’il s’agit d’une socket Unix.
Docker et fcgiwrap, deux logiciels beaucoup utilisés sous Linux, utilisent chacun une socket Unix pour fonctionner.
Nous voici arrivés au terme de ce tour d’horizon des mécanismes de communication inter-processus que le noyau Linux met à disposition des programmes, pourtant étanches dans leur zone mémoire respective, pour communiquer entre eux.
Nous verrons dans des épisodes ultérieurs comment implémenter chacun d’entre eux pour faire communiquer des programmes écrits dans le langage roi sous Linux, le langage C.