Archives par étiquette : IPC

Fonctionnalités du noyau Linux (Episode 11) – Travaux pratiques sur les segments de mémoire partagés

Comme nous l’avons vu dans l’épisode 2, les processus sont exécutés en mémoire sur des pages virtuelles, ce qui garantit une étanchéité totale entre eux. Ceci oblige à passer par les mécanismes offerts par le noyau pour faire transiter des informations d’un processus à l’autre. Ces mécanismes ont été survolés lors de l’épisode 5.

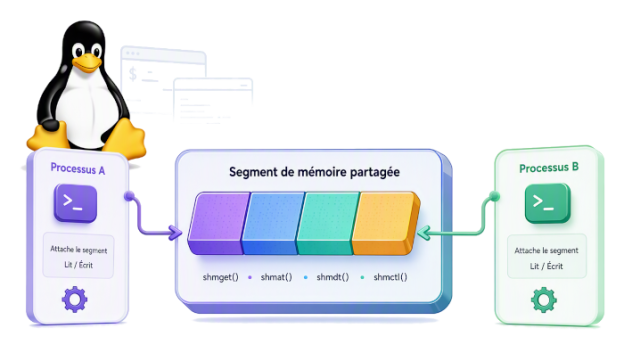
Parmi ces mécanismes, on trouve les segments de mémoire partagée.

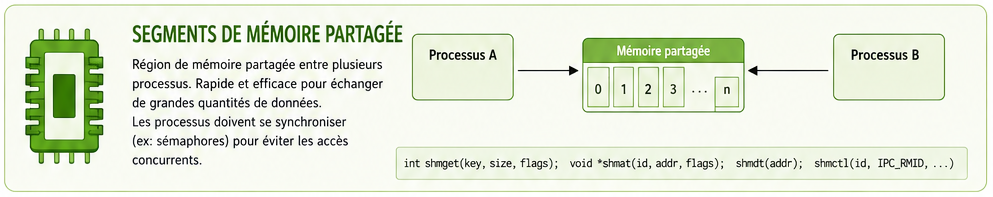
Le noyau peut en effet allouer des pages de mémoire virtuelle partagées que les processus peuvent monter dans leur espace mémoire. Ces pages, appelés segments de mémoire partagés, peuvent être montés par plusieurs processus, créant ainsi une zone d’échange de données permettant de traiter de (relativement) gros volumes de données.

Mais attention, l’accès concurrent à des données partagées pose des problèmes de stabilité et de fiabilité de ces données qui sont insoupçonnables tant qu’on n’a pas expérimenté ce type de programmation concurrente. C’est un sujet qu’on étudie lorsqu’on fait ses études d’informatique. La solution est simple pourtant : aucun processus ne doit accéder à ces données en même temps qu’un autre processus, ce qui oblige à considérer les sections d’accès aux données comme du code critique, dont l’accès doit être protégé par un sémaphore.

Nous avons vu comment mettre en oeuvre les sémaphores dans l’épisode 10.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 10) – Travaux pratiques sur les sémaphores

Comme nous l’avons vu dans l’épisode 5, les sémaphores sont des grappes de jetons qui permettent de protéger l’accès à des sections de code critiques. Critiques dans le sens où : si deux processus ou deux processus légers (threads) exécutent la même section de code en même temps alors la valeur des variables devient indéterminée.

Le cas typique est du code qui lit ou écrit des variables dans un segment de mémoire partagée. Si deux processus accèdent à la même variable dans un segment de mémoire partagée, même si l’un ne fait que lire le contenu de la variable et l’autre ne fait qu’y écrire, l’accès à la variable doit être protégé par un sémaphore.

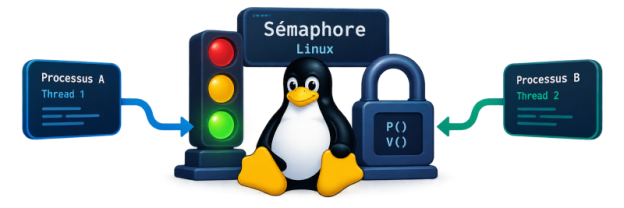
Un sémaphore est un jeton, qu’on décrémente en réalisant une opération P (via un appel système au noyau) et qu’on incrémente en faisant une opération V (via un autre appel système au noyau).

Si un processus fait une opération P, la valeur du jeton (qu’on fixe initialement) est décrémentée. Tant que cette valeur n’atteint pas 0, rien d’autre ne se passe. Si par contre l’opération de décrémentation donne 0, alors le processus appelant cet appel système est bloqué par le noyau en attente qu’un autre processus fasse une opération V pour rendre un jeton.

Ainsi, un sémaphore initialisé à la valeur 1 garantit qu’un seul processus à la fois sera dans une section de code critique donnée. Et un sémaphore initialisé à la valeur N garantit qu’au plus N processus pourront se retrouver simultanément dans une section de code critique.

Vous l’avez compris, les sémaphores sont un mécanisme très puissant et indispensable, mais un mécanisme dangereux car il peut y avoir une perte de jeton. Les deux cas dans lesquels les programmeurs doivent impérativement éviter de tomber sont :

  • le cas où un programme « oublie » de rendre le jeton lorsqu’il quitte la section de code critique. Dans ce cas, tous les autres processus qui attendent la libération du jeton pour y rentrer sont bloqués ad vitam
  • Et le cas qu’on appelle « Etreinte fatale » (deadlock en anglais) qui est celui où un processus A disposant du jeton 1 demande le jeton 2 (non disponible car détenu par B), et où un processus B disposant du jeton 2 demande le jeton 1 (non disponible car détenu par A). Chaque processus attend la libération du jeton de l’autre.

Les sémaphores sont très souvent initialisés à 1. Dans ce cas on les appelle des mutex (exclusion mutuelle). Cependant, par commodité, les appels système permettant de les manipuler les manipulent par grappe de plusieurs sémaphores.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 5) – Communication inter-processus

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.

Dans cet épisode 5 nous allons voir les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.

Rappelons que ces mécanismes sont indispensables car, comme nous l’avons vu dans l’épisode 2 consacré à la gestion de la mémoire, les processus vivent en mémoire virtuelle paginée utilisateur ce qui rend leur espace mémoire complètement étanche avec celui des autres processus.

Sans mécanisme particulier additionnel, la communication inter-processus ne serait tout simplement pas possible par construction.

Le noyau Linux, comme tous les Unices (pluriel d’Unix), offre 2 mécanismes de synchronisation (signaux et sémaphores) et 5 mécanismes d’échange de données (segments de mémoire partagée, files de messages, pipes, pipes nommés, et sockets Unix). Nous allons balayer le fonctionnement de ces mécanismes, dont nous étudierons l’utilisation dans des programmes en langage C dans des articles ultérieurs.

Les signaux

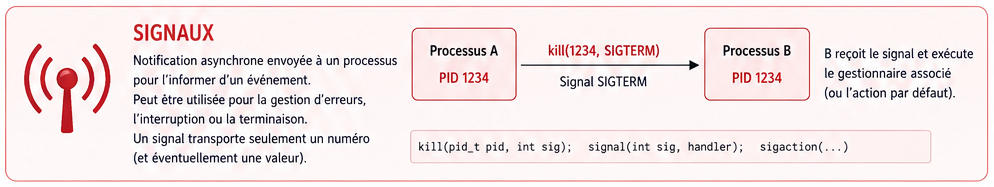
Les signaux sont un mécanisme de communication inter-processus qui permet d’envoyer des notifications asynchrones à un processus pour l’informer qu’un événement s’est produit. On peut les voir comme des « interruptions logicielles » qui permettent au noyau, à un autre processus ou à un utilisateur de contrôler et d’interagir avec un programme en cours d’exécution.

Un signal peut être généré par :

  • L’utilisateur : Par des combinaisons de touches comme Ctrl+C par exemple.
  • Le noyau : Pour signaler une erreur matérielle ou logicielle (par exemple, une division par zéro ou un accès mémoire invalide).
  • Un autre processus : Via des commandes shell comme kill ou des appels système.

Lorsqu’un signal est envoyé à un processus (en indiquant son PID), celui-ci peut y réagir de quatre manières différentes :

  1. Exécuter l’action par défaut : Souvent, cela termine le processus. Parfois, le signal est ignoré.
  2. Ignorer le signal : Le processus ne fait rien et continue son exécution.
  3. Intercepter le signal (avec un gestionnaire, ou callback) : Le processus exécute une fonction personnalisée pour traiter l’événement.
  4. Bloquer le signal : Le signal est mis en attente et ne sera délivré que lorsque le processus le débloquera.

Chaque signal est connu par un nom (SIGKILL, SIGSTOP, etc.) ou par son numéro.

Les signaux SIGKILL (signal qui porte le numéro 9) et SIGSTOP (qui porte les numéros 19, ou 23) sont des exceptions. Ils ne peuvent ni être interceptés, ni ignorés, ni bloqués. Cela garantit que l’utilisateur ou l’administrateur peut toujours stopper un processus, même s’il est défaillant.

Continuer la lecture →