Le développement web se fait aujourd’hui grâce à des langages modernes : Javascript, Typescript, React pour le frontend, PHP, node.js notamment pour le backend.
Quand j’explique à des programmeurs que je programme mes backends en langage C, ils sont généralement très étonnés que ce soit même faisable.
Et pourtant, ça marche très bien. Ce n’est probablement pas le langage le plus adapté, mais ce n’est pas compliqué et ça marche.
Quels avantages en tirer ?
Tout d’abord la simplicité. Avec le C il n’y a aucune bibliothèque ou framework externe à charger. Le programme ne fera que ce que vous écrivez. Vous maîtrisez la compréhension du code de A à Z. Ce qui ne vous empêche pas bien sûr de vous créer votre propre bibliothèque de routines réutilisables en C.
Deuxièmement, la vélocité. A part l’assembleur, aucun langage n’est aussi rapide que le C. Votre serveur web sera donc hyper véloce.
Troisièmement, l’indépendance. Comme vous n’utilisez aucune bibliothèque ou framework externe, vous n’aurez pas de mise à jour de ceux-ci qui mettent par terre votre mécanique.
Comment ça marche ?
Servir dynamiquement des pages web relève toujours de la même mécanique, représentée ci-dessous :
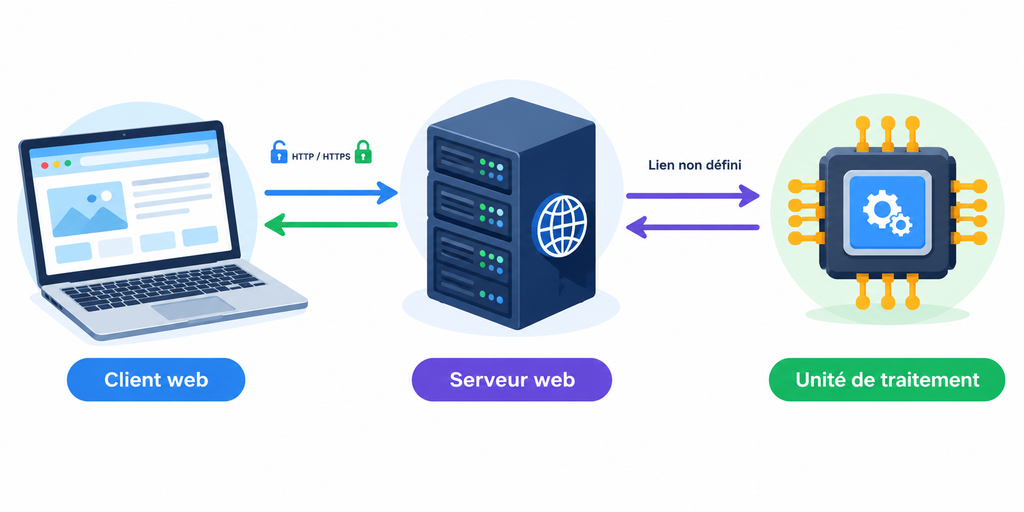
Le client web à servir (le navigateur) communique avec un serveur sur lequel 2 services tournent : le serveur web et l’unité de traitement.
Le serveur web s’occupe d’un côté de communiquer avec le client en http ou en https, selon comment il est configuré. Et de l’autre côté il s’occupe de transmettre à l’unité de traitement les data des requêtes que le client web lui a envoyées.
L’unité de traitement sait quoi faire des données de requête reçues du client (consulter ou mettre à jour une base de données par exemple), et sait générer une page html de réponse qu’il transmet au serveur web.
Le serveur web récupère la page html générée par l’unité de traitement, et la transmet au navigateur du client qui l’affiche.
NB : Nous nous plaçons ici dans le cas où la page entière est mise à jour, pas la cas où une partie seulement de la page est mise à jour dynamiquement sans recharge de la page entière. Ce cas de figure se traite en effet avec des websockets et a déjà été traité dans l’article sur les websockets en C.
Concrètement, quand on utilise node.js, celui-ci prend en charge seul le serveur web et l’unité de traitement qui est le programme qu’on est en train d’écrire. Ce script est interprété par le moteur V8 mais certaines parties qui sont exécutées souvent sont compilées à la volée pour améliorer la vélocité.
Les sites bâtis avec PHP fonctionnent avec un vrai serveur web (Nginx, Apache, …) et l’unité de traitement est le Zend engine (écrit en C) qui interprète le script de traitement PHP à exécuter (le terme interprète est légèrement abusif puisque le Zend engine fait en réalité une pseudo compilation en bytecode avec d’exécuter le script).
Et le C là dedans ?
CGI traditionnel vs FastCGI
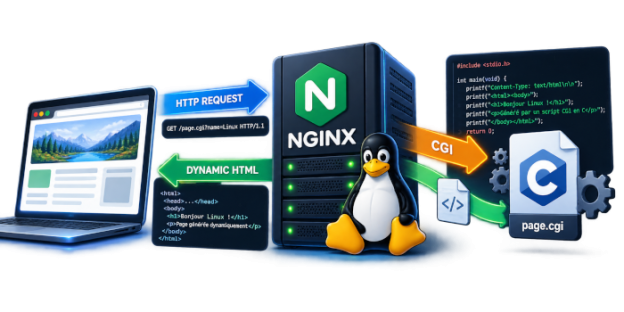
Les serveurs web ayant pignon sur rue (NginX, Apache, …) supportent les scripts CGI (Common Gateway Interface). Il s’agit d’un protocole particulier entre le serveur web et l’unité de traitement.
Ce protocole permet justement d’envoyer au script qui est l’unité de traitement la requête reçue du client, et de récupérer de celui-ci la page html résultante à envoyer au client.
Ce protocole de communication bi-directionnel particulier entre le serveur web et l’unité de traitement (qu’on appelle dans ce cas particulier un script CGI) est agnostique du langage dans lequel le script CGI est écrit.
Un script CGI peut être écrit en n’importe quel langage, donc possiblement en C.
Nous allons donc apprendre dans cette suite d’article à coder des scripts CGI en C.
Mais avant d’aller plus loin, il est nécessaire de signaler quelques points de vigilance :
- Un script CGI différent est généré (par fork) à chaque requête des clients. C’est donc un mode de fonctionnement relativement lourd, qui empêche de monter en charge ou à l’échelle. Pour pallier à ce défaut, il existe maintenant FastCGI, qui fonctionne sur le même principe que les scripts CGI traditionnels mais qui fait un seul et unique fork pour créer un unique processus qui traite toutes les requêtes reçues par un seul et unique script. Dans cette série d’articles, nous allons étudier les scripts CGI traditionnels (un processus par requête) parce qu’il sont de facto plus faciles à écrire. Mais nous verrons dans un deuxième temps comment écrire un script FastCGI.
- Les scripts CGI ont la réputation d’être dangereux à utiliser car ils sont réputés comporter des failles de sécurité. La plus évidente est que le script reçoit des données du client web, donc d’une longueur inconnue par avance. Pour peu que la variable d’accueil dans le script soit trop petite, on a vite fait un débordement de tampon. Nos scripts seront immunisés vis à vis de ce problème grâce à une allocation dynamique des variables (malloc) basée sur la taille effectivement reçue du client. Autre faille potentielle : l’injection SQL. Le script discutant 90% du temps avec une base de données, si le client met des requêtes SQL dans les data qu’il envoie, il peut utiliser le script comme monture pour aller mettre le bazar dans la base SQL, voire de l’effacer. Nos scripts CGI en C devront empêcher cela (en PHP ou autre on a le même problème à gérer). Enfin, pour rester dans les classiques, le client peut tenter une attaque informatique connue sous le nom de cross site scripting (XSS) qui consiste à injecter dans les requêtes non pas du SQL pour attaquer la base de données, mais du Javascript. Nos scripts CGI écrits en C devront empêcher cela également.
Et la suite alors ?
Maintenant que le décor est planté, nous allons concrètement, dans les articles à venir, apprendre à installer NginX sous Ubuntu, lui attribuer un nom de domaine, y activer https pour sécuriser les échanges entre les clients et les scripts CGI en C, y activer le mécanisme CGI, et écrire nos premiers scripts pour comprendre en détail comment ça fonctionne.
Stay tuned 😎