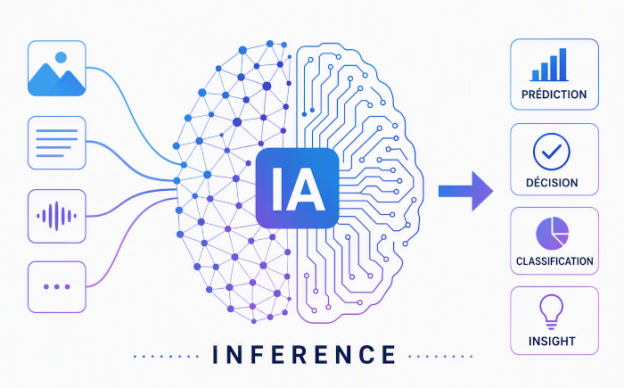
L’inférence dans le domaine de l’intelligence artificielle désigne le moment où un modèle déjà entraîné est mis à contribution pour produire une réponse, une prédiction ou une classification sur des données qu’il n’a pas vues auparavant.
C’est une étape distincte de l’entraînement, qui correspond à l’apprentissage proprement dit, et distincte aussi de l’évaluation, qui sert à mesurer la performance du modèle sur un jeu de test. L’inférence est donc la phase d’usage, celle qui se produit quand l’utilisateur interagit avec le système.
Le mot lui-même vient du latin inferre, formé de la préposition in et du verbe ferre, qui signifie porter. Le sens littéral est « porter vers, apporter en dedans », et l’usage philosophique et logique en a tiré l’idée de conduire une conclusion à partir d’éléments déjà connus.
Le français a repris ce terme dès le Moyen Âge dans le vocabulaire de la logique et de la scolastique.
Quand l’intelligence artificielle s’est constituée comme discipline, d’abord autour des systèmes experts et de la déduction formelle, le mot était déjà disponible et correspondait bien à ce que faisaient ces programmes : partir de faits et de règles pour aboutir à une conclusion. Le terme a été conservé lorsque l’apprentissage automatique puis l’apprentissage profond ont pris le dessus, même si le sens s’est élargi.
Aujourd’hui, l’inférence ne suppose plus nécessairement un raisonnement explicite au sens logique. Elle désigne simplement l’exécution du modèle entraîné, le calcul qui transforme une entrée en sortie.
En anglais, le terme est identique, inference, avec la même racine latine. On parle d’inference engine pour désigner le moteur qui exécute les calculs, d’inference time pour le temps de réponse, et de real-time inference pour les cas où la latence doit rester très faible. L’opposition classique en anglais est training contre inference, entraînement contre inférence, et cette opposition structure une grande partie du vocabulaire de la discipline.
Les poids du modèle ne changent pas pendant l’inférence. Le calcul est généralement plus léger que la rétropropagation utilisée pour l’entraînement, mais il doit souvent être répété un très grand nombre de fois, ce qui en fait la partie la plus coûteuse en production. Les optimisations portent sur la quantification, qui réduit la précision des nombres pour accélérer les calculs, sur la distillation, qui consiste à entraîner un petit modèle à imiter un grand, sur le regroupement des requêtes en lots, et sur l’usage de processeurs graphiques ou de puces spécialisées.
On cherche aussi à équilibrer la latence, c’est-à-dire le temps de réponse pour une requête donnée, et le débit, c’est-à-dire le nombre de requêtes traitées par unité de temps. Ces deux objectifs sont souvent en tension.
L’inférence se rencontre dans presque toutes les applications contemporaines. La reconnaissance faciale sur un téléphone, la traduction automatique, la détection d’objets dans une image, la génération de texte par un grand modèle de langage, la recommandation de contenu, la détection de fraude bancaire, le diagnostic médical assisté par ordinateur reposent sur des opérations d’inférence.
Dans le cas des grands modèles de langage, l’inférence se fait souvent de manière autoregressive, c’est-à-dire que le modèle produit un mot, puis s’en sert pour produire le suivant, et ainsi de suite. Cette manière de procéder explique une partie de la latence observée et justifie des techniques spécifiques comme le cache d’attention, qui évite de recalculer inutilement ce qui a déjà été calculé.
Le mot inférence conserve donc une double filiation. Il rappelle la logique et la philosophie, où il désigne l’acte de tirer une conclusion, et il s’est adapté à l’apprentissage automatique, où il désigne l’exécution d’un modèle entraîné. Ce glissement de sens n’est pas propre à l’intelligence artificielle : beaucoup de termes techniques migrent d’un domaine à un autre et se chargent de nuances nouvelles. Ce qui compte, pour éviter les malentendus, est de garder à l’esprit que dans le contexte de l’IA, inférence ne signifie pas raisonnement conscient ni déduction formelle, mais simplement production d’une sortie à partir d’une entrée par un modèle dont les paramètres sont figés.