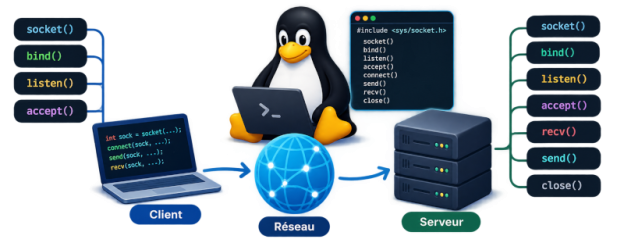
Les sockets font partie des mécanismes qui permettent aux processus de communiquer entre eux. Cependant, contrairement aux IPC classiques (segments de mémoire partagée, queues de messages, et même pipes), ce mécanisme est prévu pour faire communiquer des processus situés sur … des machines différentes.
Et comme les machines sont différentes et qu’il a bien fallu inventer des standards, les processus qui vont communiquer via ces mécanismes sont situés sur des machines différentes … dont le système d’exploitation est potentiellement différent.
Ainsi, via les sockets, une machine Linux va pouvoir communiquer avec un Mac ou une machine Windows, et inversement.
Le modèle OSI
Toutes les machines qui souhaitent communiquer avec d’autres doivent se conformer au modèle OSI.
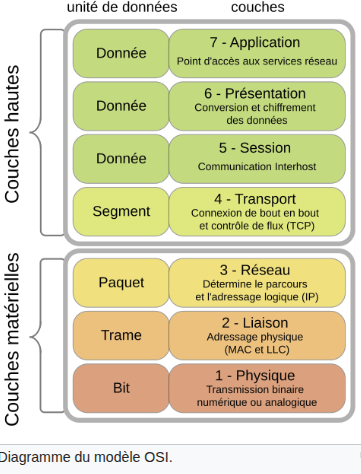
Avec ce modèle, les logiciels réseaux installés sur chaque machine sont rangés en 7 couches en théorie.
Au niveau 7 on a l’application qui veut communiquer avec une autre application, située elle aussi au niveau 7 sur une autre machine.
Les données que l’application souhaite envoyer à l’autre application descendent successivement les couches réseaux de la machine de départ, chaque couche encapsulant les données reçues de la couche du dessus et à destination de la couche équivalente sur la machine d’arrivée.
La dernière couche qui reçoit les données est la couche physique (couche 1) et c’est de là que les données quittent la machine sous forme de paquets. Ces paquets trouvent leur chemin vers la machine destination (qui peut être sur Internet, donc potentiellement de l’autre côté de la Terre) via un réseau de routeurs qui sont hors sujets dans le cadre de cet article.
Arrivés à la machine destination (potentiellement dans le désordre), ces paquets remontent les 7 couches de celle-ci (en désencapsulant à chaque couche) jusqu’à ce qu’ils soient délivrés à l’application (couche 7) qui attend ces données sur la machine destinatrice.
Bien sûr, l’application destinatrice pourra elle aussi envoyer des données de réponse à l’application émettrice en utilisant la mécanique inverse.
Le modèle TCP/IP
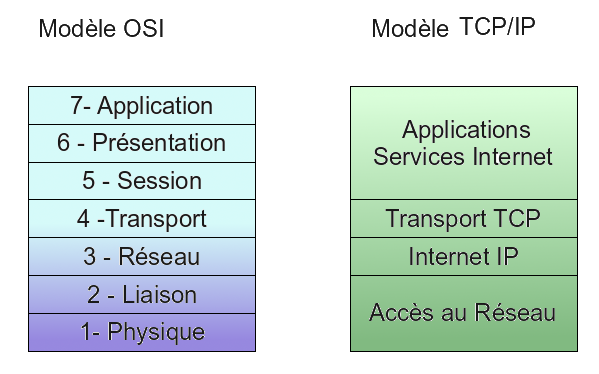
Le modèle OSI vu au dessus est un modèle théorique. En pratique on n’utilise que 4 couches :
Couche 4 : l’application qui doit communiquer (notre programme dans ce TP)
Couche 3 : une couche implémentant un protocole de transport. Elle a pour rôle de simuler un tuyau de communication bi-directionnelle entre les 2 applications. Les protocoles de transport que nous allons utiliser sont UDP (qui simule un tuyau de communication bi-directionnel dont la délivrance et le respect de l’ordre des paquets n’est pas garanti, on appelle cela le mode datagramme) et TCP (qui simule un tuyau de communication bi-directionnel dont la délivrance et le respect de l’ordre des paquets est garanti).
Couche 2 : une couche implémentant un protocole réseau, c’est à dire un protocole en mesure d’effectuer le routage des paquets sur Internet. Le protocole utilisé est IP, qui n’a comme qualité que ses capacités de routage, tout le reste étant des défauts (pas de confirmation de délivrance des paquets, pertes de paquets possibles, pas de garantie de délivrance des paquets dans l’ordre d’émission, etc.)
Couche 1 : une couche matérielle permettant l’émission et la réception effective des paquets sur le réseau (typiquement : carte Ethernet ou carte Wifi)
Vu des applications et du programmeur, il faut donc uniquement savoir comment interagir concrètement avec les couches UDP ou TCP depuis son application.
Les ports
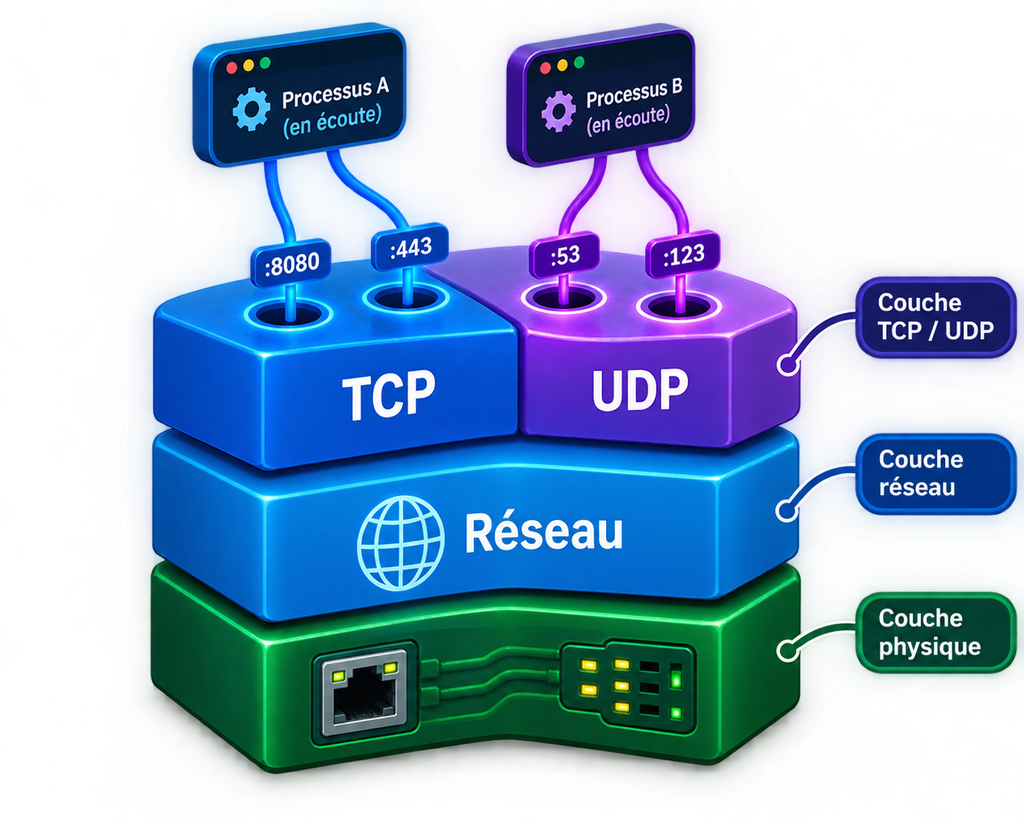
Pour interagir avec les couches réseaux, on peut voir de manière stylisée le haut des couches TCP et UDP comme parsemées de 65535 trous sur lesquels les processus peuvent venir se mettre en écoute. Ces trous sont appelés des ports (ports TCP et ports UDP, chacune des deux couches comportant 65535 ports).
On utilise sans le savoir tous les jours ces notions puisque lorsque nous tapons par exemple dans notre navigateur https://google.fr notre application (le navigateur) va demander au noyau un port TCP libre sur lequel se connecter en local, et via ce port, notre navigateur va contacter le processus qui écoute sur le port 443 (dédié à https) sur la machine dont le nom DNS est google.fr. Le processus en question qu’on trouvera sur cette machine sera un programme serveur web (Apache, ou NginX, ou etc.)
Dans les systèmes Unix, dont Linux, les ports dont le numéro est inférieur à 1024 ne sont attribuables en écoute qu’à des processus dont l’utilisateur est root. Les autres numéros de ports sont attribuables à tout programme, s’ils sont libres (les ports).
Communication client – serveur
La mécanique décrite pour l’exemple ci-dessus du navigateur qui contacte le serveur web en écoute sur le port 443 montre le schéma global de la communication par sockets :
Sur une machine B : un processus se met en écoute sur un port (TCP ou UDP). Il devient donc un serveur.
Sur une machine A ou sur d’autres machines : des processus appellent (ouvrent une socket) le processus serveur de la machine B. Ces processus sont des clients.
La communication entre un client et un serveur est toujours initiée par le client (le serveur répond).
TCP ou UDP ?
La question légitime à se poser à ce stade est : quand doit on utiliser TCP et quand doit on utiliser UDP pour son application client – serveur?
Par défaut, ce que l’on veut c’est TCP, puisque seul ce protocole garantit que les données émises seront bel et bien livrées aux destinataires, et dans l’ordre d’émission en plus. C’est donc clairement le choix par défaut. Mais pas tout le temps.
En effet, cette très haute qualité de service induit une certaine latence puisque, de manière sous-jacente, des accusés de réception sont échangés, des paquets perdus sont ré-émis, des paquets en attente bloquent la livraison de paquets déjà reçus (pour respecter l’ordre d’envoi). Cette latence n’est pas toujours souhaitable. C’est le cas des applications de transfert de la voix humaine par exemple, pour lequel on se fiche généralement complètement de perdre quelques paquets (la restitution de la voix à l’arrivée masquera qu’il y a quelques trous dans la raquette).
Un autre exemple d’application ou l’on emploie UDP plutôt que TCP est le domaine des applications de VPN, pour lesquelles l’emploi de TCP impliquerait d’encapsuler TCP dans TCP, ce qui produit de très très mauvais résultats. Les applications VPN encapsulent donc les données TCP dans UDP (les paquest UDP chiffrés du VPN).
Si vous êtes sur un réseau local simple avec juste un brin et une machine à chaque bout du brin, UDP peut faire plus efficace que TCP puisque, dans cette configuration simple sans routage Internet, il n’y a aucun risque de perdre des paquets.
IPv4 vs IPv6
IPv6 est l’avenir, et commence à être pas mal utilisé, mais IPv4 n’est pas encore mort. Du point de vue du programmeur d’applications ce n’est pas anodin, car il va falloir utiliser des routines qui sont compatibles d’IPv6 et d’IPv4.
Dans le prochain article nous allons faire un TP sur les sockets sous Linux. Nous prendrons deux machines A et B. Sur la machine A nous écrirons un programme serveur en C qui écoutera sur un port donné. Sur la machine B nous écrirons un programme client en C qui contactera le programme serveur qui tourne sur A. Une fois la liaison établie, ils joueront au ping – pong, c’est à dire que le client enverra PING et le serveur répondra PONG avant de fermer la socket. Les deux programmes afficheront à l’écran les chaines reçues, ce qui démontrera que le lien TCP entre les deux programmes est bien fonctionnel.
Stay tuned 😎