Archives par étiquette : IA

Qu’est-ce qu’un harnais en IA ?

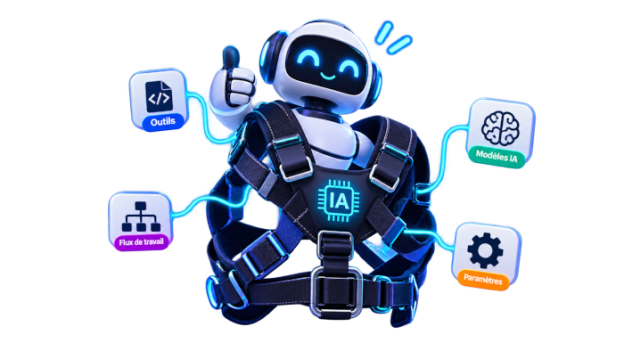
Dans le domaine de l’intelligence artificielle, le terme harnais (harness en anglais) désigne la couche logicielle qui entoure un grand modèle de langage pour le transformer en un agent capable d’exécuter réellement des tâches. Une formule résume bien cette idée : Agent = Modèle + Harnais.

Pourquoi est-ce nécessaire

Un modèle de langage brut, comme GPT ou Claude, est un cerveau très performant mais isolé. Il ne peut que générer du texte, ne se souvient de rien d’une session à l’autre et n’agit sur rien. Le harnais joue le rôle de système nerveux et de manuel d’utilisation. Il fournit au modèle des données à consulter, des outils à manipuler et des règles à respecter. C’est ce qui lui permet de passer de la capacité à parler à la capacité à agir.

Ce que contient concrètement un harnais

Un harnais complet comprend généralement plusieurs composants. D’abord une invite système, qui définit le rôle de l’agent, ses objectifs et les règles qu’il doit suivre en permanence. Ensuite des outils et un mécanisme d’exécution : le modèle décide quoi faire, le harnais se charge d’exécuter l’action réelle, comme un appel d’API ou l’exécution de code, puis renvoie le résultat au modèle. Vient également la gestion de la mémoire et du contexte, qui détermine quelles informations conserver et lesquelles résumer. S’y ajoute une boucle de vérification et de rétroaction, qui permet à l’agent de tester son propre travail et de corriger ses erreurs. Enfin, des garde-fous et un environnement isolé encadrent les permissions de l’agent et exigent une confirmation humaine avant les opérations risquées.

Une analogie simple

On peut imaginer le modèle comme un cheval puissant mais qui pourrait s’emballer. Le harnais est l’équipement complet : la selle, le mors et les rênes. Il ne change pas la force du cheval, mais il permet au cavalier de contrôler sa direction et son allure, de le faire tirer un chariot en sécurité vers la destination voulue au lieu de foncer dans le décor.

Les configurations de harnais courantes en 2026

Tous les harnais ne se ressemblent pas. Le choix d’une configuration dépend de l’usage visé, du niveau de contrôle souhaité et du contexte de déploiement. Voici les principales familles que l’on rencontre aujourd’hui, illustrées par des produits ou projets réels.

La première est le harnais en boucle simple, parfois appelé boucle ReAct. Le modèle alterne raisonnement, action et observation, sans planificateur externe ni état persistant sophistiqué. C’est l’approche la plus légère et la plus rapide à mettre en place. Un exemple représentatif est youtu-agent de Tencent Cloud, décrit comme un harnais minimal de tool-calling. Cette configuration convient bien aux tâches courtes et aux prototypes. En revanche, elle dérive facilement sur les tâches longues : sans mécanisme de rappel de l’objectif, l’agent peut s’éloigner du but initial après une dizaine d’actions.

La deuxième famille est le harnais avec planificateur ou superviseur. Un composant séparé établit un plan, surveille son exécution et déclenche une replanification en cas d’échec. C’est la configuration qui gagne en production lorsque la fiabilité prime sur la vitesse. Claude Code d’Anthropic et Deep Agents illustrent bien ce modèle : ils implémentent le motif planification-plus-sandbox de manière suffisamment aboutie pour être recommandés lorsqu’on veut qu’un seul agent termine une tâche de codage de bout en bout de façon fiable.

La troisième famille est le harnais modulaire, où les composants sont interchangeables. OpenCode en est un exemple important : il s’agit d’un backend d’agent de codage qui peut être utilisé comme runtime par d’autres harnais, comme le montre son intégration dans lh-harness aux côtés de Claude Code, Codex CLI et DeepSeek Harness . OpenCode est également à la base de dérivés comme DrizzyAgent, qui étend OpenCode avec une orchestration multi-agents . Cette modularité facilite les tests A/B et l’évolution indépendante de chaque brique.

La quatrième famille est le harnais multi-agents, où plusieurs agents spécialisés collaborent sous la coordination d’un agent manager. MetaGPT en est le représentant historique : il simule une « entreprise logicielle IA » avec des agents qui jouent les rôles de chef de produit, architecte et ingénieur. CrewAI et AgentVerse s’inscrivent dans la même veine. DrizzyAgent, mentionné plus haut, illustre cette approche appliquée au codage avec ses rôles de Coder, Planner, Oracle, Librarian et Atlas . Cette configuration brille lorsque les sous-tâches sont indépendantes et que la spécialisation apporte un gain réel.

La cinquième famille est le harnais de type microkernel ou plan de contrôle. L’idée centrale est de séparer strictement le plan de contrôle (ordonnancement, état, sécurité, mémoire, audit) du plan d’exécution, où les agents sont hébergés dans des sandbox. QM de YCombinator en est un exemple frappant : il fournit une séparation au niveau de l’organisation, où chaque employé, salon Slack et projet dispose de sa propre mémoire, de ses fichiers, de ses identifiants, de ses permissions et de son environnement sandboxé. Cette architecture offre une stabilité de production et un contrôle multi-tenant.

OpenClaw occupe une place particulière dans cette famille. Il ne se présente pas comme un harnais unique mais comme une plateforme d’exécution d’agents qui peut accueillir plusieurs harnais natifs. Sa documentation décrit explicitement un « harnais Codex » qui permet à OpenClaw de déléguer l’exécution à un serveur d’application Codex natif, tout en conservant la maîtrise du plan de contrôle : résolution du fournisseur et du modèle, authentification, budget de contexte, politique d’outils, sandbox et livraison des réponses . OpenClaw propose également un harnais acpx pour les agents compatibles ACP, avec des alias intégrés pour factory-droid, cursor et d’autres . Cette architecture illustre la tendance à traiter le harnais comme un exécuteur interchangeable, branché sur un noyau qui reste stable.

Enfin, une catégorie plus récente mérite d’être mentionnée : le harnais de flux de travail, qui impose une discipline de phases (spécification, conception, implémentation, vérification, intégration) avec un contexte frais à chaque phase et une persistance d’état dans des fichiers explicites. GSD (Get Shit Done) en est l’exemple canonique : il enveloppe une session de codage IA dans un cycle de vie en six étapes, avec un état de projet stocké dans un répertoire versionné qui survit aux réinitialisations de contexte.

Il faut également citer Pi, qui se distingue par une philosophie de « harnais auto-modifiable ». Pi n’est pas seulement un harnais de codage : c’est un environnement que l’agent peut lui-même inspecter et modifier, avec un système de plugins et d’extensions. Son package pi-harness-runtime illustre cette approche en fournissant une configuration runtime complète, avec gestion des clés API, intégrations Telegram, LangChain et PaperClip, et un mécanisme de boucle planificateur-coder-relecteur-fixeur . Dans une interview accordée à InfoQ, les créateurs de Pi décrivent leur outil comme « une preuve de concept d’un logiciel agentique auto-modifiable », et citent DeepSeek Harness comme une inspiration conceptuelle sur cette même voie . Un package communautaire comme @minhduydev/pi-harness pousse la logique plus loin en proposant un harnais portable avec extensions, compétences, modèles de prompts et thèmes, ainsi qu’un contrat de coordination gouverné pour les sous-agents .

Un point important

Le harnais ne consiste pas à corriger ponctuellement un problème en modifiant une invite. Son objectif central est de corriger une erreur commise par l’IA en modifiant son environnement d’exécution, de sorte que cette erreur ne puisse plus se reproduire. C’est pourquoi on considère souvent que la qualité du harnais détermine le degré de maturité d’un modèle dans des scénarios complexes. Une étude arXiv de 2026 va plus loin : le choix du harnais expliquerait une part plus importante de la variance des résultats aux benchmarks d’agents que le choix du modèle lui-même. Autrement dit, à modèle égal, un bon harnais fait une différence mesurable.
Cours Microsoft gratuit en 18 leçons en français pour apprendre l’IA (spécial débutants)

Joignez l’utile à l’agréable, c’est gratuit et en français 😎

Si l’audio des vidéos est en anglais, vous pouvez la basculer en français dans la fenêtre de chaque vidéo.

Leçon 1 : Introduction aux agents IA et cas d’utilisation des agents

Introduction aux agents IA et cas d’utilisation des agents

Leçon 2 : Exploration des cadres agentiques IA

Exploration des cadres agentiques IA

Leçon 3 : Compréhension des modèles de conception agentique IA

Compréhension des modèles de conception agentique IA

Continuer la lecture →

Tutoriel Linux : Installer et utiliser la reconnaissance vocale par IA sous Ubuntu

Canonical vient d’annoncer que sa reconnaissance vocale assistée par IA, Myna, est disponible en preview technologique, ce qui signifie que si elle sera livrée bientôt en standard dans la distribution elle nécessite pour l’instant d’être installée à la main, et comporte encore potentiellement quelques bugs.

La technologie Myna consiste à installer une IA en local sur la machine, de sorte que la reconnaissance vocale se fasse uniquement en local et donc ne sorte pas de la machine.

L’installation sous Ubuntu 26.04 LTS se fait en installant le ppa officiel :

sudo add-apt-repository ppa:canonical-desktop-team/myna
sudo apt update
sudo apt install myna-config
myna-config

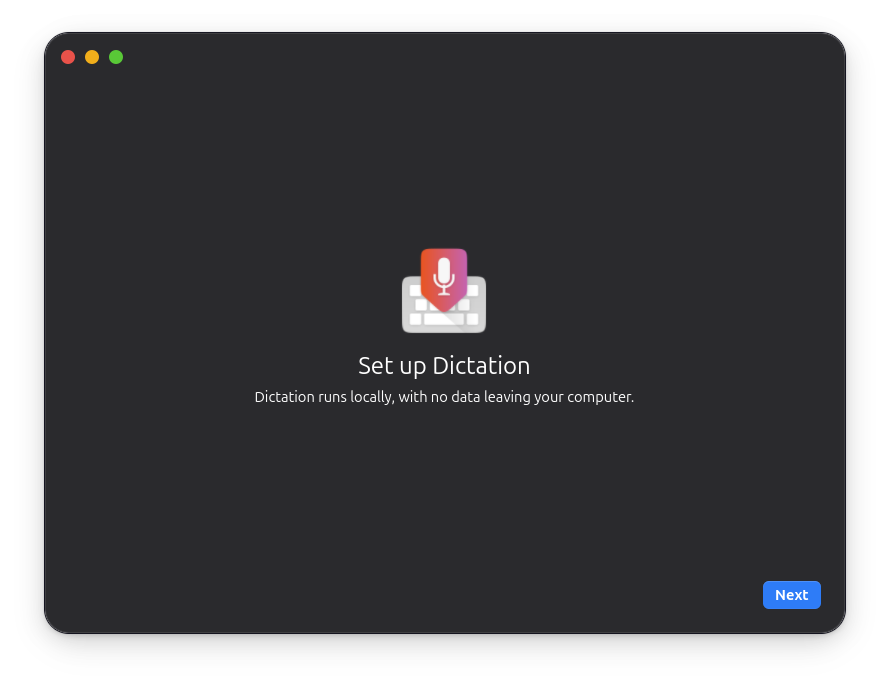
On entre alors en phase de configuration (en anglais).

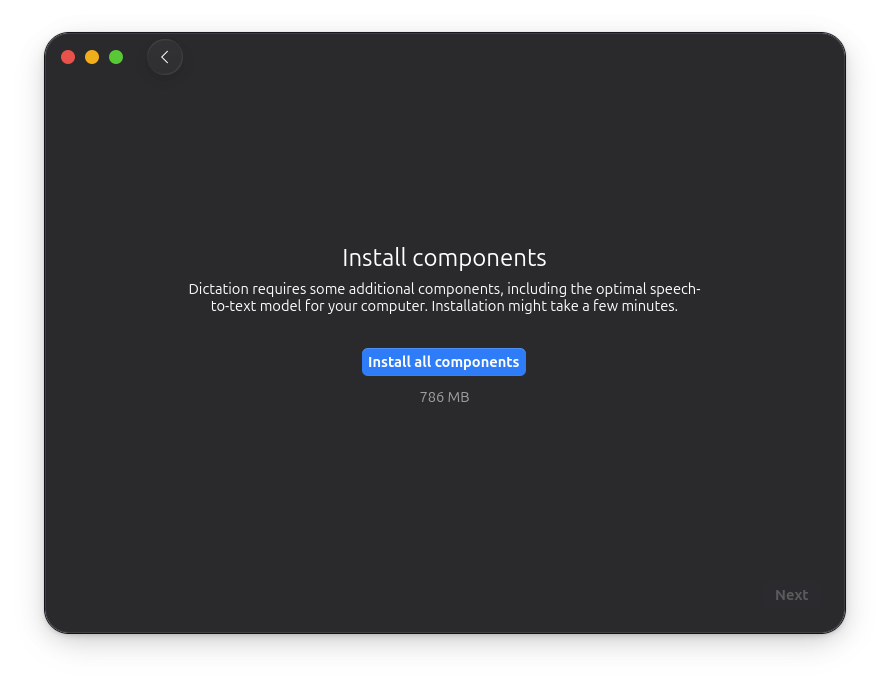
Il est proposé d’installer les composants nécessaires (IA capable de comprendre le français).

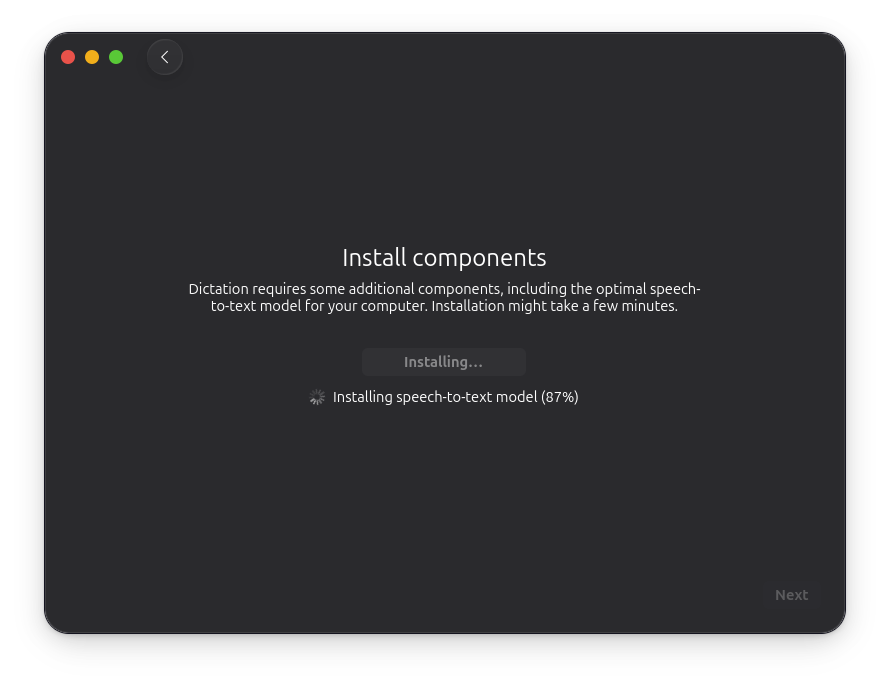
L’installation prend quand même un certain temps.

Le logiciel finit en indiquant que la reconnaissance vocale s’active et se désactive par défaut par la combinaison de touches Win + J

Continuer la lecture →

Tutoriel Linux : coder avec un modèle IA local (Ollama + Lumen)

Je me suis rendu compte à l’usage que mon article sur le codage local avec Ollama et Opencode n’était pas viable, Opencode étant plus prévu finalement pour faire fonctionner des modèles IA en ligne plutôt qu’Ollama en local.

Voici donc un nouveau tuto QUI MARCHE !

Installation et configuration d’Ollama

Ollama est le moteur qui fera tourner vos modèles localement.

1. Installation
La méthode la plus simple est le script officiel. Il installe Ollama, configure un service systemd et démarre le service automatiquement .

curl -fsSL https://ollama.com/install.sh | sh

2. Vérification
Après l’installation, vérifiez que le service est actif et que la commande fonctionne.

# Vérifier la version
ollama -v

# Vérifier que le service systemd est actif
sudo systemctl status ollama

Si le service n’est pas actif, démarrez-le avec sudo systemctl start ollama .

3. Téléchargement d’un modèle adapté
Pour Lumen, il faut un modèle capable de « tool calling ». D’après mon expérience, qwen3-vl:8b fonctionne bien avec Lumen. Vous pouvez aussi utiliser d’autres modèles compatibles comme ceux recommandés par Lumen (qwen3-coder:30b, etc.) .

# Télécharger le modèle (adapte selon tes besoins)
ollama pull qwen3-vl:8b

4. Maintenance (Mise à jour)
Pour mettre à jour Ollama, il suffit de relancer le script d’installation. Il remplacera l’ancienne version par la nouvelle .

curl -fsSL https://ollama.com/install.sh | sh

5. Désinstallation complète
Si vous souhaitez tout supprimer (service, binaires, modèles et utilisateur système) :

# Arrêter et désactiver le service
sudo systemctl stop ollama
sudo systemctl disable ollama
sudo rm /etc/systemd/system/ollama.service

# Supprimer les bibliothèques et le binaire
sudo rm -r $(which ollama | tr 'bin' 'lib')
sudo rm $(which ollama)

# Supprimer l'utilisateur, le groupe et les modèles téléchargés
sudo userdel ollama
sudo groupdel ollama
sudo rm -r /usr/share/ollama
Continuer la lecture →

Tutoriel Linux : reverse engineering avec Ghidra

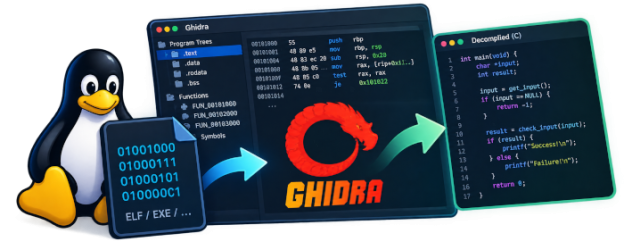
Ghidra est un framework de rétro-ingénierie logicielle développé et maintenu par la Direction de la recherche de la National Security Agency américaine. Il a été officiellement open source en mars 2019 lors de la conférence RSA, sous licence Apache 2.0, ce qui signifie que n’importe qui peut l’utiliser, le modifier et le redistribuer gratuitement. Avant cela, il était utilisé en interne par la NSA pendant des années pour répondre aux défis de rétro-ingénierie les plus complexes de l’agence.

Dans son essence, Ghidra n’est pas un programme unique mais une plateforme d’analyse complète. Elle regroupe un ensemble d’outils de haut niveau pour le désassemblage, l’assemblage, la décompilation, la visualisation graphique, la scriptabilité et la collaboration, capables d’analyser du code compilé sur Windows, macOS et Linux. Sa valeur centrale réside dans le fait qu’elle rend accessible à tous une capacité de décompilation de niveau industriel qui était auparavant réservée à quelques logiciels commerciaux comme IDA Pro.

La fonctionnalité la plus remarquée de Ghidra est son décompilateur. C’est la clé qui a considérablement abaissé la barrière de la rétro-ingénierie. Le décompilateur est capable de reconstruire les instructions assembleur de bas niveau en pseudo-code proche du langage C, permettant de comprendre la logique du programme sans lire instruction par instruction l’assembleur obscur.

Bien que le pseudo-code généré ne puisse pas être compilé directement, il accélère énormément le processus de compréhension. Si le décompilateur de Ghidra peut prendre en charge autant d’architectures de processeurs, c’est parce qu’il utilise deux langages internes : le P-Code et le SLEIGH.

Le P-Code est un langage de représentation intermédiaire : toutes les instructions assembleuses des différentes architectures sont traduites en une forme P-Code unifiée lors de l’analyse, et le décompilateur génère du code C à partir de ce P-Code.

Le SLEIGH est un langage permettant de décrire comment les jeux d’instructions d’un processeur se traduisent en P-Code. C’est cette conception qui permet à Ghidra d’étendre relativement facilement son support à de nouvelles architectures de processeurs.

Les architectures de processeurs prises en charge par Ghidra sont très nombreuses : x86 16/32/64 bits, ARM et AArch64, MIPS, PowerPC, SPARC, le bytecode Java/DEX, ainsi que de nombreuses architectures embarquées comme AVR, PIC, MSP430 et Z80. Cela la rend précieuse non seulement pour l’analyse de logiciels traditionnels, mais aussi pour l’audit de firmware et la recherche en sécurité des systèmes embarqués. En termes de maturité du support, les architectures grand public comme x86-64, x86, ARM/Thumb 32, AArch64, PowerPC et MIPS bénéficient du niveau de support le plus élevé.

Le décompilateur de Ghidra produit ce qu’on appelle souvent un pseudo-code C. Ce n’est pas une restitution du code source original. Les noms de fonctions sont génériques, du type FUN_00401a5, les variables s’appellent var_1 ou param_1, car le compilateur a supprimé les noms originaux lors de la compilation. Les commentaires, les noms de variables et les structures originales ont disparu. Le code obtenu n’est pas compilable en l’état : il contient des casts étranges, des types de données devinés et des constructions qui ne sont pas du C valide. Ghidra vous donne une aide à la compréhension, pas une reconstruction exacte. Vous devrez souvent renommer manuellement les fonctions et variables pour clarifier le code, corriger les types de données mal devinés et reconstruire les structures et définitions de types.

Continuer la lecture →

L’inférence en IA : kézako ?

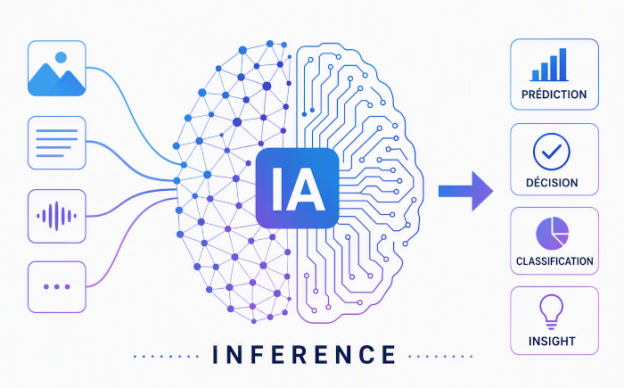
L’inférence dans le domaine de l’intelligence artificielle désigne le moment où un modèle déjà entraîné est mis à contribution pour produire une réponse, une prédiction ou une classification sur des données qu’il n’a pas vues auparavant.

C’est une étape distincte de l’entraînement, qui correspond à l’apprentissage proprement dit, et distincte aussi de l’évaluation, qui sert à mesurer la performance du modèle sur un jeu de test. L’inférence est donc la phase d’usage, celle qui se produit quand l’utilisateur interagit avec le système.

Le mot lui-même vient du latin inferre, formé de la préposition in et du verbe ferre, qui signifie porter. Le sens littéral est « porter vers, apporter en dedans », et l’usage philosophique et logique en a tiré l’idée de conduire une conclusion à partir d’éléments déjà connus.

Le français a repris ce terme dès le Moyen Âge dans le vocabulaire de la logique et de la scolastique.

Quand l’intelligence artificielle s’est constituée comme discipline, d’abord autour des systèmes experts et de la déduction formelle, le mot était déjà disponible et correspondait bien à ce que faisaient ces programmes : partir de faits et de règles pour aboutir à une conclusion. Le terme a été conservé lorsque l’apprentissage automatique puis l’apprentissage profond ont pris le dessus, même si le sens s’est élargi.

Aujourd’hui, l’inférence ne suppose plus nécessairement un raisonnement explicite au sens logique. Elle désigne simplement l’exécution du modèle entraîné, le calcul qui transforme une entrée en sortie.

En anglais, le terme est identique, inference, avec la même racine latine. On parle d’inference engine pour désigner le moteur qui exécute les calculs, d’inference time pour le temps de réponse, et de real-time inference pour les cas où la latence doit rester très faible. L’opposition classique en anglais est training contre inference, entraînement contre inférence, et cette opposition structure une grande partie du vocabulaire de la discipline.

Les poids du modèle ne changent pas pendant l’inférence. Le calcul est généralement plus léger que la rétropropagation utilisée pour l’entraînement, mais il doit souvent être répété un très grand nombre de fois, ce qui en fait la partie la plus coûteuse en production. Les optimisations portent sur la quantification, qui réduit la précision des nombres pour accélérer les calculs, sur la distillation, qui consiste à entraîner un petit modèle à imiter un grand, sur le regroupement des requêtes en lots, et sur l’usage de processeurs graphiques ou de puces spécialisées.

On cherche aussi à équilibrer la latence, c’est-à-dire le temps de réponse pour une requête donnée, et le débit, c’est-à-dire le nombre de requêtes traitées par unité de temps. Ces deux objectifs sont souvent en tension.

L’inférence se rencontre dans presque toutes les applications contemporaines. La reconnaissance faciale sur un téléphone, la traduction automatique, la détection d’objets dans une image, la génération de texte par un grand modèle de langage, la recommandation de contenu, la détection de fraude bancaire, le diagnostic médical assisté par ordinateur reposent sur des opérations d’inférence.

Dans le cas des grands modèles de langage, l’inférence se fait souvent de manière autoregressive, c’est-à-dire que le modèle produit un mot, puis s’en sert pour produire le suivant, et ainsi de suite. Cette manière de procéder explique une partie de la latence observée et justifie des techniques spécifiques comme le cache d’attention, qui évite de recalculer inutilement ce qui a déjà été calculé.

Le mot inférence conserve donc une double filiation. Il rappelle la logique et la philosophie, où il désigne l’acte de tirer une conclusion, et il s’est adapté à l’apprentissage automatique, où il désigne l’exécution d’un modèle entraîné. Ce glissement de sens n’est pas propre à l’intelligence artificielle : beaucoup de termes techniques migrent d’un domaine à un autre et se chargent de nuances nouvelles. Ce qui compte, pour éviter les malentendus, est de garder à l’esprit que dans le contexte de l’IA, inférence ne signifie pas raisonnement conscient ni déduction formelle, mais simplement production d’une sortie à partir d’une entrée par un modèle dont les paramètres sont figés.

GenOffice : l’alternative open-source qui réinvente la suite bureautique avec l’IA

Le 3 août 2026, la startup californienne Genspark a fait une entrée fracassante sur le marché des suites bureautiques en dévoilant GenOffice, présentée comme la « première suite bureautique open-source full-featured dotée d’une intelligence artificielle native » . Disponible pour Windows, MacOS et Linux, cette application se positionne comme une alternative crédible et radicalement différente des géants Microsoft Office et Google Workspace.

Une genèse hors normes

L’histoire de GenOffice est pour le moins atypique. Selon les informations communiquées par Genspark, la version alpha du logiciel a été développée par un seul ingénieur en l’espace d’une semaine, pour un coût opérationnel d’environ 10 000 dollars en tokens d’IA . Cette performance, rendue possible par l’utilisation intensive d’outils de programmation assistée par IA, illustre la transformation profonde des processus de développement logiciel à l’ère de l’IA générative .

Derrière ce projet se trouve Genspark, une entreprise déjà bien établie dans le domaine de l’IA. Fondée par d’anciens cadres de Baidu, la société aurait atteint un chiffre d’affaires annuel récurrent de 250 millions de dollars et une valorisation de 2,6 milliards de dollars . GenOffice n’est donc pas un simple projet expérimental, mais une pièce maîtresse dans la stratégie d’expansion de l’entreprise vers le marché grand public des outils de productivité.

Une suite complète et techniquement innovante

GenOffice intègre quatre modules principaux, couvrant l’essentiel des besoins bureautiques :

  • GenOffice Docs : un traitement de texte compatible avec les fichiers .docx.
  • GenOffice Sheets : un tableur pour les fichiers .xlsx, s’appuyant sur le moteur open-source Univer.
  • GenOffice Slides : un créateur de présentations pour les fichiers .pptx.
  • GenOffice PDF : un lecteur et éditeur de documents PDF.
Continuer la lecture →

Assistant IA local avec OpenCode et Ollama

Utiliser Claude comme assistant pour nous assister c’est très bien mais cela a tout de même un coût non négligeable. Parmi les alternatives existantes, l’auto-hébergement est une voie intéressante. Il faut cependant être tout de même conscient des limites.

En effet, avec des modèles d’IA auto-hébergés on ne bénéficie pas de la puissance de calcul des data centers des prestataires privés, ni des modèles aux performances les plus avancées. Par contre, c’est complètement gratuit et, pour peu qu’on installe des modèles d’IA adaptés aux performances de sa machine, on peut espérer mettre en place des outils qui répondent à 2 ou 3 tokens par seconde, ce qui est peu par rapport aux modèles payants, mais déjà pas si mal.

Pour mettre en place un tel outil, il est nécessaire de bien définir la machine visée, car le choix de modèles adaptés en découle.

Pour ce tutoriel nous allons viser une machine de type Asus Zenbook 13″ OLED (Intel Core i5, 16 Go RAM, sous Ubuntu 26.04)

Ce tutoriel vous permet d’installer un assistant IA local totalement gratuit, équivalent à Claude (pour les questions/réponses) et Claude Code (pour l’aide au codage en ligne de commande). Aucun abonnement ni connexion internet obligatoire (hors téléchargements initiaux).

Continuer la lecture →