Archives de catégorie : Application

Tutoriel Linux : auto-héberger IT-tools, une boîte de +80 outils IT indispensables

IT-tools est une boîte contenant plus de 80 outils IT indispensables aux personnes travaillant dans le domaine de l’IT. Il est auto-hébergeable sur un serveur en ligne via docker et programmé par le français Corentin Thomasset (ingénieur INSA Lyon).

Une instance en ligne est utilisable directement sur it-tools.tech pour ceux qui auraient la flemme de l’auto-héberger.
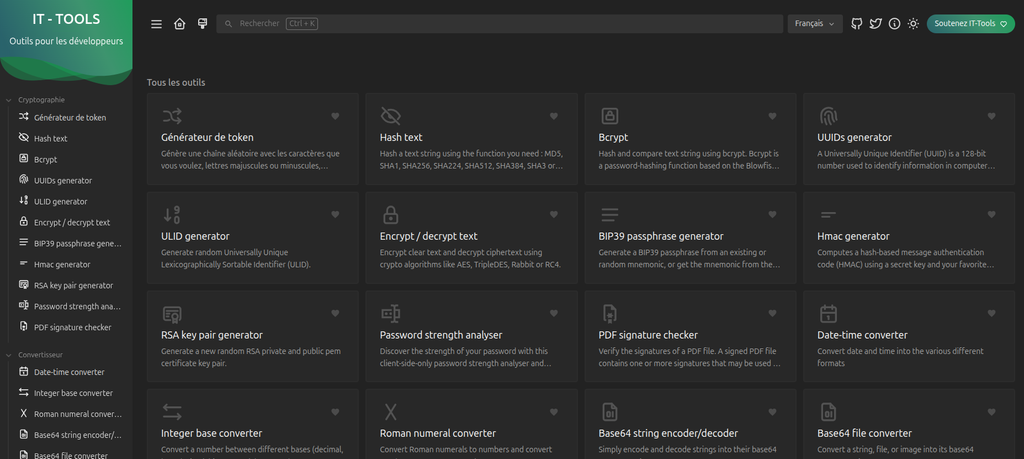
Indépendamment de disposer d’une interface web moderne ultra-léchée, la boîte à outil est incroyablement simple à auto-héberger sous docker.

Installation d’IT-tools avec docker compose

Créez un répertoire ittools-docker et mettez-y un fichier docker-compose.yml qui contient :

services:
    it-tools:
        image: ghcr.io/corentinth/it-tools:latest
        ports:
            - "8080:80"
        restart: unless-stopped
        container_name: it-tools

Lancez le service par :

docker compose up -d

Et voilà, c’est installé. Il n’y a plus qu’à se rendre sur http://serveur:8080 pour accéder à la boîte à outils.

Les outils mis à disposition

Le paramétrage de l’interface propose 8 langues, dont bien sûr le français.

Au niveau des outils mis à disposition, c’est le feu d’artifice.

Chaque rubrique propose au moins une dizaine d’outils utilisables d’un clic. Les rubriques couvrent la cryptographie, la conversion de formats, les outils web, la génération de qr codes, le développement, les réseaux, les maths, les mesures, les manipulations de textes, les données.

A chaque mise à jour de l’image docker, on bénéficie d’outils supplémentaires.

Bémol

Attention, la configuration du docker-compose.yml présentée ici aboutit non seulement à un outil en http et non en https, mais aussi un outil accessible à n’importe quel internaute qui connaîtrait l’URL du service.

La seule manière de rendre ce service privé serait de le cacher derrière un reverse proxy présentant à l’internaute une authentification basique.
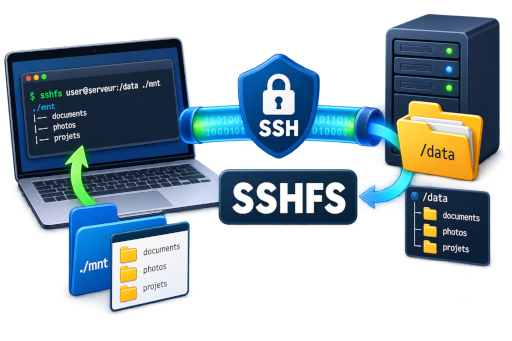
Tutoriel Linux : monter un répertoire distant avec sshfs

Le noyau Linux supporte un certain nombre de systèmes de fichiers divers et variés (ext2, 3, 4, NTFS, VFAT, etc.). Ce support se fait via des drivers dans le noyau, soit codés en dur et choisis au moment de la compilation du noyau, soit montés dynamiquement sous forme de modules chargeables.

Cependant en octobre 2005, à partir de la version 2.6.14 du noyau Linux, est apparue une fonctionnalité très intéressante : la possibilité donnée aux programmes en espace utilisateur de créer et monter leur propres systèmes de fichiers virtuels, sans avoir à écrire du code noyau.

Cette fonctionnalité, appelée Fuse pour Filesystem in userspace, a été créée par Miklos Szeredi. Cette approche visait à simplifier le développement de systèmes de fichiers, à améliorer la sécurité et la stabilité du système en isolant ces programmes en espace utilisateur, et à résoudre des problèmes de licence liés au développement de modules noyau. FUSE a d’abord été un projet séparé sur SourceForge avant d’être officiellement intégré au noyau Linux.

SSHFS grâce à Fuse

Une fois Fuse disponible sous Linux, beaucoup de programmeurs ont commencé à coder le support Fuse de beaucoup de systèmes de fichiers différents et innovants. Cette tâche de programmation n’est pas forcément aisée car les règles de code source à utiliser sont assez techniques (voir par exemple ce tutoriel en anglais, de l’université du nouveau Mexique).

Parmi ces systèmes de fichiers innovants dont le support à été programmé en utilisant Fuse, il y a SSHFS. Comme son nom l’indique, il permet de monter un répertoire distant dans l’arborescence locale en utilisant le tunnel ssh présent entre les deux machines comme canal de communication sous-jacent.

Continuer la lecture

PC portable Ubuntu : préserver la durée de vie de la batterie avec tlp

Le problème

Vous avez un PC portable tout neuf, vous avez installé Ubuntu dessus, tout va bien. Sauf qu’au bout de 2 ou 3 ans vous observez que l’autonomie de votre batterie interne à chuté de 50% !

Vous êtes bon pour avoir à changer la batterie.

Sans le savoir vous avez commis une erreur de débutant : vous n’avez pas installé tlp.

La solution : tlp

Sous Ubuntu, la gestion de la batterie d’un ordinateur portable est assurée par défaut par un service appelé power-profiles-daemon. Il permet de choisir entre trois profils de consommation (« Performance », « Équilibré », « Économie d’énergie ») via l’interface GNOME.

Ce service remplit correctement sa mission : ajuster la consommation électrique en fonction des besoins immédiats de l’utilisateur.

Il ne remplit en revanche pas une autre mission, pourtant essentielle à la longévité du matériel : la préservation de la capacité de la batterie dans le temps. C’est là qu’intervient tlp.

Ce qui se passe sans tlp

Lorsque vous installez Ubuntu et que vous utilisez votre ordinateur portable sans tlp voici ce qui se produit :

1. La batterie est systématiquement chargée à 100 %

Chaque fois que vous branchez votre PC, il se recharge jusqu’à 100 %. C’est le comportement standard de tous les systèmes d’exploitation grand public. Or, maintenir une batterie lithium-ion à 100 % de charge, surtout lorsqu’elle est branchée en permanence, accélère sa dégradation chimique.

2. Une usure prématurée des cellules

Après quelques centaines de cycles de charge, la capacité maximale de la batterie diminue. Ce phénomène est irréversible : les cellules lithium-ion perdent progressivement leur capacité à stocker de l’énergie.

3. Une autonomie réduite

Après 400 à 500 cycles, une batterie ayant toujours été chargée à 100 % peut avoir perdu 30 à 45 % de sa capacité d’origine. L’autonomie chute donc mécaniquement.

4. Un remplacement inévitable

À partir de 60 % de capacité restante, l’autonomie devient insuffisante pour un usage nomade confortable. Le remplacement de la batterie est alors la seule solution.

Continuer la lecture

Tutoriel Linux : auto-héberger le moteur d’automatisation n8n

Si vous cherchez à faire communiquer entre eux des outils comme Google Sheets, Slack, Notion ou votre base de données, n8n est une solution qui mérite le détour. C’est un outil d’automatisation de workflows, un peu dans l’esprit de Zapier ou Make, mais avec une différence importante : vous pouvez l’installer sur vos propres serveurs.

N8n fonctionne avec un modèle « fair-code ». Le code est accessible et modifiable, mais avec quelques restrictions : vous ne pouvez pas revendre la plateforme comme un service hébergé à des tiers. C’est un entre-deux entre le logiciel open-source pur et les solutions totalement fermées.

La version gratuite (appelée Community Edition) peut tourner sur votre infrastructure sans limitation de nombre d’exécutions ni de workflows. Vos données restent chez vous, ce qui peut être un argument décisif si vous travaillez avec des informations sensibles. Si vous préférez éviter de gérer l’installation, une version cloud existe aussi, mais elle est payante.

L’installation avec Docker est simple. Il suffit de lancer le conteneur avec l’image officielle, d’exposer le port 5678 qui est celui de l’interface web, et de monter un volume pour que vos données (workflows, identifiants, paramètres) soient conservées d’un redémarrage à l’autre. Pas besoin de base de données externe pour commencer : n8n utilise SQLite par défaut, un fichier unique léger qui fait très bien l’affaire pour un usage individuel ou en petite équipe.

Principe de fonctionnement

Le principe est simple : vous construisez des workflows en reliant des « neuds » (ou nodes) graphiques à l’écran. Chaque neud correspond à une action ou à une intégration avec un service. n8n en propose plus de 500, ce qui couvre déjà pas mal de besoins courants.

Parmi les intégrations disponibles, on trouve :

  • Les outils de messagerie comme Slack, Teams, Discord ou Telegram
  • Les applications de productivité : Notion, Asana, Jira, Trello
  • L’écosystème Google : Sheets, Drive, Gmail, Calendar
  • Les CRM : HubSpot, Salesforce, Pipedrive
  • Les bases de données : PostgreSQL, MySQL, MongoDB, Redis
  • Les services cloud : AWS, Google Cloud, etc.

Et si le service que vous voulez utiliser n’est pas dans la liste, vous avez toujours la possibilité d’utiliser le neud « HTTP Request » pour envoyer des requêtes à n’importe quelle API. Il y a aussi un neud « Code » qui permet d’écrire un peu de JavaScript ou de Python pour faire des traitements personnalisés.

L’éditeur visuel intègre un débogueur. Vous pouvez voir à chaque étape du workflow ce qui entre et ce qui sort, ce qui aide beaucoup quand un workflow ne fonctionne pas comme prévu.

Continuer la lecture

Tutoriel Linux : auto héberger ses codes source avec Forgejo

Forgejo est une plateforme d’hébergement de code, de suivi de bugs et de révision de code, à installer sur vos propres serveurs. Elle permet à une équipe de gérer ses dépôts Git, ses tickets (issues), ses demandes de fusion (pull requests) et ses wiki, le tout dans une interface proche de GitHub ou GitLab. Elle intègre également un système d’automatisation (Forgejo Actions) pour exécuter des tests ou des tâches à chaque mise à jour du code.

Forgejo est né en octobre 2022. À cette date, la société Gitea Ltd, à but lucratif, a pris le contrôle du projet Gitea, sans consultation préalable de la communauté. En réaction, un groupe d’anciens mainteneurs de Gitea et de contributeurs du logiciel libre a proposé de créer un fork (une bifurcation) sous l’égide de Codeberg e.V.. La proposition a été acceptée le 16 novembre 2022, et le projet a été annoncé officiellement le 15 décembre 2022.

Initialement présenté comme un « soft fork » (un fork qui suit encore de près Gitea), Forgejo a ensuite pris ses distances. En février 2024, il est devenu un « hard fork », affirmant des choix de gouvernance et de développement durablement différents.

Gouvernance du projet

Forgejo est placé sous la tutelle de Codeberg e.V., une association à but non lucratif et démocratique, dédiée au logiciel libre, enregistrée à Berlin. Codeberg e.V. possède les noms de domaine de Forgejo et fournit des ressources.

La gouvernance du projet est définie collectivement par ses contributeurs, avec un processus de décision ouvert et transparent. Tout le développement, les tests et les publications sont réalisés exclusivement avec des logiciels libres. En août 2024, Forgejo a adopté la licence GNU GPL version 3 ou ultérieure.

Installation sous Docker

L’installation se fait grâce à un conteneur docker, il faut donc que votre serveur soit prêt à lancer des services docker. Si ce n’est pas le cas, vous trouverez le guide d’installation docker sous Ubuntu ici et celui de Devuan ici.

Continuer la lecture

Tutoriel Linux : Auto-héberger son agrégateur de nouvelles (RSS)

Il y a beaucoup de manières de consommer les actualités : soit en allant voir site par site, soit en utilisant un agrégateur de nouvelles qui pré-digère les actualités et les centralise.

Il y a beaucoup de logiciels agrégateurs de nouvelles qui existent, mais ici nous allons utiliser Fusion, à installer via docker soit sur son PC perso, soit sur un serveur.

Avec un tel agrégateur de nouvelles nos préférences de lecture ne sont pas connues de tiers, et nos flux de lecture d’articles seront accessibles depuis n’importe quel appareil avec un simple navigateur web, y compris sur un smartphone, l’interface web de fusion étant prévue pour s’adapter au format du lecteur.

Nous allons ni plus ni moins bâtir notre journal d’actualités en ligne, privé.

Fusion permet de s’abonner à tout flux RSS disponible sur Internet, et classer les flux par groupe (Actualités, Tech, Sport, Cuisine, …)

Installation de Fusion sur le serveur

L’installation se fait grâce à un conteneur docker, il faut donc que votre serveur soit prêt à lancer des services docker. Si ce n’est pas le cas, vous trouverez le guide d’installation docker sous Ubuntu ici et celui de Devuan ici.

Nous allons créer un répertoire fusion-docker et y mettre le fichier docker-compose.yml

cd
mkdir fusion-docker
cd fusion-docker

Dans le fichier docker-compose.yml, nous allons mettre (remplacer mot de passe par le mot de passe que vous choisissez) :

services:
  fusion:
    image: ghcr.io/0x2e/fusion:latest
    container_name: fusion
    restart: unless-stopped
    environment:
      - TZ=UTC
      - PASSWORD=motdepasse
    volumes:
      - ./fusion-data:/data
    ports:
      - "8080:8080"

Le service Fusion se lance par la commande :

docker compose up –d

Pour utiliser le service, il faut se connecter sur http://serveur:8080

Continuer la lecture

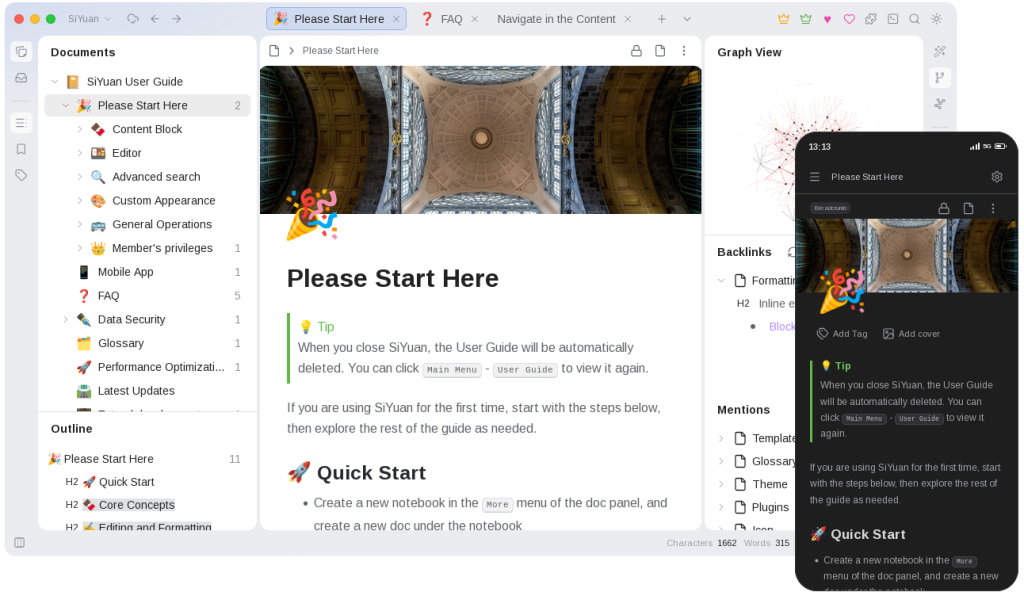
Tutoriel Linux : auto-héberger Siyuan, le Notion gratuit

Notion est devenu au fil des années l’outil de référence pour la prise de notes des jeunes. C’est un produit très bon mais pas donné, et qui ne propose pas de version auto-hébergeable.

Siyuan est la réponse chinoise à Notion. Si le produit n’est pas donné non plus, du moins en version nomale en ligne (sur le modèle de Notion), la différence est qu’on peut l’auto-héberger facilement et surtout gratuitement sur un serveur. C’est cette fonctionnalité d’auto-hébergement gratuite que nous allons utiliser dans ce tutoriel.

Au niveau des fonctionnalités, Siyuan permet de faire pratiquement tout ce que l’on peut faire sur Notion en termes de prise de notes. Une application Android existe également mais elle ne permet de se connecter que sur le serveur officiel payant de Siyuan, pas aux instances d’auto-hébergement gratuites.

Installation de la version auto-hébergeable de Siyuan sur un serveur Linux

Continuer la lecture

Tutoriel Linux : TorServ le serveur web Tor qui tient dans un binaire

TorServ est un serveur web statique « durci » (hardened) qui a une particularité unique : il intègre nativement le réseau Tor et se configure tout seul pour devenir un service caché (hidden service) .

Concrètement, il vous suffit de lancer le programme dans un dossier contenant vos fichiers HTML, et en quelques secondes, votre site est accessible via une adresse en .onion​ sur le dark web, sans aucune configuration complexe.

L’objectif principal est de permettre la publication anonyme et la résistance à la censure, même dans des environnements à haut risque. Le projet est open-source et écrit en Go .

Les caractéristiques qui le rendent unique

TorServ ne se contente pas de « simplifier » la configuration d’un service Tor. Il est conçu dès le départ avec la sécurité et l’anonymat comme priorités absolues.

  • Zéro configuration : C’est sa promesse phare. L’outil contient tout le nécessaire (le binaire de Tor est inclus). On décompresse et on exécute .
  • Sécurité et anonymat avancés :
    • Aucune journalisation (No logs) : Par conception, TorServ n’enregistre aucune requête, ce qui le rend muet même en cas de compromission .
    • Pas d’exposition sur le clearnet : Le serveur web n’écoute que sur votre propre machine (127.0.0.1​). Il est donc impossible d’y accéder directement par une adresse IP classique .
    • Nettoyage des métadonnées : Il supprime automatiquement les données EXIF des images (JPEG, PNG, GIF, BMP) avant de les servir, évitant ainsi les fuites d’informations .
    • Obfuscation du trafic : Pour contrer l’analyse du trafic, il ajoute un délai aléatoire (entre 50 et 200ms) sur les réponses et uniformise la taille des paquets de données .
    • Piège à robots : Si un robot scanne votre site à la recherche de dossiers inexistants, TorServ lui renvoie lentement des données sans intérêt au lieu d’une erreur 404 classique .
    • Headers HTTP sécurisés : Il supprime les en-têtes qui pourraient fournir des informations sur le serveur (comme Date​, ETag​, Last-Modified​) .
  • Simplicité d’utilisation : Une fois lancé, le programme vous affiche directement votre nouvelle adresse .onion​. Vous n’avez rien d’autre à faire .
  • Sandboxing automatique : Si firejail​ est installé sur votre système, TorServ s’y exécutera automatiquement pour limiter les dégâts en cas de faille de sécurité .

Limitations importantes à connaître

Avant de vous lancer, il est crucial de comprendre les cas d’usage de TorServ et ses limites :

  • Contenu statique uniquement : Oubliez WordPress, PHP, bases de données ou formulaires interactifs. TorServ ne sert que des fichiers HTML, CSS, JavaScript et images .
  • Pas de support des PDF : Par mesure de sécurité (à cause des métadonnées et scripts potentiels), TorServ refuse de servir les fichiers PDF .
  • Pas de compression HTTPS/Gzip : La compression est désactivée pour prévenir certains types d’attaques (comme BREACH). Le chiffrement est de toute façon assuré par le réseau Tor .
  • Projet récent : Bien que fonctionnel, il n’a pas la maturité et la base d’utilisateurs d’un serveur comme Apache ou Nginx .

Guide d’installation et d’utilisation sur Ubuntu

Continuer la lecture

Tutoriel Linux : sauvegarder son serveur avec rsyncy

Lorsqu’on dispose d’un serveur en ligne, il est indispensable d’en sauvegarder les répertoires contenant les données que l’on ne veut surtout pas perdre. Mais il est aussi très important de sauvegarder les données stockées en bases de données.

Sous Linux il existe pléthore de logiciels spécialisés pour réaliser cela, mais nous allons voir ici comment le faire avec rsyncy

Sauvegarder le contenu des bases de données MySQL

Allez sur votre serveur et dans un shell bash tapez (remplacez MonMotDePasse et mabase respectivement par le mot de passe et le nom de la base de données MySQL à sauvegarder :

mysqldump --user='root' --password='MonMotDePasse' mabase > mabase.sql

Cette commande produit un fichier mabase.sql qui est auto-porteur, c’est à dire que si un jour vous avez à restaurer la base de données, il suffira d’exécuter ce fichier sql par la commande ci-dessous, lancée depuis l’utilitaire mysql connecté à votre base de données vide (mysql -u utilisateur -p mabase) :

source ./mabase.sql;

Vous pouvez mettre autant de commandes mysqldump que vous le souhaitez dans un shell script bash, et ainsi créer autant de fichier .sql de sauvegarde que nécessaire, dans un répertoire que nous allons sauvegarder sur une machine distante grâce à rsyncy.

Rsyncy va vous permettre de respecter la règle de base pour les sauvegardes, à savoir : la règle du 3-2-1-1-0 :

  • 3 copies de sauvegarde
  • 2 supports différents
  • 1 sauvegarde hors site
  • 1 copie hors ligne
  • 0 erreur testée à la restauration

Rsync et rsyncy

Continuer la lecture

Tutoriel Linux : comment auto-héberger sa messagerie instantanée

Avec des messageries instantanées comme Whatsapp, Telegram ou Signal, il est si facile de communiquer avec ses amis, de s’échanger des photos, des documents, voire de s’appeler au téléphone ou en vidéo, le tout bien sûr chiffré de bout en bout.

Le problème sous-jacent est que, dans ces applications, vos données ne vous appartiennent pas. Elles sont stockées quelque part dans le cloud, chez Meta ou autre, vous ne les maîtrisez pas. Elles peuvent disparaître demain, les récupérer peut devenir payant ou impossible demain, vous subirez.

Si le produit ment et qu’il n’est pas chiffré de bout en bout, vos conversations sont lues par d’autres.

Il est pourtant très simple d’auto-héberger sa messagerie instantanée.

La question que vous vous posez peut-être est : « ok, si j’auto-héberge ma messagerie instantanée, est-ce-que je pourrai communiquer avec mes amis sur Whatsapp ou Telegram ? »

En fait nous allons utiliser le protocole Matrix, qui a été créé justement parce que ses créateurs se demandaient pourquoi un utilisateur d’une messagerie instantanée A (Whatsapp par exemple) ne pouvait pas converser avec les utilisateurs d’une messagerie B (Signal par exemple).

Ils se sont dit que, dans un monde idéal, il y aurait un seul langage universel pour toutes les messageries, tout le monde pouvant ainsi converser avec tout le monde, et chacun pouvant choisir son logiciel favori compatible de ce langage universel.

Du coup ils ont codé ce langage universel et appelé ce protocole Matrix.

L’état français a adopté ce protocole pour son application de messagerie instantanée ministérielle Tchap.

A l’exception de Tchap (qui est du Matrix mais sur un réseau privé dédié), toutes les instances Matrix sont en réseau.

Cela signifie que, si nous installons un serveur Matrix sur notre serveur Linux, non seulement nous pourrons converser à la sauce Whatsapp entre utilisateurs de cette messagerie, mais nous pourrons aussi converser avec les utilisateurs de toutes les autres instances Matrix existant sur Internet.

Dans ce réseau global Matrix, chaque utilisateur est identifié par une adresse du type @utilisateur:serveur

Si nous montons un serveur Matrix sur notre serveur dont le nom de domaine est votre_domaine.duckdns.org par exemple, alors l’utilisateur toto aura comme adresse Matrix @toto:votre_domaine.duckdns.org

Continuer la lecture