Archives de catégorie : Tutoriel

Tutoriel Linux : coder avec un modèle IA local (Ollama + Lumen)

Je me suis rendu compte à l’usage que mon article sur le codage local avec Ollama et Opencode n’était pas viable, Opencode étant plus prévu finalement pour faire fonctionner des modèles IA en ligne plutôt qu’Ollama en local.

Voici donc un nouveau tuto QUI MARCHE !

Installation et configuration d’Ollama

Ollama est le moteur qui fera tourner vos modèles localement.

1. Installation
La méthode la plus simple est le script officiel. Il installe Ollama, configure un service systemd et démarre le service automatiquement .

curl -fsSL https://ollama.com/install.sh | sh

2. Vérification
Après l’installation, vérifiez que le service est actif et que la commande fonctionne.

# Vérifier la version
ollama -v

# Vérifier que le service systemd est actif
sudo systemctl status ollama

Si le service n’est pas actif, démarrez-le avec sudo systemctl start ollama .

3. Téléchargement d’un modèle adapté
Pour Lumen, il faut un modèle capable de « tool calling ». D’après mon expérience, qwen3-vl:8b fonctionne bien avec Lumen. Vous pouvez aussi utiliser d’autres modèles compatibles comme ceux recommandés par Lumen (qwen3-coder:30b, etc.) .

# Télécharger le modèle (adapte selon tes besoins)
ollama pull qwen3-vl:8b

4. Maintenance (Mise à jour)
Pour mettre à jour Ollama, il suffit de relancer le script d’installation. Il remplacera l’ancienne version par la nouvelle .

curl -fsSL https://ollama.com/install.sh | sh

5. Désinstallation complète
Si vous souhaitez tout supprimer (service, binaires, modèles et utilisateur système) :

# Arrêter et désactiver le service
sudo systemctl stop ollama
sudo systemctl disable ollama
sudo rm /etc/systemd/system/ollama.service

# Supprimer les bibliothèques et le binaire
sudo rm -r $(which ollama | tr 'bin' 'lib')
sudo rm $(which ollama)

# Supprimer l'utilisateur, le groupe et les modèles téléchargés
sudo userdel ollama
sudo groupdel ollama
sudo rm -r /usr/share/ollama
Continuer la lecture →

Tutoriel Linux : reverse engineering avec Ghidra

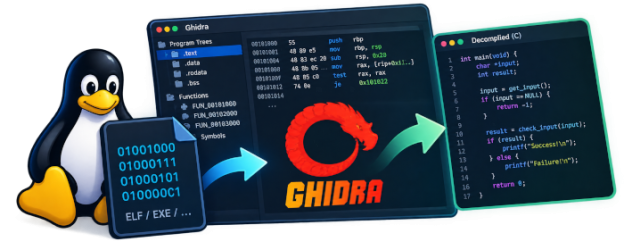
Ghidra est un framework de rétro-ingénierie logicielle développé et maintenu par la Direction de la recherche de la National Security Agency américaine. Il a été officiellement open source en mars 2019 lors de la conférence RSA, sous licence Apache 2.0, ce qui signifie que n’importe qui peut l’utiliser, le modifier et le redistribuer gratuitement. Avant cela, il était utilisé en interne par la NSA pendant des années pour répondre aux défis de rétro-ingénierie les plus complexes de l’agence.

Dans son essence, Ghidra n’est pas un programme unique mais une plateforme d’analyse complète. Elle regroupe un ensemble d’outils de haut niveau pour le désassemblage, l’assemblage, la décompilation, la visualisation graphique, la scriptabilité et la collaboration, capables d’analyser du code compilé sur Windows, macOS et Linux. Sa valeur centrale réside dans le fait qu’elle rend accessible à tous une capacité de décompilation de niveau industriel qui était auparavant réservée à quelques logiciels commerciaux comme IDA Pro.

La fonctionnalité la plus remarquée de Ghidra est son décompilateur. C’est la clé qui a considérablement abaissé la barrière de la rétro-ingénierie. Le décompilateur est capable de reconstruire les instructions assembleur de bas niveau en pseudo-code proche du langage C, permettant de comprendre la logique du programme sans lire instruction par instruction l’assembleur obscur.

Bien que le pseudo-code généré ne puisse pas être compilé directement, il accélère énormément le processus de compréhension. Si le décompilateur de Ghidra peut prendre en charge autant d’architectures de processeurs, c’est parce qu’il utilise deux langages internes : le P-Code et le SLEIGH.

Le P-Code est un langage de représentation intermédiaire : toutes les instructions assembleuses des différentes architectures sont traduites en une forme P-Code unifiée lors de l’analyse, et le décompilateur génère du code C à partir de ce P-Code.

Le SLEIGH est un langage permettant de décrire comment les jeux d’instructions d’un processeur se traduisent en P-Code. C’est cette conception qui permet à Ghidra d’étendre relativement facilement son support à de nouvelles architectures de processeurs.

Les architectures de processeurs prises en charge par Ghidra sont très nombreuses : x86 16/32/64 bits, ARM et AArch64, MIPS, PowerPC, SPARC, le bytecode Java/DEX, ainsi que de nombreuses architectures embarquées comme AVR, PIC, MSP430 et Z80. Cela la rend précieuse non seulement pour l’analyse de logiciels traditionnels, mais aussi pour l’audit de firmware et la recherche en sécurité des systèmes embarqués. En termes de maturité du support, les architectures grand public comme x86-64, x86, ARM/Thumb 32, AArch64, PowerPC et MIPS bénéficient du niveau de support le plus élevé.

Le décompilateur de Ghidra produit ce qu’on appelle souvent un pseudo-code C. Ce n’est pas une restitution du code source original. Les noms de fonctions sont génériques, du type FUN_00401a5, les variables s’appellent var_1 ou param_1, car le compilateur a supprimé les noms originaux lors de la compilation. Les commentaires, les noms de variables et les structures originales ont disparu. Le code obtenu n’est pas compilable en l’état : il contient des casts étranges, des types de données devinés et des constructions qui ne sont pas du C valide. Ghidra vous donne une aide à la compréhension, pas une reconstruction exacte. Vous devrez souvent renommer manuellement les fonctions et variables pour clarifier le code, corriger les types de données mal devinés et reconstruire les structures et définitions de types.

Continuer la lecture →

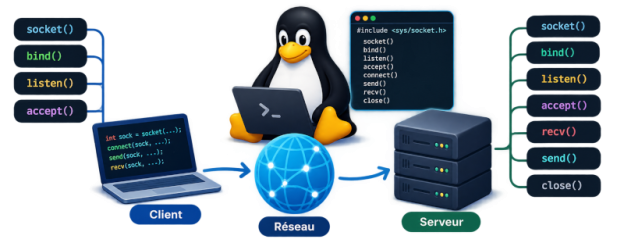
Tutoriel Linux : Les sockets réseau (Travaux pratiques)

Pour faire suite à l’article sur la théorie, voici l’article sur la pratique en C.

Le principe est simple : tout d’abord nous allons mettre toutes les fonctions en C dont ont besoin un client ou un serveur pour gérer les sockets réseau dans un couple de fichiers sockets.h et sockets.c que voici :

sockets.h :

/*
 * sockets.h
 * ---------
 * Interface des fonctions réseau TCP/UDP, compatible IPv4 et IPv6.
 */
#ifndef SOCKETS_H
#define SOCKETS_H

#include <stddef.h>   /* pour size_t */

/*
 * Crée une socket TCP en écoute sur le port donné (ex: "56000").
 * Retourne un descripteur prêt pour accepter_client(), ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_tcp(const char *port);

/*
 * Crée une socket UDP liée au port donné.
 * Retourne un descripteur, ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_udp(const char *port);

/*
 * Se connecte en TCP à hote:port (IPv4 ou IPv6, automatique).
 * Retourne un descripteur connecté, ou -1.
 */
int contacter_socket_tcp(const char *hote, const char *port);

/*
 * Se connecte en UDP à hote:port.
 * Retourne un descripteur, ou -1.
 */
int contacter_socket_udp(const char *hote, const char *port);

/*
 * Accepte une connexion entrante sur la socket d'écoute fd_ecoute.
 * - fd_ecoute       : descripteur renvoyé par etablir_socket_ecoute_tcp()
 * - adresse_client  : buffer où sera écrite l'adresse IP du client
 *                     (chaîne lisible, ex: "127.0.0.1" ou "::1")
 * - taille_adresse  : taille du buffer ci-dessus
 *
 * Retourne le descripteur de la connexion client, ou -1.
 * Aucun struct sockaddr n'est exposé à l'appelant.
 */
int accepter_client(int fd_ecoute, char *adresse_client, size_t taille_adresse);

#endif /* SOCKETS_H */

Comme on peut le voir, on a à notre disposition 4 fonctions : 2 fonctions destinées à être utilisées par les programmes serveurs (etablir_socket_ecoute_tcp et etablir_socket_ecoute_tcp) et 2 fonctions destinées à être utilisées par les programmes clients (contacter_socket_tcp et contacter_socket_udp).

Le code de ces fonctions est prévu pour tenter des connexions IPv6 si disponible, et de basculer automatiquement sur IPv4 si IPv6 n’est pas disponible pour la connexion.

Continuer la lecture →

Tutoriel Linux : Les sockets réseau

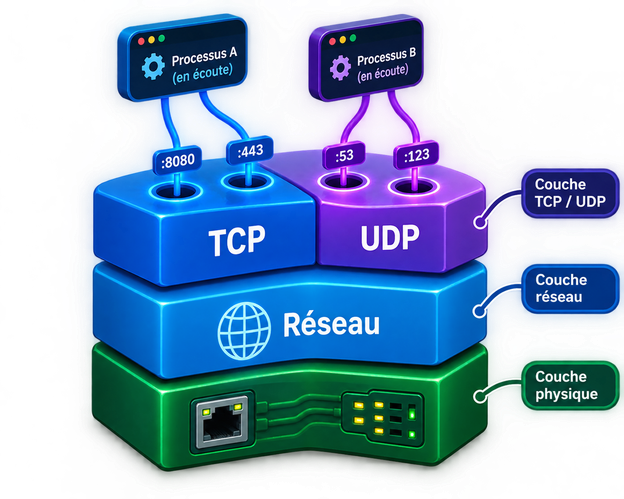
Les sockets font partie des mécanismes qui permettent aux processus de communiquer entre eux. Cependant, contrairement aux IPC classiques (segments de mémoire partagée, queues de messages, et même pipes), ce mécanisme est prévu pour faire communiquer des processus situés sur … des machines différentes.

Et comme les machines sont différentes et qu’il a bien fallu inventer des standards, les processus qui vont communiquer via ces mécanismes sont situés sur des machines différentes … dont le système d’exploitation est potentiellement différent.

Ainsi, via les sockets, une machine Linux va pouvoir communiquer avec un Mac ou une machine Windows, et inversement.

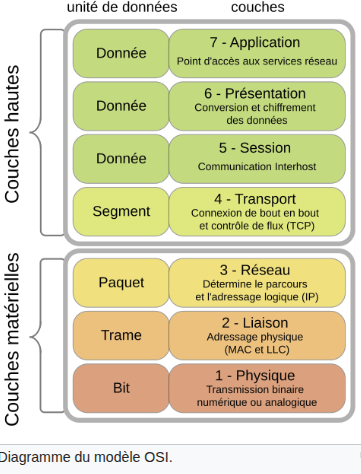
Le modèle OSI

Toutes les machines qui souhaitent communiquer avec d’autres doivent se conformer au modèle OSI.

Avec ce modèle, les logiciels réseaux installés sur chaque machine sont rangés en 7 couches en théorie.

Au niveau 7 on a l’application qui veut communiquer avec une autre application, située elle aussi au niveau 7 sur une autre machine.

Les données que l’application souhaite envoyer à l’autre application descendent successivement les couches réseaux de la machine de départ, chaque couche encapsulant les données reçues de la couche du dessus et à destination de la couche équivalente sur la machine d’arrivée.

La dernière couche qui reçoit les données est la couche physique (couche 1) et c’est de là que les données quittent la machine sous forme de paquets. Ces paquets trouvent leur chemin vers la machine destination (qui peut être sur Internet, donc potentiellement de l’autre côté de la Terre) via un réseau de routeurs qui sont hors sujets dans le cadre de cet article.

Arrivés à la machine destination (potentiellement dans le désordre), ces paquets remontent les 7 couches de celle-ci (en désencapsulant à chaque couche) jusqu’à ce qu’ils soient délivrés à l’application (couche 7) qui attend ces données sur la machine destinatrice.

Bien sûr, l’application destinatrice pourra elle aussi envoyer des données de réponse à l’application émettrice en utilisant la mécanique inverse.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 11) – Travaux pratiques sur les segments de mémoire partagés

Comme nous l’avons vu dans l’épisode 2, les processus sont exécutés en mémoire sur des pages virtuelles, ce qui garantit une étanchéité totale entre eux. Ceci oblige à passer par les mécanismes offerts par le noyau pour faire transiter des informations d’un processus à l’autre. Ces mécanismes ont été survolés lors de l’épisode 5.

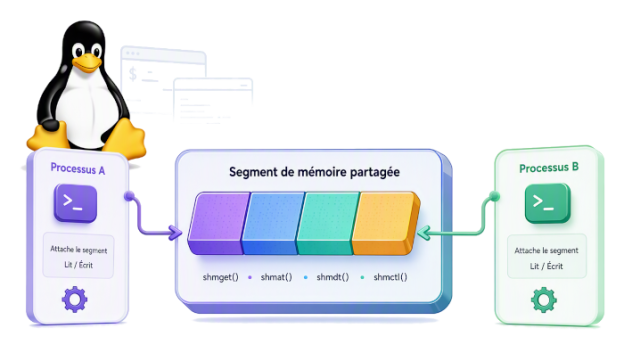
Parmi ces mécanismes, on trouve les segments de mémoire partagée.

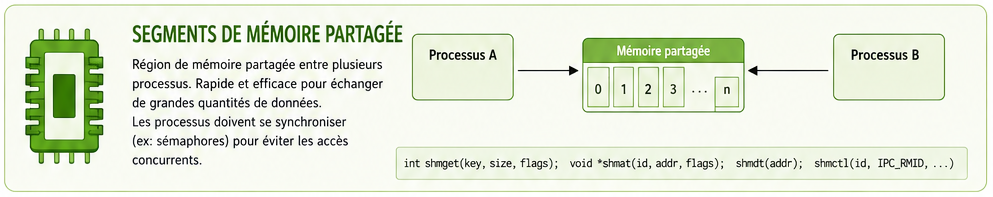
Le noyau peut en effet allouer des pages de mémoire virtuelle partagées que les processus peuvent monter dans leur espace mémoire. Ces pages, appelés segments de mémoire partagés, peuvent être montés par plusieurs processus, créant ainsi une zone d’échange de données permettant de traiter de (relativement) gros volumes de données.

Mais attention, l’accès concurrent à des données partagées pose des problèmes de stabilité et de fiabilité de ces données qui sont insoupçonnables tant qu’on n’a pas expérimenté ce type de programmation concurrente. C’est un sujet qu’on étudie lorsqu’on fait ses études d’informatique. La solution est simple pourtant : aucun processus ne doit accéder à ces données en même temps qu’un autre processus, ce qui oblige à considérer les sections d’accès aux données comme du code critique, dont l’accès doit être protégé par un sémaphore.

Nous avons vu comment mettre en oeuvre les sémaphores dans l’épisode 10.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 10) – Travaux pratiques sur les sémaphores

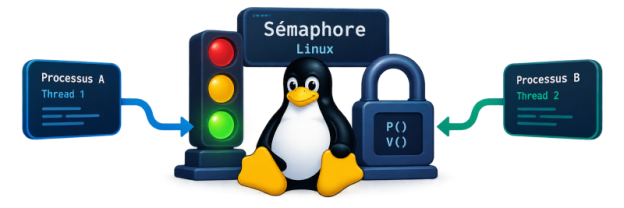
Comme nous l’avons vu dans l’épisode 5, les sémaphores sont des grappes de jetons qui permettent de protéger l’accès à des sections de code critiques. Critiques dans le sens où : si deux processus ou deux processus légers (threads) exécutent la même section de code en même temps alors la valeur des variables devient indéterminée.

Le cas typique est du code qui lit ou écrit des variables dans un segment de mémoire partagée. Si deux processus accèdent à la même variable dans un segment de mémoire partagée, même si l’un ne fait que lire le contenu de la variable et l’autre ne fait qu’y écrire, l’accès à la variable doit être protégé par un sémaphore.

Un sémaphore est un jeton, qu’on décrémente en réalisant une opération P (via un appel système au noyau) et qu’on incrémente en faisant une opération V (via un autre appel système au noyau).

Si un processus fait une opération P, la valeur du jeton (qu’on fixe initialement) est décrémentée. Tant que cette valeur n’atteint pas 0, rien d’autre ne se passe. Si par contre l’opération de décrémentation donne 0, alors le processus appelant cet appel système est bloqué par le noyau en attente qu’un autre processus fasse une opération V pour rendre un jeton.

Ainsi, un sémaphore initialisé à la valeur 1 garantit qu’un seul processus à la fois sera dans une section de code critique donnée. Et un sémaphore initialisé à la valeur N garantit qu’au plus N processus pourront se retrouver simultanément dans une section de code critique.

Vous l’avez compris, les sémaphores sont un mécanisme très puissant et indispensable, mais un mécanisme dangereux car il peut y avoir une perte de jeton. Les deux cas dans lesquels les programmeurs doivent impérativement éviter de tomber sont :

  • le cas où un programme « oublie » de rendre le jeton lorsqu’il quitte la section de code critique. Dans ce cas, tous les autres processus qui attendent la libération du jeton pour y rentrer sont bloqués ad vitam
  • Et le cas qu’on appelle « Etreinte fatale » (deadlock en anglais) qui est celui où un processus A disposant du jeton 1 demande le jeton 2 (non disponible car détenu par B), et où un processus B disposant du jeton 2 demande le jeton 1 (non disponible car détenu par A). Chaque processus attend la libération du jeton de l’autre.

Les sémaphores sont très souvent initialisés à 1. Dans ce cas on les appelle des mutex (exclusion mutuelle). Cependant, par commodité, les appels système permettant de les manipuler les manipulent par grappe de plusieurs sémaphores.

Continuer la lecture →

Tutoriel Linux : sécuriser NginX avec mTLS (authentification mutuelle)

Lorsqu’on auto-héberge des services accessibles par le web, il est courant d’utiliser le serveur web NginX.

Le cadre architectural dans lequel on travaille est toujours le même :

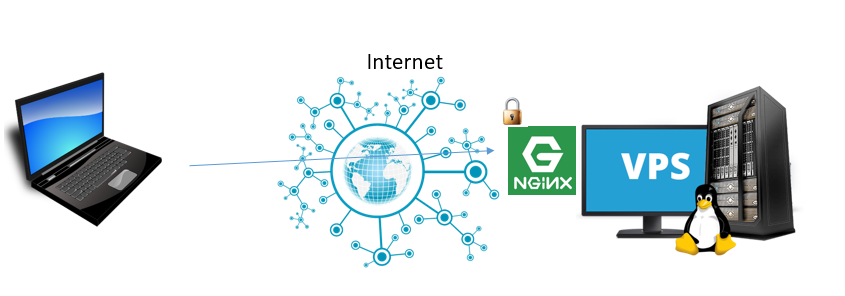
Un client web se connecte à l’un de nos services web auto-hébergés, protégé par du https.

Concrètement cela signifie que le client va pouvoir authentifier le serveur web, en récupérant le certificat https que celui-ci présente et en vérifiant la signature de ce certificat par une autorité de confiance (ici Let’s encrypt). Pour réaliser cela, le navigateur web du client utilise juste la clé publique de l’autorité Let’s encrypt, dont il dispose (les clés publiques de toutes les autorités ayant pignon sur rue sur Internet sont intégrés dans les navigateurs). Le client n’aura donc même pas à contacter Let’s encrypt pour vérifier que le certificat présenté par le serveur est authentique, et donc que l’on peut faire confiance à ce site : il est bien qui il prétend être.

Cette mécanique a été pensée pour favoriser le e-commerce, pour donner confiance au consommateur de sorte qu’il accepte de fournir son numéro de carte bancaire tout en ayant l’assurance ni qu’elle soit interceptée pendant la transmission, ni qu’elle soit transmise à un site margoulin.

Pratiquement tout le web fonctionne comme cela, et vous serez obligé de rester sur ce modèle si vos services auto-hébergés s’adressent à un large public, que vous ne connaissez pas (un site wordpress par exemple).

Dans ce modèle, le serveur est authentifié par le client, mais le client n’est pas authentifié par le serveur. Dans ce modèle, le serveur tente de susciter la confiance du client, mais le client ne se soucie pas de susciter la confiance du serveur. Le postulat de base est que le serveur est connu, et les clients sont anonymes. Le site se chargera de vérifier l’identité du client plutôt en lui présentant une page demandant son login et son mot de passe de client commercial.

Ce modèle est-il adapté par contre si votre VPS n’a pas vocation à offrir des services web à la terre entière mais seulement à vous et à quelques uns de vos amis ?

La réponse est oui, cela fonctionnera. Les pages vous seront accessibles bien sûr, mais elles seront également accessibles à la terre entière. Ok la terre entière tombera sur une page de login / mot de passe, qu’elle n’a pas. Mais qu’est-ce-qui l’empêche de tenter des milliards de mots de passe pour essayer de rentrer ? Rien en fait.

Il existe donc un autre modèle, le mTLS.

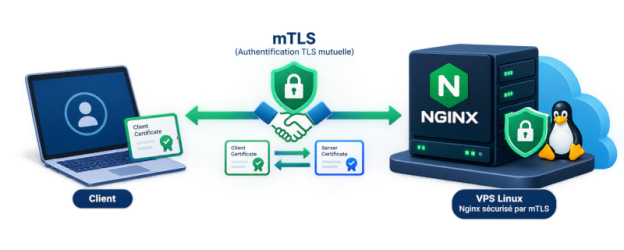
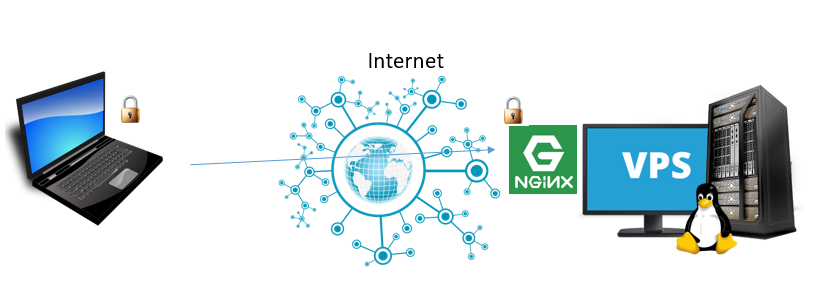
Dans ce modèle, le serveur présente toujours au client les certificats que lui a fournis Let’s encrypt. Ce qui change par contre c’est que le client dispose lui aussi de certificats prouvant son identité et il les présente au serveur. Cette vérification mutuelle donne son nom au modèle : mTLS (pour mutual TLS, TLS étant le nom technique de ce que le grand public appelle https).

Avec ce modèle, il faut que l’authentification mutuelle réussisse pour que la page web proposée par le serveur soit envoyée au client et apparaisse sur son écran.

Un tiers qui ne dispose pas des certificats client et qui tente une connexion au serveur ne verra même pas la page de login. Il ne sera donc pas capable de lancer une salve de tentatives d’intrusion.

Lorsqu’on met en ligne un VPS dédié à un nombre très restreint d’utilisateurs (par exemple les employés de notre micro-entreprise), il peut être utile d’activer l’authentification mutuelle mTLS. Elle permet aux utilisateurs authentifiés d’accéder aux services web du VPS, tout en rendant ces derniers invisibles au reste d’Internet.

Nous allons voir dans cette section comment activer le mTLS

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 9) – Travaux pratiques sur les appels système dédiés aux pipes

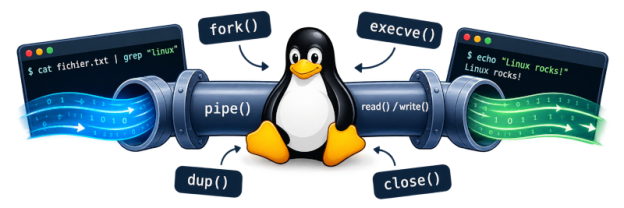
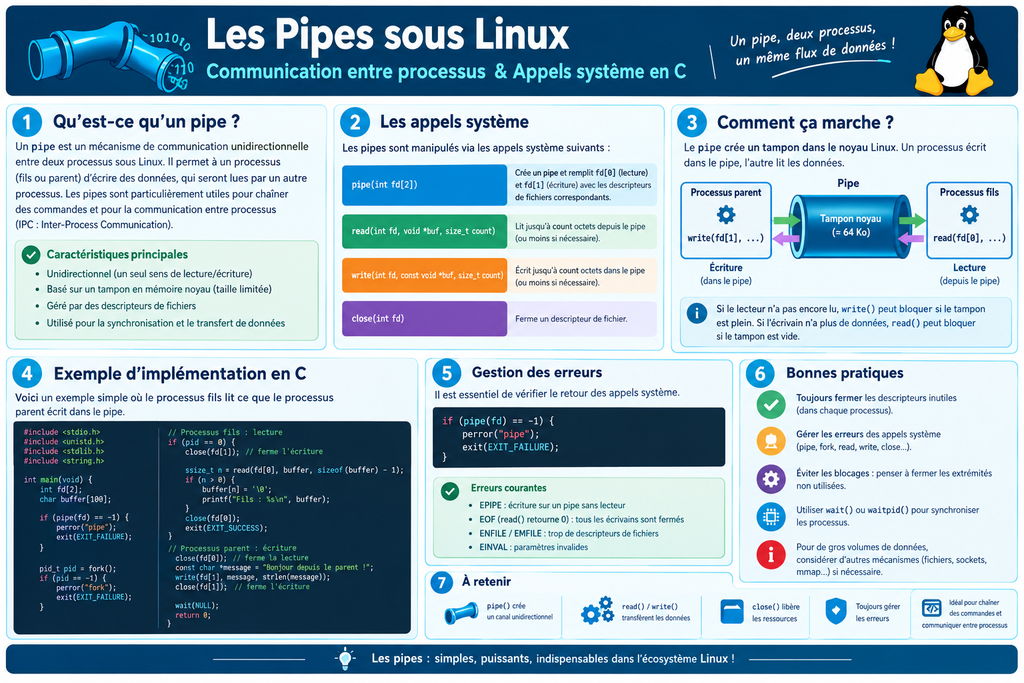
Nous poursuivons l’exploration des fonctionnalités offertes par le noyau aux programmeurs C (appels système). Aujourd’hui nous allons voir ce qu’est un pipe, et comment l’utiliser pour simuler ce que fait l’interpréteur de commandes (shell) bash lorsqu’on y tape une commande mettant en oeuvre des pipes.

Qu’est ce qu’un pipe ?

Un pipe est un tuyau de communication uni-directionnel présent dans le noyau Linux en mémoire. Ce tuyau a donc une entrée et une sortie. Plusieurs processus peuvent se connecter à l’entrée et y écrire des données, tout comme plusieurs processus peuvent se connecter à la sortie et y lire les données.

Les données écrites à l’entrée ressortent (si lues) à la sortie, sans perte et dans le même ordre.

Le nombre de pipes présents dans le noyau est fixé avant la compilation du noyau.

A quoi sert un pipe ?

Nous avons vu dans les épisodes précédents que les processus Unix / Linux sont sur des pages mémoire virtuelles, ce qui garantit, entre autres, qu’ils sont étanches les uns par rapport aux autres.

Un processus A n’a aucun moyen en propre de communiquer des données à un processus B. Il peut le faire mais il doit passer par l’un des moyens de communication inter-processus offerts par le noyau, comme les pipes.

Continuer la lecture →

Tutoriel Linux : faire ressembler exactement le bureau d’Ubuntu 26.04 LTS à celui de MacOS en 12 minutes

MacOS c’est un Unix, au sens de la conformité à la norme POSIX. Linux c’est pareil. On reproche beaucoup aux utilisateurs de Linux de beaucoup taper au shell, mais en réalité c’est juste par habitude.

En effet, sur MacOS on peut aussi ouvrir un shell et y taper exactement les mêmes commandes, elles marcheront. Simplement le cheptel qui utilise un Mac n’est pas habitué à ouvrir un shell.

Bref, certains (et j’en fais partie) pourraient penser que, finalement, MacOS n’est qu’un Linux payant.

Nous allons donc voir comment transformer un PC Linux Ubuntu 26.04 LTS en Mac « gratuit ».

La vidéo est en anglais mais normalement elle bascule automatiquement sur une voix off générée en français. Bonne installation de MacOS !

Tutoriel Linux : capturer des commandes tapées au shell dans un GIF animé

Vous vous êtes peut-être déjà demandé comment tous ces sites web font pour générer des GIF animés qui montrent des commandes tapées dans un shell, comme dans l’exemple ci-dessous.

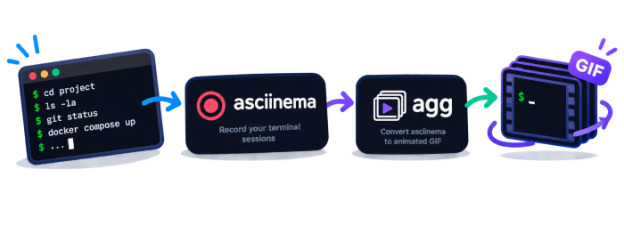
Nous allons donc voir comment faire. Pour cela nous allons utiliser deux logiciels Linux : asciinema, qui capture le shell sous forme de film, et agg qui transforme ce film en GIF animé.

Installation de asciinema

Sous Ubuntu 26.04, l’installation est très facile :

sudo apt install asciinema

Installation de agg

Malheureusement asciinema n’installe pas toujours agg. On doit souvent (c’est le cas sous Ubuntu 26.04) aller le chercher sur Internet.

Génération d’un GIF animé

Maintenant que asciinema et agg sont installés, la génération d’un GIF animé se fait en 2 commandes shell.

# Enregistrer
asciinema rec demo.cast

# Convertir en GIF
agg demo.cast demo.gif

Et voilà 😎