Tutoriel Linux : Les sockets réseau

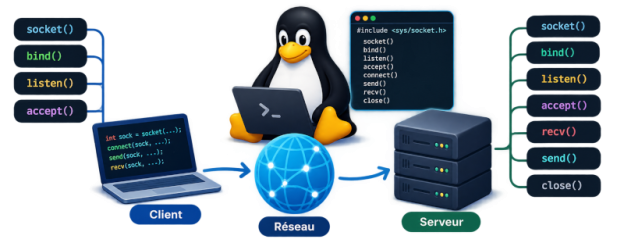
Les sockets font partie des mécanismes qui permettent aux processus de communiquer entre eux. Cependant, contrairement aux IPC classiques (segments de mémoire partagée, queues de messages, et même pipes), ce mécanisme est prévu pour faire communiquer des processus situés sur … des machines différentes.

Et comme les machines sont différentes et qu’il a bien fallu inventer des standards, les processus qui vont communiquer via ces mécanismes sont situés sur des machines différentes … dont le système d’exploitation est potentiellement différent.

Ainsi, via les sockets, une machine Linux va pouvoir communiquer avec un Mac ou une machine Windows, et inversement.

Le modèle OSI

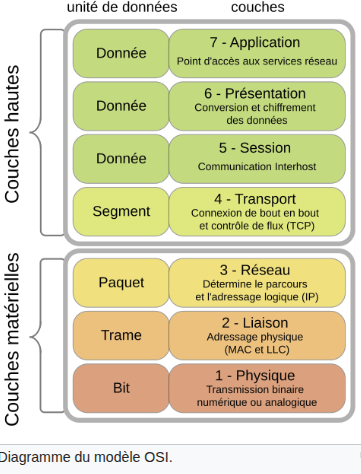
Toutes les machines qui souhaitent communiquer avec d’autres doivent se conformer au modèle OSI.

Avec ce modèle, les logiciels réseaux installés sur chaque machine sont rangés en 7 couches en théorie.

Au niveau 7 on a l’application qui veut communiquer avec une autre application, située elle aussi au niveau 7 sur une autre machine.

Les données que l’application souhaite envoyer à l’autre application descendent successivement les couches réseaux de la machine de départ, chaque couche encapsulant les données reçues de la couche du dessus et à destination de la couche équivalente sur la machine d’arrivée.

La dernière couche qui reçoit les données est la couche physique (couche 1) et c’est de là que les données quittent la machine sous forme de paquets. Ces paquets trouvent leur chemin vers la machine destination (qui peut être sur Internet, donc potentiellement de l’autre côté de la Terre) via un réseau de routeurs qui sont hors sujets dans le cadre de cet article.

Arrivés à la machine destination (potentiellement dans le désordre), ces paquets remontent les 7 couches de celle-ci (en désencapsulant à chaque couche) jusqu’à ce qu’ils soient délivrés à l’application (couche 7) qui attend ces données sur la machine destinatrice.

Bien sûr, l’application destinatrice pourra elle aussi envoyer des données de réponse à l’application émettrice en utilisant la mécanique inverse.

Continuer la lecture →

L’inférence en IA : kézako ?

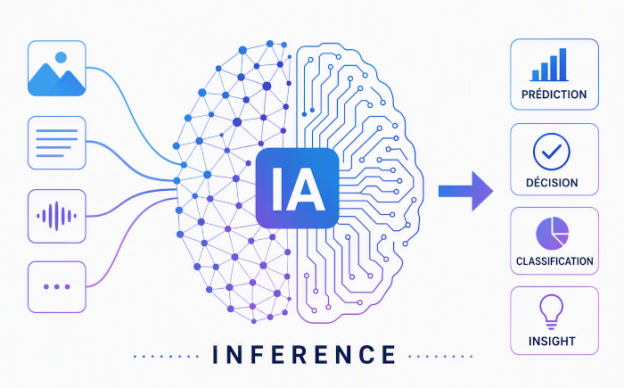
L’inférence dans le domaine de l’intelligence artificielle désigne le moment où un modèle déjà entraîné est mis à contribution pour produire une réponse, une prédiction ou une classification sur des données qu’il n’a pas vues auparavant.

C’est une étape distincte de l’entraînement, qui correspond à l’apprentissage proprement dit, et distincte aussi de l’évaluation, qui sert à mesurer la performance du modèle sur un jeu de test. L’inférence est donc la phase d’usage, celle qui se produit quand l’utilisateur interagit avec le système.

Le mot lui-même vient du latin inferre, formé de la préposition in et du verbe ferre, qui signifie porter. Le sens littéral est « porter vers, apporter en dedans », et l’usage philosophique et logique en a tiré l’idée de conduire une conclusion à partir d’éléments déjà connus.

Le français a repris ce terme dès le Moyen Âge dans le vocabulaire de la logique et de la scolastique.

Quand l’intelligence artificielle s’est constituée comme discipline, d’abord autour des systèmes experts et de la déduction formelle, le mot était déjà disponible et correspondait bien à ce que faisaient ces programmes : partir de faits et de règles pour aboutir à une conclusion. Le terme a été conservé lorsque l’apprentissage automatique puis l’apprentissage profond ont pris le dessus, même si le sens s’est élargi.

Aujourd’hui, l’inférence ne suppose plus nécessairement un raisonnement explicite au sens logique. Elle désigne simplement l’exécution du modèle entraîné, le calcul qui transforme une entrée en sortie.

En anglais, le terme est identique, inference, avec la même racine latine. On parle d’inference engine pour désigner le moteur qui exécute les calculs, d’inference time pour le temps de réponse, et de real-time inference pour les cas où la latence doit rester très faible. L’opposition classique en anglais est training contre inference, entraînement contre inférence, et cette opposition structure une grande partie du vocabulaire de la discipline.

Les poids du modèle ne changent pas pendant l’inférence. Le calcul est généralement plus léger que la rétropropagation utilisée pour l’entraînement, mais il doit souvent être répété un très grand nombre de fois, ce qui en fait la partie la plus coûteuse en production. Les optimisations portent sur la quantification, qui réduit la précision des nombres pour accélérer les calculs, sur la distillation, qui consiste à entraîner un petit modèle à imiter un grand, sur le regroupement des requêtes en lots, et sur l’usage de processeurs graphiques ou de puces spécialisées.

On cherche aussi à équilibrer la latence, c’est-à-dire le temps de réponse pour une requête donnée, et le débit, c’est-à-dire le nombre de requêtes traitées par unité de temps. Ces deux objectifs sont souvent en tension.

L’inférence se rencontre dans presque toutes les applications contemporaines. La reconnaissance faciale sur un téléphone, la traduction automatique, la détection d’objets dans une image, la génération de texte par un grand modèle de langage, la recommandation de contenu, la détection de fraude bancaire, le diagnostic médical assisté par ordinateur reposent sur des opérations d’inférence.

Dans le cas des grands modèles de langage, l’inférence se fait souvent de manière autoregressive, c’est-à-dire que le modèle produit un mot, puis s’en sert pour produire le suivant, et ainsi de suite. Cette manière de procéder explique une partie de la latence observée et justifie des techniques spécifiques comme le cache d’attention, qui évite de recalculer inutilement ce qui a déjà été calculé.

Le mot inférence conserve donc une double filiation. Il rappelle la logique et la philosophie, où il désigne l’acte de tirer une conclusion, et il s’est adapté à l’apprentissage automatique, où il désigne l’exécution d’un modèle entraîné. Ce glissement de sens n’est pas propre à l’intelligence artificielle : beaucoup de termes techniques migrent d’un domaine à un autre et se chargent de nuances nouvelles. Ce qui compte, pour éviter les malentendus, est de garder à l’esprit que dans le contexte de l’IA, inférence ne signifie pas raisonnement conscient ni déduction formelle, mais simplement production d’une sortie à partir d’une entrée par un modèle dont les paramètres sont figés.
Fonctionnalités du noyau Linux (Episode 11) – Travaux pratiques sur les segments de mémoire partagés

Comme nous l’avons vu dans l’épisode 2, les processus sont exécutés en mémoire sur des pages virtuelles, ce qui garantit une étanchéité totale entre eux. Ceci oblige à passer par les mécanismes offerts par le noyau pour faire transiter des informations d’un processus à l’autre. Ces mécanismes ont été survolés lors de l’épisode 5.

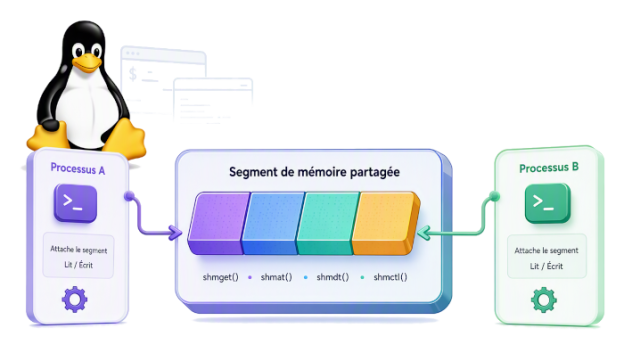
Parmi ces mécanismes, on trouve les segments de mémoire partagée.

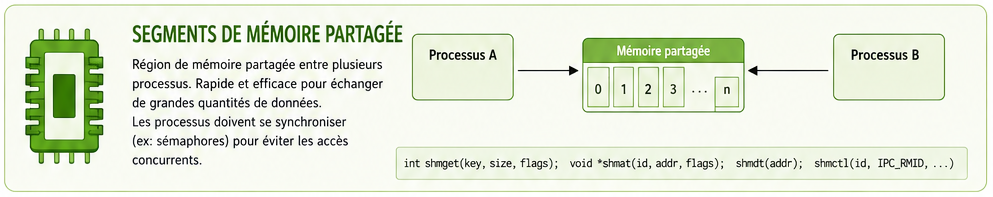
Le noyau peut en effet allouer des pages de mémoire virtuelle partagées que les processus peuvent monter dans leur espace mémoire. Ces pages, appelés segments de mémoire partagés, peuvent être montés par plusieurs processus, créant ainsi une zone d’échange de données permettant de traiter de (relativement) gros volumes de données.

Mais attention, l’accès concurrent à des données partagées pose des problèmes de stabilité et de fiabilité de ces données qui sont insoupçonnables tant qu’on n’a pas expérimenté ce type de programmation concurrente. C’est un sujet qu’on étudie lorsqu’on fait ses études d’informatique. La solution est simple pourtant : aucun processus ne doit accéder à ces données en même temps qu’un autre processus, ce qui oblige à considérer les sections d’accès aux données comme du code critique, dont l’accès doit être protégé par un sémaphore.

Nous avons vu comment mettre en oeuvre les sémaphores dans l’épisode 10.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 10) – Travaux pratiques sur les sémaphores

Comme nous l’avons vu dans l’épisode 5, les sémaphores sont des grappes de jetons qui permettent de protéger l’accès à des sections de code critiques. Critiques dans le sens où : si deux processus ou deux processus légers (threads) exécutent la même section de code en même temps alors la valeur des variables devient indéterminée.

Le cas typique est du code qui lit ou écrit des variables dans un segment de mémoire partagée. Si deux processus accèdent à la même variable dans un segment de mémoire partagée, même si l’un ne fait que lire le contenu de la variable et l’autre ne fait qu’y écrire, l’accès à la variable doit être protégé par un sémaphore.

Un sémaphore est un jeton, qu’on décrémente en réalisant une opération P (via un appel système au noyau) et qu’on incrémente en faisant une opération V (via un autre appel système au noyau).

Si un processus fait une opération P, la valeur du jeton (qu’on fixe initialement) est décrémentée. Tant que cette valeur n’atteint pas 0, rien d’autre ne se passe. Si par contre l’opération de décrémentation donne 0, alors le processus appelant cet appel système est bloqué par le noyau en attente qu’un autre processus fasse une opération V pour rendre un jeton.

Ainsi, un sémaphore initialisé à la valeur 1 garantit qu’un seul processus à la fois sera dans une section de code critique donnée. Et un sémaphore initialisé à la valeur N garantit qu’au plus N processus pourront se retrouver simultanément dans une section de code critique.

Vous l’avez compris, les sémaphores sont un mécanisme très puissant et indispensable, mais un mécanisme dangereux car il peut y avoir une perte de jeton. Les deux cas dans lesquels les programmeurs doivent impérativement éviter de tomber sont :

  • le cas où un programme « oublie » de rendre le jeton lorsqu’il quitte la section de code critique. Dans ce cas, tous les autres processus qui attendent la libération du jeton pour y rentrer sont bloqués ad vitam
  • Et le cas qu’on appelle « Etreinte fatale » (deadlock en anglais) qui est celui où un processus A disposant du jeton 1 demande le jeton 2 (non disponible car détenu par B), et où un processus B disposant du jeton 2 demande le jeton 1 (non disponible car détenu par A). Chaque processus attend la libération du jeton de l’autre.

Les sémaphores sont très souvent initialisés à 1. Dans ce cas on les appelle des mutex (exclusion mutuelle). Cependant, par commodité, les appels système permettant de les manipuler les manipulent par grappe de plusieurs sémaphores.

Continuer la lecture →

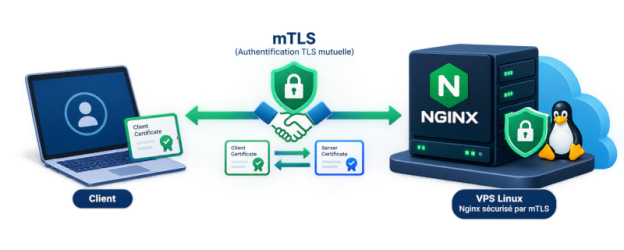
Tutoriel Linux : sécuriser NginX avec mTLS (authentification mutuelle)

Lorsqu’on auto-héberge des services accessibles par le web, il est courant d’utiliser le serveur web NginX.

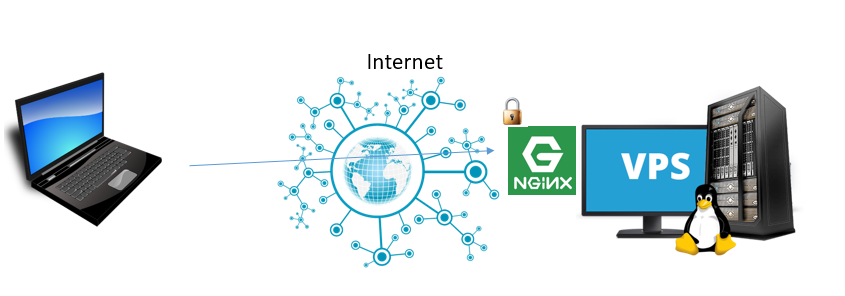
Le cadre architectural dans lequel on travaille est toujours le même :

Un client web se connecte à l’un de nos services web auto-hébergés, protégé par du https.

Concrètement cela signifie que le client va pouvoir authentifier le serveur web, en récupérant le certificat https que celui-ci présente et en vérifiant la signature de ce certificat par une autorité de confiance (ici Let’s encrypt). Pour réaliser cela, le navigateur web du client utilise juste la clé publique de l’autorité Let’s encrypt, dont il dispose (les clés publiques de toutes les autorités ayant pignon sur rue sur Internet sont intégrés dans les navigateurs). Le client n’aura donc même pas à contacter Let’s encrypt pour vérifier que le certificat présenté par le serveur est authentique, et donc que l’on peut faire confiance à ce site : il est bien qui il prétend être.

Cette mécanique a été pensée pour favoriser le e-commerce, pour donner confiance au consommateur de sorte qu’il accepte de fournir son numéro de carte bancaire tout en ayant l’assurance ni qu’elle soit interceptée pendant la transmission, ni qu’elle soit transmise à un site margoulin.

Pratiquement tout le web fonctionne comme cela, et vous serez obligé de rester sur ce modèle si vos services auto-hébergés s’adressent à un large public, que vous ne connaissez pas (un site wordpress par exemple).

Dans ce modèle, le serveur est authentifié par le client, mais le client n’est pas authentifié par le serveur. Dans ce modèle, le serveur tente de susciter la confiance du client, mais le client ne se soucie pas de susciter la confiance du serveur. Le postulat de base est que le serveur est connu, et les clients sont anonymes. Le site se chargera de vérifier l’identité du client plutôt en lui présentant une page demandant son login et son mot de passe de client commercial.

Ce modèle est-il adapté par contre si votre VPS n’a pas vocation à offrir des services web à la terre entière mais seulement à vous et à quelques uns de vos amis ?

La réponse est oui, cela fonctionnera. Les pages vous seront accessibles bien sûr, mais elles seront également accessibles à la terre entière. Ok la terre entière tombera sur une page de login / mot de passe, qu’elle n’a pas. Mais qu’est-ce-qui l’empêche de tenter des milliards de mots de passe pour essayer de rentrer ? Rien en fait.

Il existe donc un autre modèle, le mTLS.

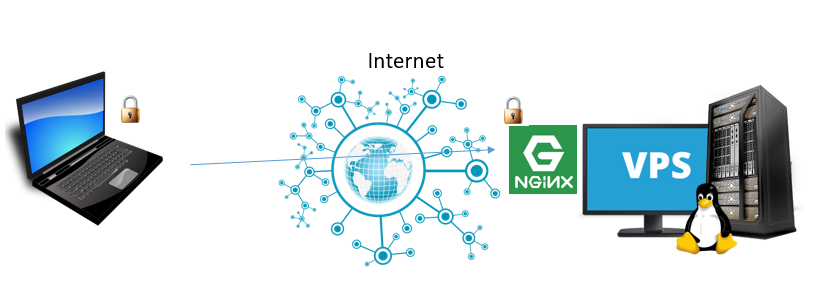
Dans ce modèle, le serveur présente toujours au client les certificats que lui a fournis Let’s encrypt. Ce qui change par contre c’est que le client dispose lui aussi de certificats prouvant son identité et il les présente au serveur. Cette vérification mutuelle donne son nom au modèle : mTLS (pour mutual TLS, TLS étant le nom technique de ce que le grand public appelle https).

Avec ce modèle, il faut que l’authentification mutuelle réussisse pour que la page web proposée par le serveur soit envoyée au client et apparaisse sur son écran.

Un tiers qui ne dispose pas des certificats client et qui tente une connexion au serveur ne verra même pas la page de login. Il ne sera donc pas capable de lancer une salve de tentatives d’intrusion.

Lorsqu’on met en ligne un VPS dédié à un nombre très restreint d’utilisateurs (par exemple les employés de notre micro-entreprise), il peut être utile d’activer l’authentification mutuelle mTLS. Elle permet aux utilisateurs authentifiés d’accéder aux services web du VPS, tout en rendant ces derniers invisibles au reste d’Internet.

Nous allons voir dans cette section comment activer le mTLS

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 9) – Travaux pratiques sur les appels système dédiés aux pipes

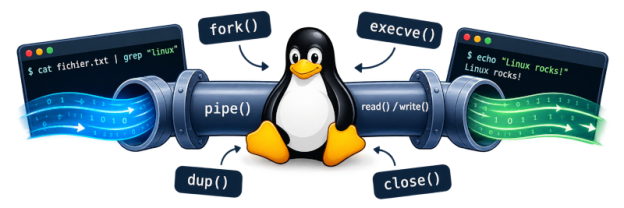
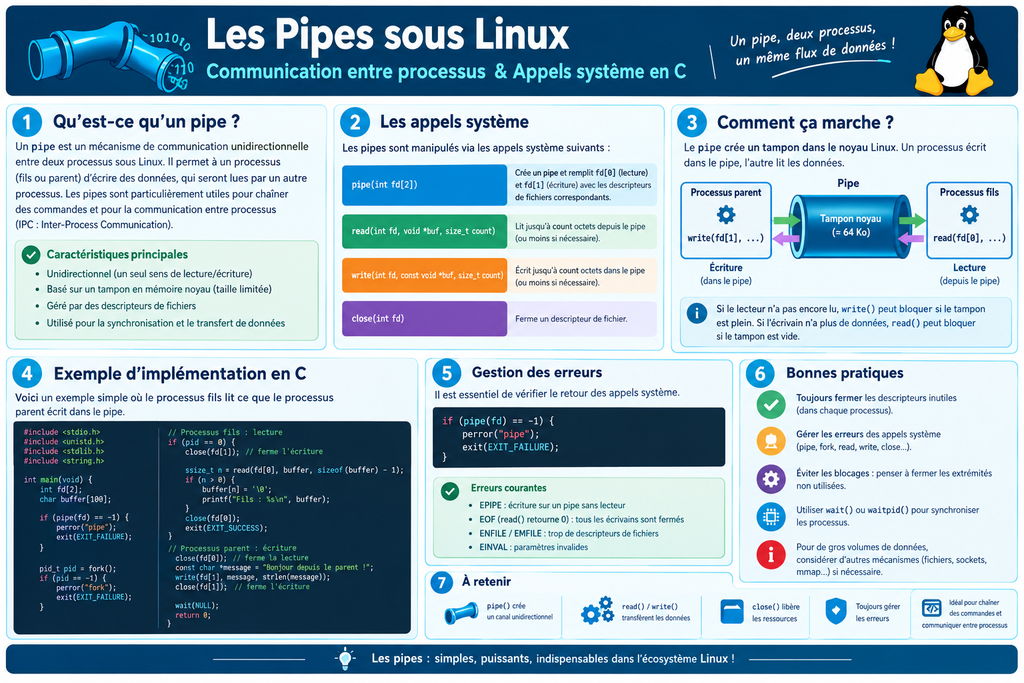
Nous poursuivons l’exploration des fonctionnalités offertes par le noyau aux programmeurs C (appels système). Aujourd’hui nous allons voir ce qu’est un pipe, et comment l’utiliser pour simuler ce que fait l’interpréteur de commandes (shell) bash lorsqu’on y tape une commande mettant en oeuvre des pipes.

Qu’est ce qu’un pipe ?

Un pipe est un tuyau de communication uni-directionnel présent dans le noyau Linux en mémoire. Ce tuyau a donc une entrée et une sortie. Plusieurs processus peuvent se connecter à l’entrée et y écrire des données, tout comme plusieurs processus peuvent se connecter à la sortie et y lire les données.

Les données écrites à l’entrée ressortent (si lues) à la sortie, sans perte et dans le même ordre.

Le nombre de pipes présents dans le noyau est fixé avant la compilation du noyau.

A quoi sert un pipe ?

Nous avons vu dans les épisodes précédents que les processus Unix / Linux sont sur des pages mémoire virtuelles, ce qui garantit, entre autres, qu’ils sont étanches les uns par rapport aux autres.

Un processus A n’a aucun moyen en propre de communiquer des données à un processus B. Il peut le faire mais il doit passer par l’un des moyens de communication inter-processus offerts par le noyau, comme les pipes.

Continuer la lecture →

Tutoriel Linux : faire ressembler exactement le bureau d’Ubuntu 26.04 LTS à celui de MacOS en 12 minutes

MacOS c’est un Unix, au sens de la conformité à la norme POSIX. Linux c’est pareil. On reproche beaucoup aux utilisateurs de Linux de beaucoup taper au shell, mais en réalité c’est juste par habitude.

En effet, sur MacOS on peut aussi ouvrir un shell et y taper exactement les mêmes commandes, elles marcheront. Simplement le cheptel qui utilise un Mac n’est pas habitué à ouvrir un shell.

Bref, certains (et j’en fais partie) pourraient penser que, finalement, MacOS n’est qu’un Linux payant.

Nous allons donc voir comment transformer un PC Linux Ubuntu 26.04 LTS en Mac « gratuit ».

La vidéo est en anglais mais normalement elle bascule automatiquement sur une voix off générée en français. Bonne installation de MacOS !

Tutoriel Linux : capturer des commandes tapées au shell dans un GIF animé

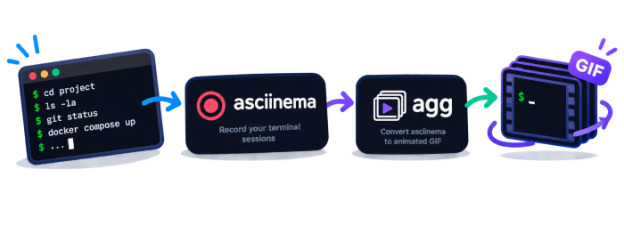
Vous vous êtes peut-être déjà demandé comment tous ces sites web font pour générer des GIF animés qui montrent des commandes tapées dans un shell, comme dans l’exemple ci-dessous.

Nous allons donc voir comment faire. Pour cela nous allons utiliser deux logiciels Linux : asciinema, qui capture le shell sous forme de film, et agg qui transforme ce film en GIF animé.

Installation de asciinema

Sous Ubuntu 26.04, l’installation est très facile :

sudo apt install asciinema

Installation de agg

Malheureusement asciinema n’installe pas toujours agg. On doit souvent (c’est le cas sous Ubuntu 26.04) aller le chercher sur Internet.

Génération d’un GIF animé

Maintenant que asciinema et agg sont installés, la génération d’un GIF animé se fait en 2 commandes shell.

# Enregistrer
asciinema rec demo.cast

# Convertir en GIF
agg demo.cast demo.gif

Et voilà 😎

Tutoriel Linux : page html mise à jour en temps réel par un serveur websocket écrit en langage C

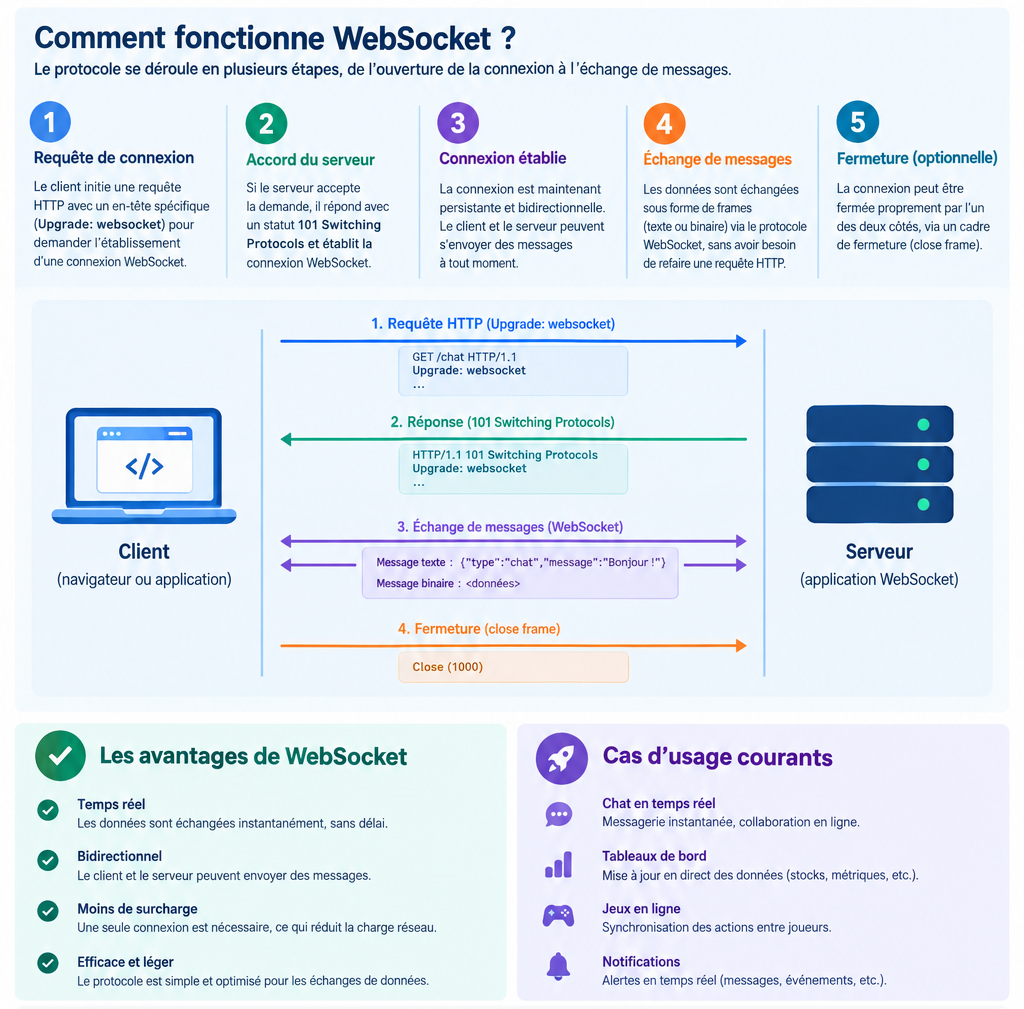
Une websocket est un protocole de communication qui permet d’établir une connexion permanente et bidirectionnelle entre un client (généralement un navigateur) et un serveur. Elle est normalisée par l’IETF sous la référence RFC 6455 et fonctionne au-dessus de TCP.

Contrairement au modèle classique du web, où le client envoie une requête et le serveur répond puis ferme la connexion, la websocket maintient un canal ouvert dans les deux sens. Une fois la connexion établie, le client et le serveur peuvent s’envoyer des données à tout moment, sans attendre une nouvelle requête.

Comment la connexion s’établit

La websocket démarre par une requête HTTP classique contenant un en-tête spécifique, Upgrade: websocket. Si le serveur accepte, il répond avec un code 101 (Switching Protocols). À partir de ce moment, la connexion HTTP est transformée en connexion websocket, et les échanges suivent un format de trames propre à ce protocole.

Ce mécanisme de poignée de main permet de réutiliser l’infrastructure existante du web : ports 80 et 443, proxys, TLS. Une websocket peut donc fonctionner en ws:// ou en wss:// pour la version chiffrée.

Continuer la lecture →

Tutoriel Linux : passer de docker à podman

Podman est un moteur de conteneurs développé par Red Hat à partir de 2017.

Sa différence fondamentale avec Docker ne réside pas dans les commandes, mais dans l’architecture.

Docker repose sur un démon qui tourne en permanence avec les privilèges root, et c’est ce service en arrière-plan qui crée et supervise les conteneurs. Podman fonctionne lui sur un modèle fork-exec : lorsque vous tapez une commande, il appelle directement le runtime OCI pour lancer le conteneur, et le processus du conteneur devient un enfant de Podman lui-même. Cette conception réduit la surface d’attaque puisqu’il n’y a pas de service root résident à compromettre, et elle fait du mode rootless le comportement par défaut.

Red Hat a développé Podman précisément parce que l’architecture de Docker posait problème dans les environnements de production critiques. Le démon Docker, constamment actif et disposant des droits root, constitue un point de défaillance unique et une cible de choix pour un attaquant. Podman élimine ce niveau intermédiaire : chaque conteneur est lancé par le processus utilisateur lui-même, ce qui signifie qu’une évasion de conteneur ne donne accès qu’aux droits de cet utilisateur, pas à ceux du système entier.

Sur le plan des parts de marché, Docker reste largement dominant. L’enquête Stack Overflow de 2025 indiquait que 71,1 % des développeurs utilisaient intensivement Docker, contre 11,1 % pour Podman. Ce dernier progresse toutefois rapidement, passant d’environ 5 % en 2024 à 11,1 % en 2025. Dans les environnements d’entreprise, sa part est plus élevée, estimée entre 19 et 23 %, portée par des exigences de sécurité, l’absence de coût de licence et son intégration native avec Red Hat Enterprise Linux et OpenShift.

Installation et utilisation de Podman

Sur Ubuntu 26.04, Podman est disponible directement dans les dépôts officiels.

sudo apt update
sudo apt install podman -y

Vérifiez que l’installation s’est bien déroulée.

podman --version
Continuer la lecture →