Tutoriel Linux : développement web avec backend en langage C (Episode 2 – Installation et configuration de NginX)

Nous avons introduit dans l’épisode 1 ce que nous allons faire (apprendre à construire des sites web dont le backend est en langage C).

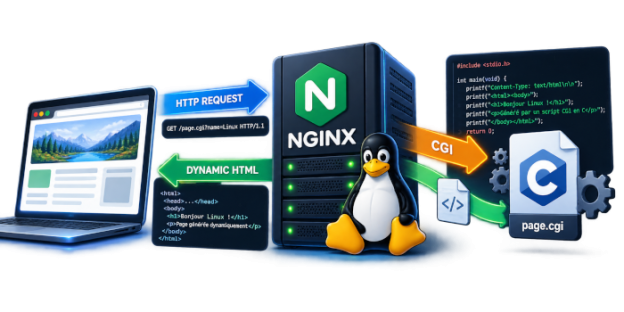
Dans cet épisode 2 nous allons installer le serveur web NginX et le configurer de sorte qu’il soit en mesure de faire tourner des unités de traitement écrites en C.

Sur le serveur, dans un shell bash, nous allons taper :

1) Installer les paquets nécessaires :
sudo apt-get update
sudo apt-get install nginx fcgiwrap

2) Paramétrer le serveur web Nginx :
sudo cp /usr/share/doc/fcgiwrap/examples/nginx.conf /etc/nginx/fcgiwrap.conf
sudo mkdir /usr/lib/cgi-bin
sudo nano /etc/nginx/sites-available/default

Dans la rubrique “server” du fichier, il faut ajouter la ligne ci-dessous juste après l’accolade fermante de location
include fcgiwrap.conf;

Relancer Nginx :
sudo service nginx restart

3) Vérifier maintenant que NginX est capable d'exécuter un script CGI :
sudo nano /usr/lib/cgi-bin/test

Mettre dans ce fichier /usr/lib/cgi-bin/test.cgi le contenu suivant :
#!/bin/bash
echo "Content-Type: text/html"
echo
echo "<html><body>Succes</body></html>"

Puis changer les paramétrages de droits et de propriétaires de ce fichier :
sudo chown www-data.www-data /usr/lib/cgi-bin/test
sudo chmod 755 /usr/lib/cgi-bin/test

Si la page d'URL http://serveur/cgi-bin/test affiche bien à l'écran le mot "Succes", tout est Ok, NginX est installé et sait gérer des unités de traitements scripts CGI.
Continuer la lecture →

Tutoriel Linux : développement web avec backend en langage C (Episode 1 – Introduction)

Le développement web se fait aujourd’hui grâce à des langages modernes : Javascript, Typescript, React pour le frontend, PHP, node.js notamment pour le backend.

Quand j’explique à des programmeurs que je programme mes backends en langage C, ils sont généralement très étonnés que ce soit même faisable.

Et pourtant, ça marche très bien. Ce n’est probablement pas le langage le plus adapté, mais ce n’est pas compliqué et ça marche.

Quels avantages en tirer ?

Tout d’abord la simplicité. Avec le C il n’y a aucune bibliothèque ou framework externe à charger. Le programme ne fera que ce que vous écrivez. Vous maîtrisez la compréhension du code de A à Z. Ce qui ne vous empêche pas bien sûr de vous créer votre propre bibliothèque de routines réutilisables en C.

Deuxièmement, la vélocité. A part l’assembleur, aucun langage n’est aussi rapide que le C. Votre serveur web sera donc hyper véloce.

Troisièmement, l’indépendance. Comme vous n’utilisez aucune bibliothèque ou framework externe, vous n’aurez pas de mise à jour de ceux-ci qui mettent par terre votre mécanique.

Comment ça marche ?

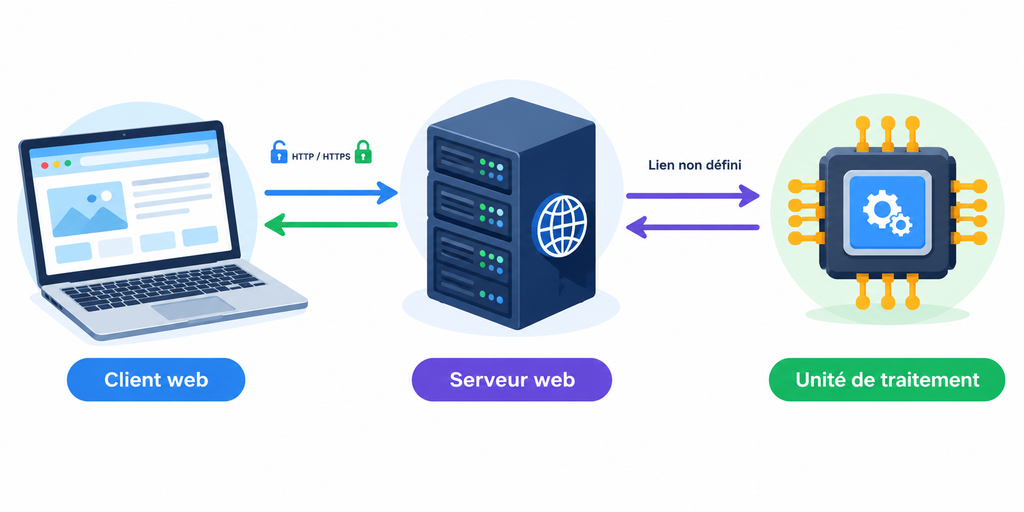
Servir dynamiquement des pages web relève toujours de la même mécanique, représentée ci-dessous :

Le client web à servir (le navigateur) communique avec un serveur sur lequel 2 services tournent : le serveur web et l’unité de traitement.

Le serveur web s’occupe d’un côté de communiquer avec le client en http ou en https, selon comment il est configuré. Et de l’autre côté il s’occupe de transmettre à l’unité de traitement les data des requêtes que le client web lui a envoyées.

L’unité de traitement sait quoi faire des données de requête reçues du client (consulter ou mettre à jour une base de données par exemple), et sait générer une page html de réponse qu’il transmet au serveur web.

Le serveur web récupère la page html générée par l’unité de traitement, et la transmet au navigateur du client qui l’affiche.

NB : Nous nous plaçons ici dans le cas où la page entière est mise à jour, pas la cas où une partie seulement de la page est mise à jour dynamiquement sans recharge de la page entière. Ce cas de figure se traite en effet avec des websockets et a déjà été traité dans l’article sur les websockets en C.

Concrètement, quand on utilise node.js, celui-ci prend en charge seul le serveur web et l’unité de traitement qui est le programme qu’on est en train d’écrire. Ce script est interprété par le moteur V8 mais certaines parties qui sont exécutées souvent sont compilées à la volée pour améliorer la vélocité.

Les sites bâtis avec PHP fonctionnent avec un vrai serveur web (Nginx, Apache, …) et l’unité de traitement est le Zend engine (écrit en C) qui interprète le script de traitement PHP à exécuter (le terme interprète est légèrement abusif puisque le Zend engine fait en réalité une pseudo compilation en bytecode avec d’exécuter le script).

Et le C là dedans ?

Continuer la lecture →

Tutoriel Linux : programmer avec les POSIX Threads

Nous avons vu dans l’épisode consacré aux processus que le noyau Linux offre deux appels systèmes pour lui demander de créer des processus fils : fork et exec.

C’est une mécanique parfaitement fonctionnelle, mais elle a le défaut d’être lourde à gérer pour le noyau puisqu’à chaque création de processus fils celui-ci doit réaliser des tâches très lourdes qui vont avec, comme faire hériter ce nouveau processus de l’environnement du père, de la table des descripteurs de fichiers du père, des variables du père, etc.

C’est pourquoi on appelle ces processus normaux des processus lourds.

Dans les serveurs notamment, pour lesquels chaque nouvelle connexion d’un client amène à la création d’un processus fils, la montée en charge est synonyme de multiplication de processus lourds qui peuvent mettre à genou la machine.

Pour palier à ces défauts, le monde Unix a spécifié des processus légers, appelés threads, sous une norme POSIX : les POSIX threads (ou pthreads).

Les pthreads sont disponibles sous tous les Unices (pluriel d’Unix) qui les ont implémentés : BSD, MacOS, Solaris, et bien sûr Linux.

Les POSIX threads

Contrairement à un processus lourd fils, un pthread tourne au sein du processus père (qui ne s’appelle plus père en fait, puisqu’il n’a pas de fils).

La mécanique est assez simple : dans le main d’un processus on va lancer autant de pthreads qu’on le souhaite (via l’appel système pthread_create), chacun sur une fonction de traitement qui peut lui être propre. Tous ces pthreads vont tourner en parallèle dans l’unique processus courant : ils vont donc tous avoir accès aux variables globales du processus, ce qui va poser exactement le même problème d’incertitude lié aux accès concurrents que nous avions vus pour lors de l’article sur les sémaphores.

C’est pourquoi l’accès en lecture ou en écriture aux variables globales du processus doit être considéré comme une section critique à protéger par un sémaphore. Ce problème étant un classique, les pthreads viennent avec leur propres sémaphores (les pthreads_mutex_t), beaucoup plus simples à utiliser mais tout aussi efficaces (la prise de jeton se demande avec pthread_mutex_lock, et l’abandon de jeton se fait avec pthread_mutex_unlock). La suppression d’un sémaphore se fait avec pthread_mutex_destroy.

Pour en revenir aux pthreads eux-mêmes, ils font leur travail en parallèle comme on l’a dit, puis ils meurent, soit en faisant un return à la fin de leur fonction de traitement (cas général), soit en appelant pthread_exit (cas particulier quand on veut faire mourir le thread en cours de fonction de traitement et non à la fin, par exemple si l’on rencontre une erreur).

Continuer la lecture →

Tutoriel Linux : Maintenir à jour les images docker avec Tugtainer

Lorsqu’on dispose d’un VPS Linux actif en ligne 24/7, et que l’on fait tourner dessus moulte services docker ou docker compose, se pose la question du maintien à jour de ces images et services.

En effet, de nombreuses images docker font l’objet d’un MCO dynamique de la part des équipes qui les maintiennent. Du coup, les questions légitimes à se poser pour son VPS sont :

  • Quelles sont mes images qui font l’objet d’une mise à jour ?
  • Comment minimiser l’énergie que ces mises à jour vont me prendre (surtout si l’on a plusieurs VPS) ?
  • Comment purger automatiquement les anciennes images qui sont toujours sur le disque mais qui ne servent plus ?
  • Comment minimiser le délai de perte de services pendant ces maintenances ?

En amont de ces questions il y en a une plus fondamentale encore, mais hors scope de cet article, dois-je effectuer les mises à jour ? Il n’est en effet pas rare qu’une mise à jour d’image docker amène des régressions, voire casse carrément la prod. Ce problème s’adresse normalement par des tests préalables en environnement de pré-prod.

Quel outil choisir pour le MCO des images et conteneurs ?

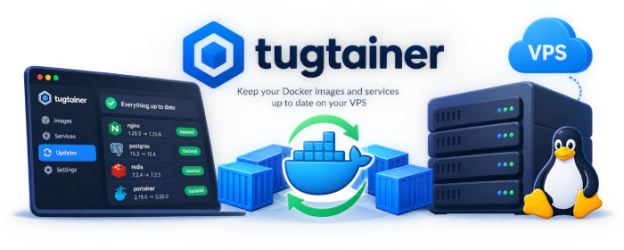
On peut utiliser le classique WatchTower, ou What’s up docker (WUD), mais je préfère utiliser Tugtainer.

Son principe est simple : on fait tourner sur le VPS un agent Tugtainer sous forme de conteneur docker, et un client web également en conteneur docker sur la machine distante qu’on utilise pour la maintenance du VPS (un laptop par exemple).

Sur l’interface web du laptop on déclare comme machine l’agent distant qui tourne sur tous les VPS qu’on veut maintenir. Depuis cette interface web laptop on peut alors demander à chacun des agents Tugtainer distants de réaliser seul les tâches fondamentales suivantes :

  • Nous dire quelles sont les images docker qui disposent d’une mise à jour à télécharger (individuellement ou pour toutes les images du VPS)
  • Mettre à jour les images docker disposant d’une mise à jour à télécharger, individuellement ou pour toutes les images du VPS, en arrêtant et relançant les services sur les nouvelles images tout en optimisant le délai d’arrêt du service
  • Purger toutes les images docker du VPS devenues inutiles

Avec un tel outil, il n’y a presque plus besoin de se connecter à la mano au VPS pour y faire ces travaux. Presque car Tugtainer ne sait pas mettre à jour … Tugtainer ! (Pour tugtainer lui-même, et ses agents, il faudra se connecter et le faire à la mano. Mais il est capable de nous dire si des mises à jour de ces images sont disponibles).

Tugtainer est un outil performant qui est régulièrement mis à jour.

Continuer la lecture →

Tutoriel Android / Linux : Installer et utiliser SimpleX chat, la messagerie chiffrée sans identifiant

SimpleX Chat part d’un constat simple : la plupart des messageries chiffrées protègent le contenu des messages, mais laissent fuiter l’essentiel : qui parle à qui.

Signal et WhatsApp savent que vous existez, que vous avez un numéro ou un compte, et quels contacts vous échangez. SimpleX pousse la logique un cran plus loin en supprimant purement et simplement la notion d’identifiant utilisateur.

En effet, SimpleX Chat est une application de messagerie open source qui se présente comme le premier réseau de messagerie sans identifiant utilisateur d’aucune sorte, pas même un identifiant aléatoire .

Concrètement, il n’y a ni numéro de téléphone, ni nom d’utilisateur, ni adresse email à fournir. Votre profil et vos contacts sont stockés uniquement sur votre appareil, et les serveurs relais n’y ont pas accès .

L’application est disponible sur Android, iOS, Linux, macOS et Windows . Elle est gratuite et son code source est public.

Fonctionnement : des files d’attente plutôt que les identités

Le fonctionnement de SimpleX repose sur un renversement architectural. Au lieu d’attribuer à chaque utilisateur une adresse unique par laquelle transiteraient tous ses messages, SimpleX crée des files d’attente unidirectionnelles (queues) pour chaque conversation. Une file sert à recevoir les messages, une autre à les envoyer. Ces files ont des identifiants éphémères et aléatoires, sans lien avec votre personne .

Pour contacter quelqu’un, vous ne cherchez pas son nom d’utilisateur : vous lui transmettez un lien d’invitation à usage unique (ou un QR code), par un canal externe (de vive voix, SMS, etc.). Une fois la connexion établie, vos messages transitent par des serveurs relais qui ne voient qu’un flux chiffré entrant et sortant, sans pouvoir relier les deux files à une même conversation ni identifier les personnes .

Le chiffrement de bout en bout est assuré par un protocole de double ratchet résistant aux attaques quantiques, et il est activé par défaut pour tous les échanges, y compris les fichiers, les appels audio/vidéo et les messages vocaux .

Ce qui distingue SimpleX de Signal et WhatsApp

La différence tient en un mot : les métadonnées.

WhatsApp appartient à Meta et repose sur un numéro de téléphone comme identifiant. Même avec le chiffrement de bout en bout, l’entreprise sait qui vous êtes, qui sont vos contacts, et quand vous communiquez.

Signal est bien meilleur élève : l’application est open source, à but non lucratif, et ne conserve quasiment aucune métadonnée. Mais elle repose toujours sur un numéro de téléphone comme identifiant, et son architecture centralisée implique que les serveurs Signal savent quels comptes existent et quand ils se connectent, même s’ils ne savent pas qui parle à qui.

SimpleX élimine l’identifiant lui-même. Il n’y a pas de « compte » à proprement parler. Chaque conversation utilise des files d’attente anonymes et jetables. Le serveur relais ne peut pas reconstruire de graphe social parce qu’il n’y a pas de nœuds à relier . Cette approche a un coût : pas d’annuaire, pas de découverte de contacts, une ergonomie d’ajout de contact moins fluide. C’est le prix de la confidentialité des métadonnées.

Continuer la lecture →
Tutoriel Linux : Installer et utiliser la reconnaissance vocale par IA sous Ubuntu

Canonical vient d’annoncer que sa reconnaissance vocale assistée par IA, Myna, est disponible en preview technologique, ce qui signifie que si elle sera livrée bientôt en standard dans la distribution elle nécessite pour l’instant d’être installée à la main, et comporte encore potentiellement quelques bugs.

La technologie Myna consiste à installer une IA en local sur la machine, de sorte que la reconnaissance vocale se fasse uniquement en local et donc ne sorte pas de la machine.

L’installation sous Ubuntu 26.04 LTS se fait en installant le ppa officiel :

sudo add-apt-repository ppa:canonical-desktop-team/myna
sudo apt update
sudo apt install myna-config
myna-config

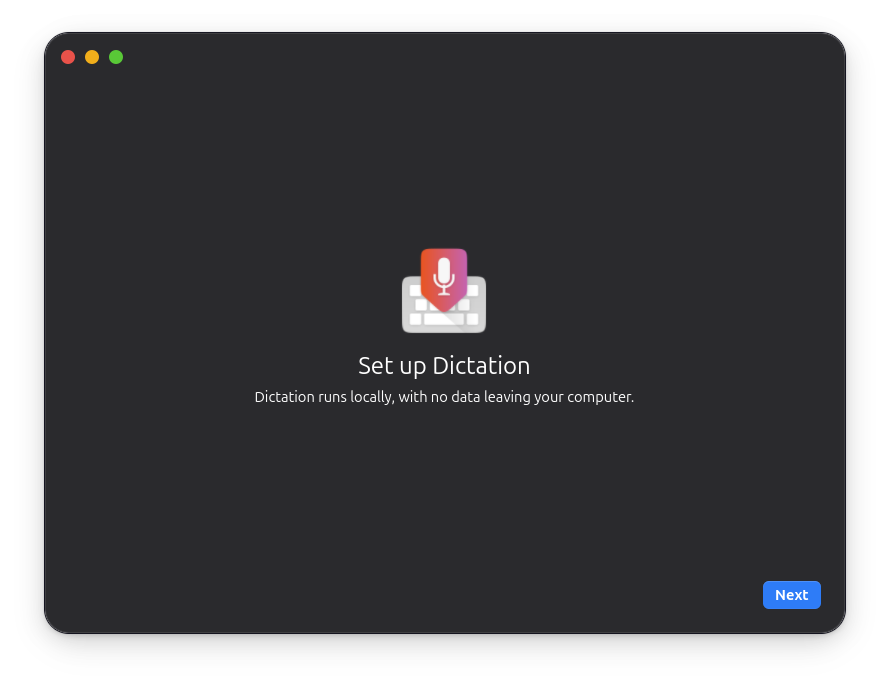
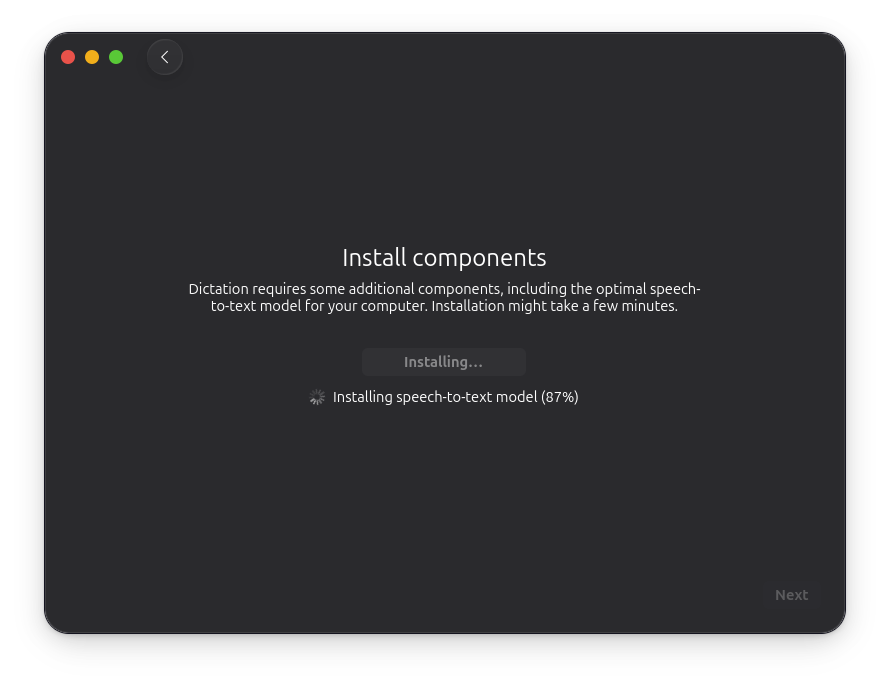
On entre alors en phase de configuration (en anglais).

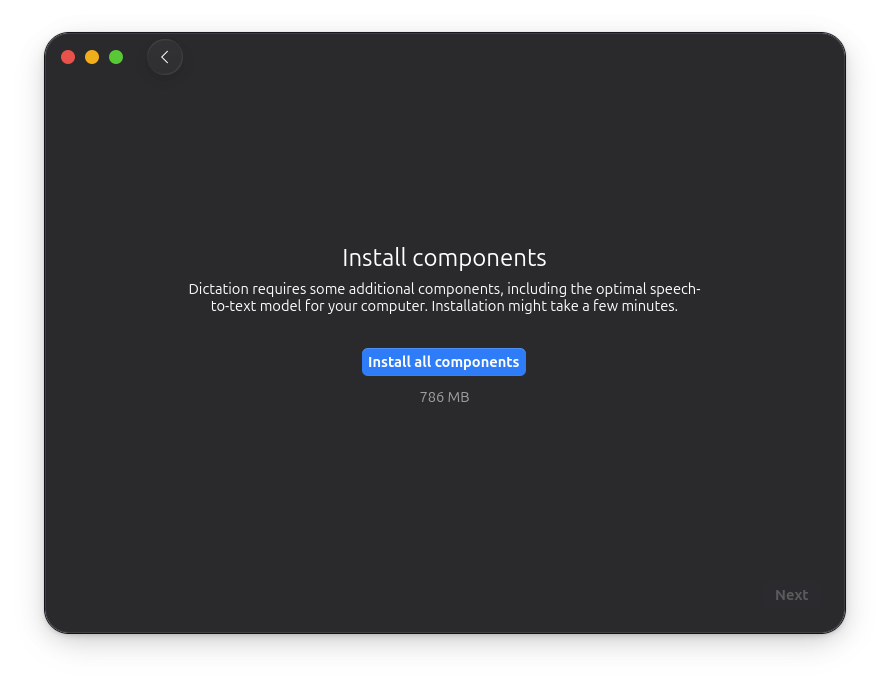
Il est proposé d’installer les composants nécessaires (IA capable de comprendre le français).

L’installation prend quand même un certain temps.

Le logiciel finit en indiquant que la reconnaissance vocale s’active et se désactive par défaut par la combinaison de touches Win + J

Continuer la lecture →

Tutoriel Linux : coder avec un modèle IA local (Ollama + Lumen)

Je me suis rendu compte à l’usage que mon article sur le codage local avec Ollama et Opencode n’était pas viable, Opencode étant plus prévu finalement pour faire fonctionner des modèles IA en ligne plutôt qu’Ollama en local.

Voici donc un nouveau tuto QUI MARCHE !

Installation et configuration d’Ollama

Ollama est le moteur qui fera tourner vos modèles localement.

1. Installation
La méthode la plus simple est le script officiel. Il installe Ollama, configure un service systemd et démarre le service automatiquement .

curl -fsSL https://ollama.com/install.sh | sh

2. Vérification
Après l’installation, vérifiez que le service est actif et que la commande fonctionne.

# Vérifier la version
ollama -v

# Vérifier que le service systemd est actif
sudo systemctl status ollama

Si le service n’est pas actif, démarrez-le avec sudo systemctl start ollama .

3. Téléchargement d’un modèle adapté
Pour Lumen, il faut un modèle capable de « tool calling ». D’après mon expérience, qwen3-vl:8b fonctionne bien avec Lumen. Vous pouvez aussi utiliser d’autres modèles compatibles comme ceux recommandés par Lumen (qwen3-coder:30b, etc.) .

# Télécharger le modèle (adapte selon tes besoins)
ollama pull qwen3-vl:8b

4. Maintenance (Mise à jour)
Pour mettre à jour Ollama, il suffit de relancer le script d’installation. Il remplacera l’ancienne version par la nouvelle .

curl -fsSL https://ollama.com/install.sh | sh

5. Désinstallation complète
Si vous souhaitez tout supprimer (service, binaires, modèles et utilisateur système) :

# Arrêter et désactiver le service
sudo systemctl stop ollama
sudo systemctl disable ollama
sudo rm /etc/systemd/system/ollama.service

# Supprimer les bibliothèques et le binaire
sudo rm -r $(which ollama | tr 'bin' 'lib')
sudo rm $(which ollama)

# Supprimer l'utilisateur, le groupe et les modèles téléchargés
sudo userdel ollama
sudo groupdel ollama
sudo rm -r /usr/share/ollama
Continuer la lecture →

Tutoriel Linux : reverse engineering avec Ghidra

Ghidra est un framework de rétro-ingénierie logicielle développé et maintenu par la Direction de la recherche de la National Security Agency américaine. Il a été officiellement open source en mars 2019 lors de la conférence RSA, sous licence Apache 2.0, ce qui signifie que n’importe qui peut l’utiliser, le modifier et le redistribuer gratuitement. Avant cela, il était utilisé en interne par la NSA pendant des années pour répondre aux défis de rétro-ingénierie les plus complexes de l’agence.

Dans son essence, Ghidra n’est pas un programme unique mais une plateforme d’analyse complète. Elle regroupe un ensemble d’outils de haut niveau pour le désassemblage, l’assemblage, la décompilation, la visualisation graphique, la scriptabilité et la collaboration, capables d’analyser du code compilé sur Windows, macOS et Linux. Sa valeur centrale réside dans le fait qu’elle rend accessible à tous une capacité de décompilation de niveau industriel qui était auparavant réservée à quelques logiciels commerciaux comme IDA Pro.

La fonctionnalité la plus remarquée de Ghidra est son décompilateur. C’est la clé qui a considérablement abaissé la barrière de la rétro-ingénierie. Le décompilateur est capable de reconstruire les instructions assembleur de bas niveau en pseudo-code proche du langage C, permettant de comprendre la logique du programme sans lire instruction par instruction l’assembleur obscur.

Bien que le pseudo-code généré ne puisse pas être compilé directement, il accélère énormément le processus de compréhension. Si le décompilateur de Ghidra peut prendre en charge autant d’architectures de processeurs, c’est parce qu’il utilise deux langages internes : le P-Code et le SLEIGH.

Le P-Code est un langage de représentation intermédiaire : toutes les instructions assembleuses des différentes architectures sont traduites en une forme P-Code unifiée lors de l’analyse, et le décompilateur génère du code C à partir de ce P-Code.

Le SLEIGH est un langage permettant de décrire comment les jeux d’instructions d’un processeur se traduisent en P-Code. C’est cette conception qui permet à Ghidra d’étendre relativement facilement son support à de nouvelles architectures de processeurs.

Les architectures de processeurs prises en charge par Ghidra sont très nombreuses : x86 16/32/64 bits, ARM et AArch64, MIPS, PowerPC, SPARC, le bytecode Java/DEX, ainsi que de nombreuses architectures embarquées comme AVR, PIC, MSP430 et Z80. Cela la rend précieuse non seulement pour l’analyse de logiciels traditionnels, mais aussi pour l’audit de firmware et la recherche en sécurité des systèmes embarqués. En termes de maturité du support, les architectures grand public comme x86-64, x86, ARM/Thumb 32, AArch64, PowerPC et MIPS bénéficient du niveau de support le plus élevé.

Le décompilateur de Ghidra produit ce qu’on appelle souvent un pseudo-code C. Ce n’est pas une restitution du code source original. Les noms de fonctions sont génériques, du type FUN_00401a5, les variables s’appellent var_1 ou param_1, car le compilateur a supprimé les noms originaux lors de la compilation. Les commentaires, les noms de variables et les structures originales ont disparu. Le code obtenu n’est pas compilable en l’état : il contient des casts étranges, des types de données devinés et des constructions qui ne sont pas du C valide. Ghidra vous donne une aide à la compréhension, pas une reconstruction exacte. Vous devrez souvent renommer manuellement les fonctions et variables pour clarifier le code, corriger les types de données mal devinés et reconstruire les structures et définitions de types.

Continuer la lecture →
Tutoriel Linux : Les sockets réseau (Travaux pratiques)

Pour faire suite à l’article sur la théorie, voici l’article sur la pratique en C.

Le principe est simple : tout d’abord nous allons mettre toutes les fonctions en C dont ont besoin un client ou un serveur pour gérer les sockets réseau dans un couple de fichiers sockets.h et sockets.c que voici :

sockets.h :

/*
 * sockets.h
 * ---------
 * Interface des fonctions réseau TCP/UDP, compatible IPv4 et IPv6.
 */
#ifndef SOCKETS_H
#define SOCKETS_H

#include <stddef.h>   /* pour size_t */

/*
 * Crée une socket TCP en écoute sur le port donné (ex: "56000").
 * Retourne un descripteur prêt pour accepter_client(), ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_tcp(const char *port);

/*
 * Crée une socket UDP liée au port donné.
 * Retourne un descripteur, ou -1 en cas d'erreur.
 */
int etablir_socket_ecoute_udp(const char *port);

/*
 * Se connecte en TCP à hote:port (IPv4 ou IPv6, automatique).
 * Retourne un descripteur connecté, ou -1.
 */
int contacter_socket_tcp(const char *hote, const char *port);

/*
 * Se connecte en UDP à hote:port.
 * Retourne un descripteur, ou -1.
 */
int contacter_socket_udp(const char *hote, const char *port);

/*
 * Accepte une connexion entrante sur la socket d'écoute fd_ecoute.
 * - fd_ecoute       : descripteur renvoyé par etablir_socket_ecoute_tcp()
 * - adresse_client  : buffer où sera écrite l'adresse IP du client
 *                     (chaîne lisible, ex: "127.0.0.1" ou "::1")
 * - taille_adresse  : taille du buffer ci-dessus
 *
 * Retourne le descripteur de la connexion client, ou -1.
 * Aucun struct sockaddr n'est exposé à l'appelant.
 */
int accepter_client(int fd_ecoute, char *adresse_client, size_t taille_adresse);

#endif /* SOCKETS_H */

Comme on peut le voir, on a à notre disposition 4 fonctions : 2 fonctions destinées à être utilisées par les programmes serveurs (etablir_socket_ecoute_tcp et etablir_socket_ecoute_tcp) et 2 fonctions destinées à être utilisées par les programmes clients (contacter_socket_tcp et contacter_socket_udp).

Le code de ces fonctions est prévu pour tenter des connexions IPv6 si disponible, et de basculer automatiquement sur IPv4 si IPv6 n’est pas disponible pour la connexion.

Continuer la lecture →