Archives de l’auteur : Valérian

Tutoriel Linux : auto-héberger Snipe-IT, le gestionnaire d’assets pour l’entreprise

Snipe-IT est une solution de gestion de parc informatique qui existe en deux versions : une édition open source que vous pouvez installer sur vos propres serveurs et une offre cloud hébergée par l’équipe derrière le projet. Le produit est utilisé par des organisations de toutes tailles, des établissements scolaires aux grandes entreprises, pour suivre leurs actifs matériels et logiciels.
Le cœur du système repose sur le suivi des actifs. Chaque équipement peut être enregistré avec un numéro de série, un tag unique, un modèle et une étiquette de statut qui indique s’il est déployable, en attente, archivé ou indisponible. L’attribution et le retour des actifs se font en quelques clics, et chaque mouvement est conservé dans un historique détaillé. Il est possible de regrouper les actifs par modèles pour faciliter la gestion en masse, d’ajouter des champs personnalisés pour des informations spécifiques à votre organisation, et de suivre automatiquement la dépréciation ainsi que la fin de vie prévue des équipements.

Au-delà des actifs proprement dits, Snipe-IT permet de gérer les licences logicielles en suivant leurs attributions et leurs dates d’expiration. Les accessoires comme les claviers ou les souris, ainsi que les consommables tels que les toners, peuvent également être inventoriés et attribués.

La gestion des utilisateurs est assez complète. Chaque profil utilisateur affiche un historique centralisé de tous les éléments qui lui ont été confiés. L’importation peut se faire par fichier CSV ou par synchronisation avec Active Directory, LDAP ou Google Secure LDAP. Des rôles et permissions permettent de définir finement les droits d’accès, et le protocole SCIM est pris en charge pour l’approvisionnement automatique des comptes.

Pour ceux qui ont besoin d’interconnecter Snipe-IT avec d’autres outils, l’API REST JSON est le point d’entrée principal. Elle est documentée et permet de développer des automatisations sur mesure. Des intégrations natives existent avec Slack, SAML, JAMF et Kandji, et une passerelle officielle avec Jira est également disponible. La communauté a par ailleurs produit des SDK dans plusieurs langages comme Python, .NET ou PowerShell.

Côté utilisation au quotidien, l’interface est accessible depuis un navigateur et s’adapte aux écrans mobiles, ce qui peut être utile pour des mises à jour sur le terrain. Le logiciel est traduit dans plus de cinquante-cinq langues officiellement, mais les tests en français montrent que les traductions sont incomplètes. Les notifications par email alertent sur les garanties ou licences arrivant à expiration, et des alertes Slack peuvent être configurées pour les attributions et les retours. La génération d’étiquettes de QR codes facilite l’accès aux informations d’un actif via un scanner, et des rapports détaillés peuvent être produits sur les actifs, les licences, les attributions ou la dépréciation.

Une instance de démo est disponible sur le site de l’éditeur.

L’édition open source est gratuite et peut être installée sur vos propres serveurs via docker. L’équipe publie des mises à jour régulières, avec des corrections et des nouvelles fonctionnalités qui apparaissent toutes les quelques semaines. Le code est ouvert et les contributeurs sont nombreux, ce qui assure une certaine transparence et une absence de verrouillage propriétaire.

Continuer la lecture
Fonctionnalités du noyau Linux (Episode 4) – Appels système

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. Et l’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques.

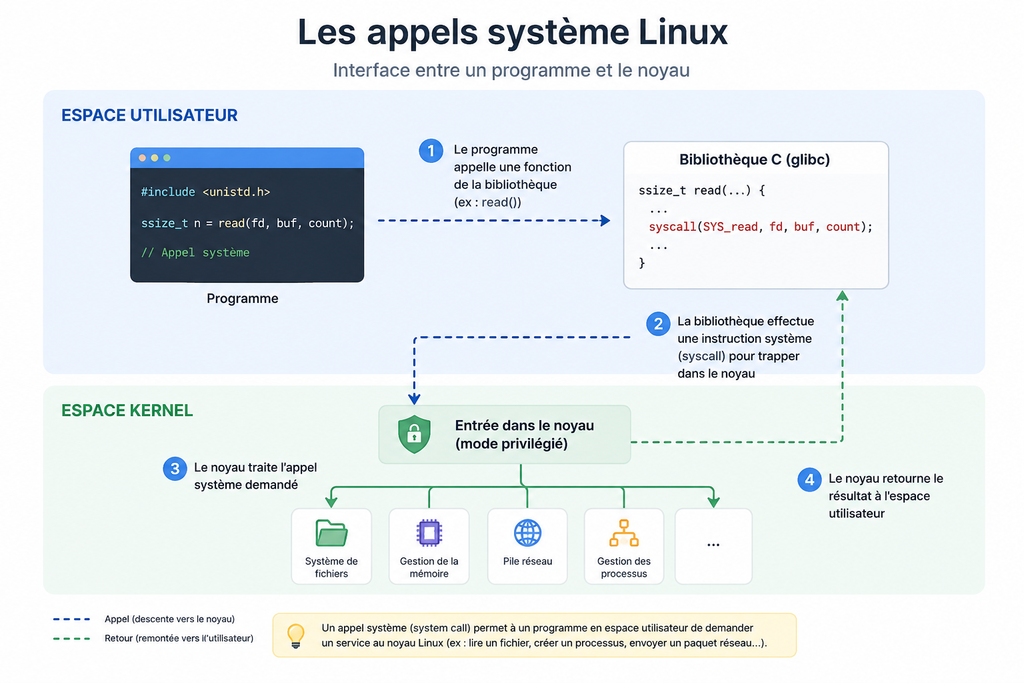
Dans cet épisode 4 nous allons voir comment le noyau Linux offre aux applications un service d’appels système.

La notion même d’appels système est intimement liée au fait que le noyau est installé dans une zone mémoire à hauts privilèges (qu’on appelle par commodité l’espace noyau), alors que les applications tournent dans le reste de la mémoire, sans privilèges particuliers (qu’on appelle par commodité l’espace utilisateur). De facto, le noyau est le seul programme ayant accès au matériel.

Comme les applications ont besoin d’accéder au matériel (pour détecter un clic de souris sur un bouton par exemple, et déclencher le traitement associé), et que le noyau est le seul à avoir l’accès au matériel, de facto on n’y coupe pas : il faut impérativement que le noyau propose aux applications un service d’accès au matériel en passant par lui. Ce service ce sont les appels système.

Le noyau Linux propose un nombre variable d’appels système en fonction de l’architecture cible. Néanmoins, il y a en moyenne un peu plus de 300 appels système implémentés, couvrant tous les besoins possibles des applications : accéder aux fichiers, aux périphériques, aux couches réseaux, à la gestion des processus, etc.

Continuer la lecture

Tutoriel Linux : installer Karakeep, le pocket auto-hébergé

Il y a quelques années le service Pocket rendait de grands services en permettant aux internautes d’y sauvegarder des articles d’Internet pour les lire plus tard.

Malheureusement ce service très utile a fermé ses portes définitivement en 2025.

Fort heureusement, le monde de l’auto-hébergement (self hosting) propose maintenant pléthore de logiciels et services à installer soi-même sur son serveur ou sur son laptop, dont Karakeep, un logiciel web qui rend le même service que Pocket.

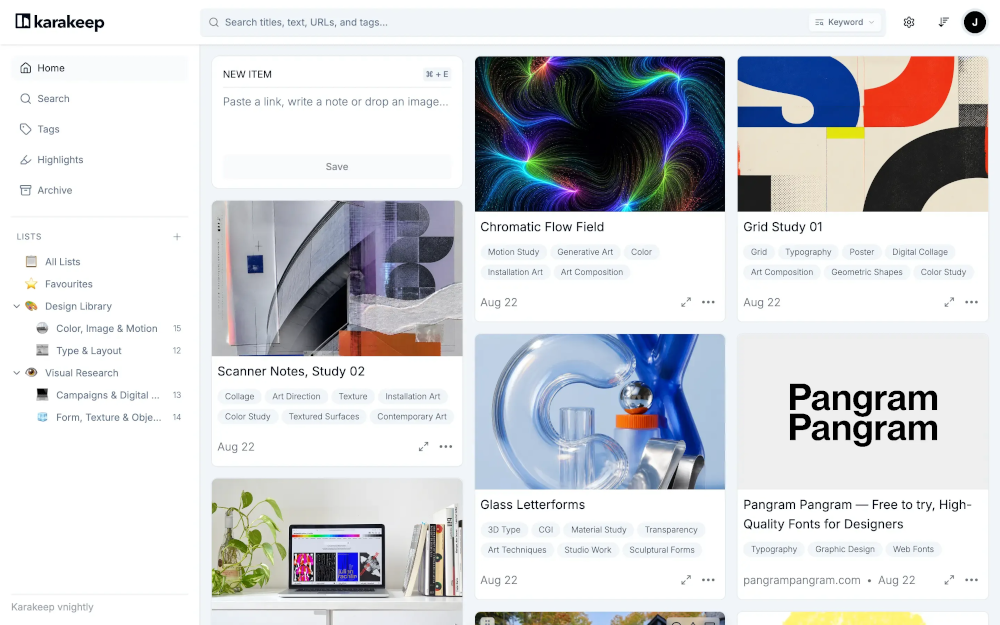
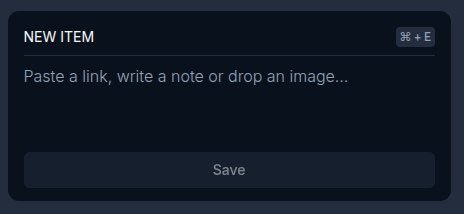
Le principe de fonctionnement est particulièrement simple : vous collez dans la zone « New item » l’URL de l’article qui vous intéresse, et votre article est stocké sous forme de tuile sur la page d’accueil.

Un simple clic sur la tuile ouvre l’article original dans une nouvelle fenêtre du navigateur.

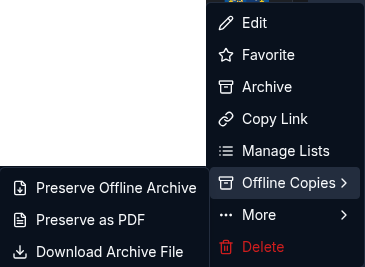
Pour éviter le cas où l’article original aurait disparu du web entre temps, Karakeep permet via un clic droit sur la tuile de télécharger sur le serveur une copie locale de l’article.

Le seul défaut qu’on peut trouver à Karakeep est que l’interface graphique est fournie uniquement en anglais, ce qui ne devrait plus être un problème pour quiconque en 2026.

Continuer la lecture

Tutoriel Linux : auto-héberger IT-tools, une boîte de +80 outils IT indispensables

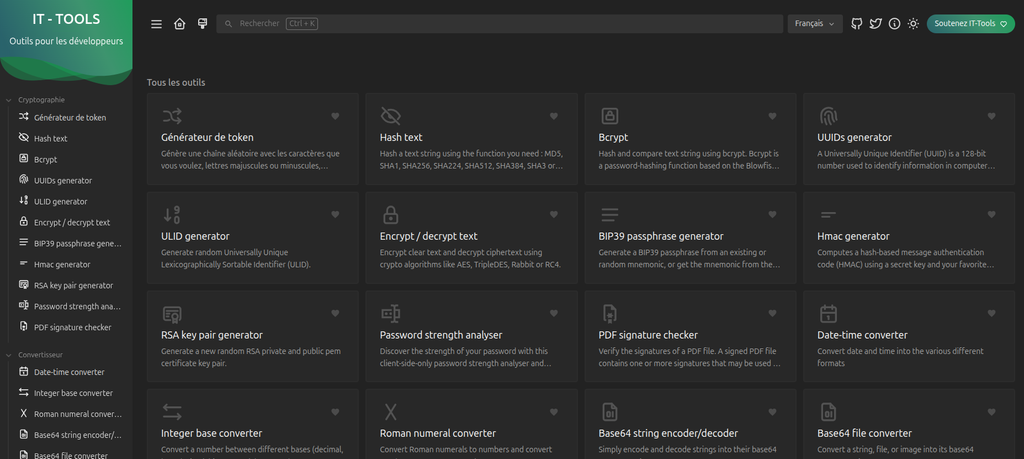
IT-tools est une boîte contenant plus de 80 outils IT indispensables aux personnes travaillant dans le domaine de l’IT. Il est auto-hébergeable sur un serveur en ligne via docker et programmé par le français Corentin Thomasset (ingénieur INSA Lyon).

Une instance en ligne est utilisable directement sur it-tools.tech pour ceux qui auraient la flemme de l’auto-héberger.

Indépendamment de disposer d’une interface web moderne ultra-léchée, la boîte à outil est incroyablement simple à auto-héberger sous docker.

Installation d’IT-tools avec docker compose

Créez un répertoire ittools-docker et mettez-y un fichier docker-compose.yml qui contient :

services:
    it-tools:
        image: ghcr.io/corentinth/it-tools:latest
        ports:
            - "8080:80"
        restart: unless-stopped
        container_name: it-tools

Lancez le service par :

docker compose up -d

Et voilà, c’est installé. Il n’y a plus qu’à se rendre sur http://serveur:8080 pour accéder à la boîte à outils.

Les outils mis à disposition

Le paramétrage de l’interface propose 8 langues, dont bien sûr le français.

Au niveau des outils mis à disposition, c’est le feu d’artifice.

Chaque rubrique propose au moins une dizaine d’outils utilisables d’un clic. Les rubriques couvrent la cryptographie, la conversion de formats, les outils web, la génération de qr codes, le développement, les réseaux, les maths, les mesures, les manipulations de textes, les données.

A chaque mise à jour de l’image docker, on bénéficie d’outils supplémentaires.

Bémol

Attention, la configuration du docker-compose.yml présentée ici aboutit non seulement à un outil en http et non en https, mais aussi un outil accessible à n’importe quel internaute qui connaîtrait l’URL du service.

La seule manière de rendre ce service privé serait de le cacher derrière un reverse proxy présentant à l’internaute une authentification basique.

Tutoriel Linux : monter un répertoire distant avec sshfs

Le noyau Linux supporte un certain nombre de systèmes de fichiers divers et variés (ext2, 3, 4, NTFS, VFAT, etc.). Ce support se fait via des drivers dans le noyau, soit codés en dur et choisis au moment de la compilation du noyau, soit montés dynamiquement sous forme de modules chargeables.

Cependant en octobre 2005, à partir de la version 2.6.14 du noyau Linux, est apparue une fonctionnalité très intéressante : la possibilité donnée aux programmes en espace utilisateur de créer et monter leur propres systèmes de fichiers virtuels, sans avoir à écrire du code noyau.

Cette fonctionnalité, appelée Fuse pour Filesystem in userspace, a été créée par Miklos Szeredi. Cette approche visait à simplifier le développement de systèmes de fichiers, à améliorer la sécurité et la stabilité du système en isolant ces programmes en espace utilisateur, et à résoudre des problèmes de licence liés au développement de modules noyau. FUSE a d’abord été un projet séparé sur SourceForge avant d’être officiellement intégré au noyau Linux.

SSHFS grâce à Fuse

Une fois Fuse disponible sous Linux, beaucoup de programmeurs ont commencé à coder le support Fuse de beaucoup de systèmes de fichiers différents et innovants. Cette tâche de programmation n’est pas forcément aisée car les règles de code source à utiliser sont assez techniques (voir par exemple ce tutoriel en anglais, de l’université du nouveau Mexique).

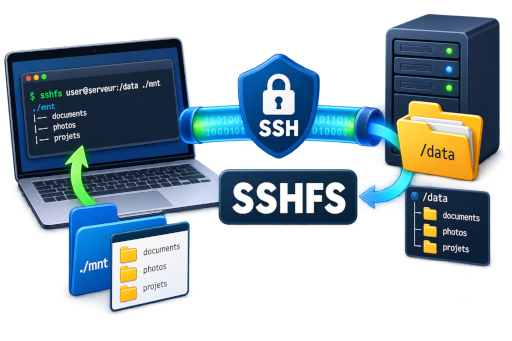
Parmi ces systèmes de fichiers innovants dont le support à été programmé en utilisant Fuse, il y a SSHFS. Comme son nom l’indique, il permet de monter un répertoire distant dans l’arborescence locale en utilisant le tunnel ssh présent entre les deux machines comme canal de communication sous-jacent.

Continuer la lecture

PC portable Ubuntu : préserver la durée de vie de la batterie avec tlp

Le problème

Vous avez un PC portable tout neuf, vous avez installé Ubuntu dessus, tout va bien. Sauf qu’au bout de 2 ou 3 ans vous observez que l’autonomie de votre batterie interne à chuté de 50% !

Vous êtes bon pour avoir à changer la batterie.

Sans le savoir vous avez commis une erreur de débutant : vous n’avez pas installé tlp.

La solution : tlp

Sous Ubuntu, la gestion de la batterie d’un ordinateur portable est assurée par défaut par un service appelé power-profiles-daemon. Il permet de choisir entre trois profils de consommation (« Performance », « Équilibré », « Économie d’énergie ») via l’interface GNOME.

Ce service remplit correctement sa mission : ajuster la consommation électrique en fonction des besoins immédiats de l’utilisateur.

Il ne remplit en revanche pas une autre mission, pourtant essentielle à la longévité du matériel : la préservation de la capacité de la batterie dans le temps. C’est là qu’intervient tlp.

Ce qui se passe sans tlp

Lorsque vous installez Ubuntu et que vous utilisez votre ordinateur portable sans tlp voici ce qui se produit :

1. La batterie est systématiquement chargée à 100 %

Chaque fois que vous branchez votre PC, il se recharge jusqu’à 100 %. C’est le comportement standard de tous les systèmes d’exploitation grand public. Or, maintenir une batterie lithium-ion à 100 % de charge, surtout lorsqu’elle est branchée en permanence, accélère sa dégradation chimique.

2. Une usure prématurée des cellules

Après quelques centaines de cycles de charge, la capacité maximale de la batterie diminue. Ce phénomène est irréversible : les cellules lithium-ion perdent progressivement leur capacité à stocker de l’énergie.

3. Une autonomie réduite

Après 400 à 500 cycles, une batterie ayant toujours été chargée à 100 % peut avoir perdu 30 à 45 % de sa capacité d’origine. L’autonomie chute donc mécaniquement.

4. Un remplacement inévitable

À partir de 60 % de capacité restante, l’autonomie devient insuffisante pour un usage nomade confortable. Le remplacement de la batterie est alors la seule solution.

Continuer la lecture

Fonctionnalités du noyau Linux (Episode 3) – Gestion des périphériques

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux, ainsi que ce que celui-ci réalise en matière de gestion de processus, et dans l’épisode 2 ce qu’il réalise en termes de gestion mémoire.

Pour continuer notre exploration des fonctionnalités du noyau, nous allons, dans cet épisode, aborder la gestion des périphériques.

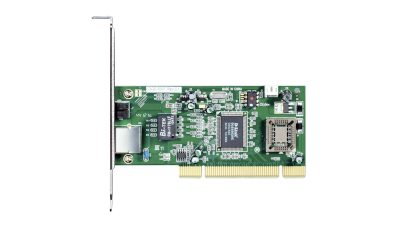
Sur un PC les périphériques sont nombreux : clavier, souris, écran, carte graphique, carte réseau, clé USB, disque dur, SSD, etc.

Dans le monde Windows, les périphériques ont été historiquement livrés par leur constructeur accompagnés par le pilote de périphérique adapté à Windows. Pendant des décennies les constructeurs n’ont pas daigné fournir les pilotes de périphériques (drivers) adaptés à Linux. Les programmeurs du noyau Linux ont donc dû s’adapter en les développant eux-mêmes.

Une technique qui a beaucoup été utilisée est la retro-ingénierie, qui consiste à décortiquer le driver pour Windows jusqu’à ce qu’on ait compris ce qu’il fait et comment il fonctionne.

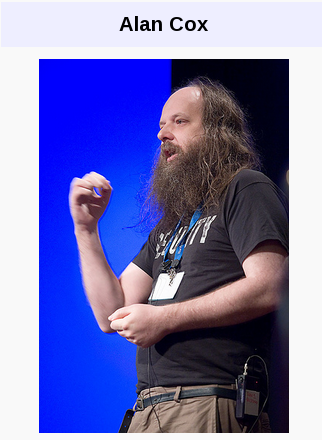
Dans les années 90, lorsque les programmeurs du noyau étaient encore peu nombreux (l’époque où le contributeur numéro deux après Linus Torvalds était le légendaire Alan Cox), il n’y avait généralement presqu’une seule personne derrière chaque famille de drivers.

Alan Cox, la légende

A cette époque, les drivers pour les cartes réseau Ethernet étaient par exemple pratiquement tous codés par un programmeur de la NASA (dont j’ai oublié le nom, on pourrait le retrouver en allant farfouiller dans le code source Linux de ces drivers).

Le monde Linux a donc appris au fil des décennies à coder seul ses drivers. Le noyau est donc devenu de facto très bon pour auto-détecter le matériel.

Jusqu’à la version 0.99.14 du noyau Linux, les drivers étaient en dur dans le noyau. C’était une époque où les utilisateurs de Linux compilaient eux-mêmes un noyau aux petits oignons pour leur machine. Lors de la configuration pré-compilation, on indiquait quels drivers on voulait, et le noyau était ensuite compilé avec ces drivers. Quand on bootait dessus, on avait le support des périphériques dont on avait retenu le driver dans le noyau. Cette action était assez sportive car le driver n’était pas lié à un modèle commercial de périphérique, mais généralement à la puce électronique située au cœur de ce périphérique. Il n’était donc pas rare de devoir consulter Windows pour savoir quelle puce Windows disait détecter.

A partir de la version 0.99.15 du noyau Linux en 1994, celui-ci s’est vu ajouter la fonction de modules chargeables. On pouvait désormais monter ou démonter dynamiquement un driver dans le noyau, ce qui fut une avancée notable.

Au cours des années 2000, des distributions comme Ubuntu ont poussé très loin les mécanismes d’auto-détection du matériel, ces mécanismes se terminant par la montée dynamique du bon driver dans le noyau.

Entre temps, pour la petite histoire, Windows s’est inspiré de Linux en ayant de moins en moins la nécessité d’utiliser des drivers externes fournis par les constructeurs. Les drivers sont intégrés dans le code du noyau Windows.

La gestion des périphériques dans le noyau Linux

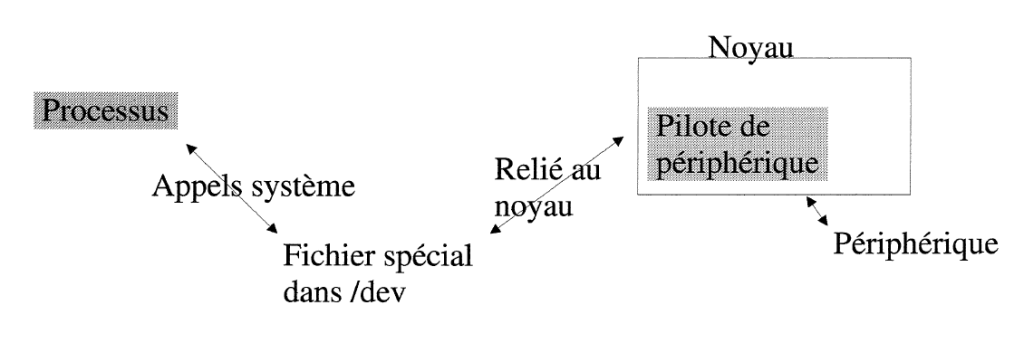
Les périphériques étant du matériel, seul le noyau a les droits pour y accéder. Ces accès se font par des pilotes de périphériques en dur dans le noyau ou montés sous forme de modules comme nous l’avons vu (commande lsmod pour voir quels modules sont montés, insmod pour monter un module, rmmod pour descendre un module).

Continuer la lecture

Tutoriel Linux : auto-héberger le moteur d’automatisation n8n

Si vous cherchez à faire communiquer entre eux des outils comme Google Sheets, Slack, Notion ou votre base de données, n8n est une solution qui mérite le détour. C’est un outil d’automatisation de workflows, un peu dans l’esprit de Zapier ou Make, mais avec une différence importante : vous pouvez l’installer sur vos propres serveurs.

N8n fonctionne avec un modèle « fair-code ». Le code est accessible et modifiable, mais avec quelques restrictions : vous ne pouvez pas revendre la plateforme comme un service hébergé à des tiers. C’est un entre-deux entre le logiciel open-source pur et les solutions totalement fermées.

La version gratuite (appelée Community Edition) peut tourner sur votre infrastructure sans limitation de nombre d’exécutions ni de workflows. Vos données restent chez vous, ce qui peut être un argument décisif si vous travaillez avec des informations sensibles. Si vous préférez éviter de gérer l’installation, une version cloud existe aussi, mais elle est payante.

L’installation avec Docker est simple. Il suffit de lancer le conteneur avec l’image officielle, d’exposer le port 5678 qui est celui de l’interface web, et de monter un volume pour que vos données (workflows, identifiants, paramètres) soient conservées d’un redémarrage à l’autre. Pas besoin de base de données externe pour commencer : n8n utilise SQLite par défaut, un fichier unique léger qui fait très bien l’affaire pour un usage individuel ou en petite équipe.

Principe de fonctionnement

Le principe est simple : vous construisez des workflows en reliant des « neuds » (ou nodes) graphiques à l’écran. Chaque neud correspond à une action ou à une intégration avec un service. n8n en propose plus de 500, ce qui couvre déjà pas mal de besoins courants.

Parmi les intégrations disponibles, on trouve :

  • Les outils de messagerie comme Slack, Teams, Discord ou Telegram
  • Les applications de productivité : Notion, Asana, Jira, Trello
  • L’écosystème Google : Sheets, Drive, Gmail, Calendar
  • Les CRM : HubSpot, Salesforce, Pipedrive
  • Les bases de données : PostgreSQL, MySQL, MongoDB, Redis
  • Les services cloud : AWS, Google Cloud, etc.

Et si le service que vous voulez utiliser n’est pas dans la liste, vous avez toujours la possibilité d’utiliser le neud « HTTP Request » pour envoyer des requêtes à n’importe quelle API. Il y a aussi un neud « Code » qui permet d’écrire un peu de JavaScript ou de Python pour faire des traitements personnalisés.

L’éditeur visuel intègre un débogueur. Vous pouvez voir à chaque étape du workflow ce qui entre et ce qui sort, ce qui aide beaucoup quand un workflow ne fonctionne pas comme prévu.

Continuer la lecture

Fonctionnalités du noyau Linux (Episode 2) – Gestion de la mémoire

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux, ainsi que ce qu’il réalise en matière de gestion de processus.

Dans l’épisode 2 nous allons voir comment le noyau gère la mémoire.

La mémoire dont nous parlons ici est la mémoire RAM physique installée sur l’ordinateur.

Nous avons vu dans l’épisode 1 que, lors du boot de l’ordinateur, le noyau est le premier programme monté en mémoire, et qu’il se verrouille dans une zone de haut privilège.

Le reste de la mémoire physique présente sur la machine est donc disponible pour que le noyau y fasse tourner des processus et y conserve des caches.

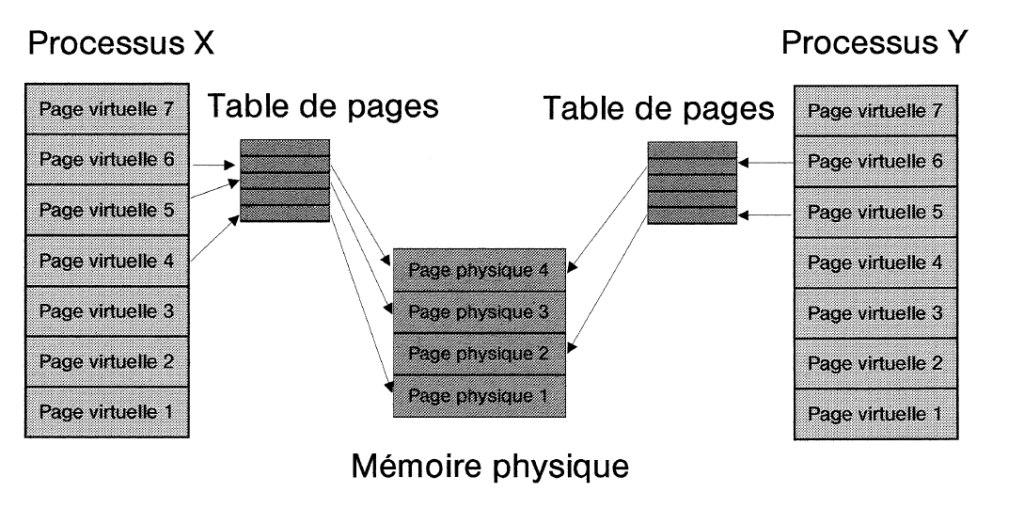
Pour faire tourner ces processus, la mémoire physique sera utilisée sous forme de mémoire virtuelle à base de pages.

Une page fait 4 Ko car c’est la taille standard pour la majorité des micro-processeurs, un bon compromis entre la gestion de la mémoire et les performances.

Pages physiques et pages virtuelles

La figure ci-dessus montre ce qui se passe réellement dans la machine.

Continuer la lecture
Tutoriel Ubuntu : chiffrer un disque ou une clé USB avec LUKS

LUKS (Linux Unified Key Setup) est le standard de chiffrement sous Linux pour chiffrer les disques.

Au passage, on dit bien chiffrer et non crypter. Vous savez pourquoi ? C’est très simple :

  • Chiffrer : rendre illisible des données en utilisant une clé
  • Déchiffrer : rendre lisible des données chiffrées en utilisant la clé de déchiffrement
  • Décrypter : rendre lisible les données chiffrées sans connaître la clé de déchiffrement
  • Crypter : serait donc rendre illisible les données sans connaître la clé, ce qui n’a aucun sens

Bref, revenons à LUKS. C’est un système assez génial qui crée un conteneur chiffré agnostique du système de fichiers qu’on met dedans. On peut donc avoir par exemple une clé USB ext4, VFAT ou NTFS chiffrée.

Le principe de fonctionnement consiste à chiffrer les données avec une unique clé aléatoire de très grande taille, qu’on va appeler MK (Master Key), et ensuite chiffrer MK avec la clé que connait l’utilisateur.

L’avantage de cette méthode est évident : si l’on veut changer la clé utilisateur qui protège le disque, on a juste à rechiffrer MK avec cette clé et non le disque entier, ce qui pourrait prendre des heures.

LUKS est prévu pour fonctionner en mode multi-utilisateurs, c’est à dire qu’il y a un entête mis sur le disque qui contient N fois la clé MK chiffrée par N utilisateurs différents. Ainsi les N utilisateurs peuvent utiliser le disque en ne connaissant que sa propre clé et jamais celle des autres.

Le chiffrement du disque en lui-même, avec la clé MK, se fait en AES 256. C’est très robuste.

Tuto 1 pour chiffrer une clé USB

Continuer la lecture