Archives de l’auteur : Valérian

Fonctionnalités du noyau Linux (Episode 9) – Travaux pratiques sur les appels système dédiés aux pipes

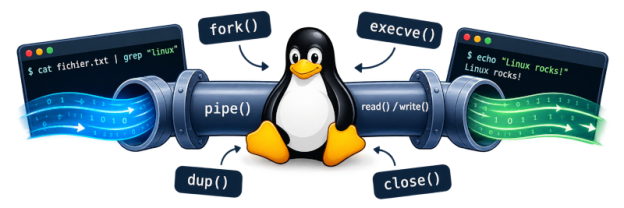
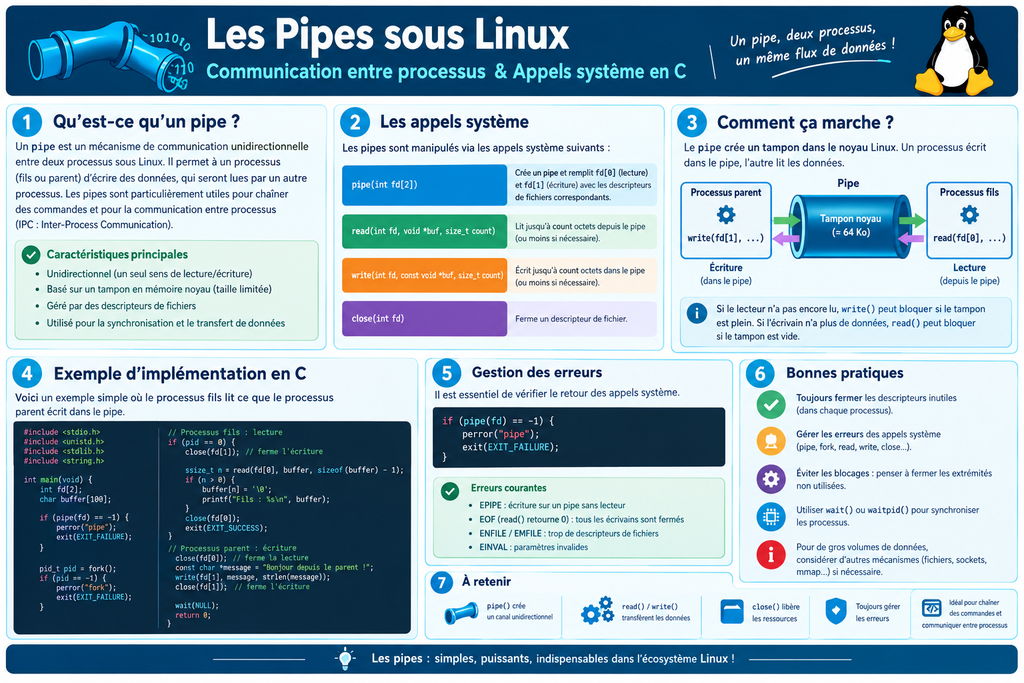
Nous poursuivons l’exploration des fonctionnalités offertes par le noyau aux programmeurs C (appels système). Aujourd’hui nous allons voir ce qu’est un pipe, et comment l’utiliser pour simuler ce que fait l’interpréteur de commandes (shell) bash lorsqu’on y tape une commande mettant en oeuvre des pipes.

Qu’est ce qu’un pipe ?

Un pipe est un tuyau de communication uni-directionnel présent dans le noyau Linux en mémoire. Ce tuyau a donc une entrée et une sortie. Plusieurs processus peuvent se connecter à l’entrée et y écrire des données, tout comme plusieurs processus peuvent se connecter à la sortie et y lire les données.

Les données écrites à l’entrée ressortent (si lues) à la sortie, sans perte et dans le même ordre.

Le nombre de pipes présents dans le noyau est fixé avant la compilation du noyau.

A quoi sert un pipe ?

Nous avons vu dans les épisodes précédents que les processus Unix / Linux sont sur des pages mémoire virtuelles, ce qui garantit, entre autres, qu’ils sont étanches les uns par rapport aux autres.

Un processus A n’a aucun moyen en propre de communiquer des données à un processus B. Il peut le faire mais il doit passer par l’un des moyens de communication inter-processus offerts par le noyau, comme les pipes.

Continuer la lecture →

Tutoriel Linux : faire ressembler exactement le bureau d’Ubuntu 26.04 LTS à celui de MacOS en 12 minutes

MacOS c’est un Unix, au sens de la conformité à la norme POSIX. Linux c’est pareil. On reproche beaucoup aux utilisateurs de Linux de beaucoup taper au shell, mais en réalité c’est juste par habitude.

En effet, sur MacOS on peut aussi ouvrir un shell et y taper exactement les mêmes commandes, elles marcheront. Simplement le cheptel qui utilise un Mac n’est pas habitué à ouvrir un shell.

Bref, certains (et j’en fais partie) pourraient penser que, finalement, MacOS n’est qu’un Linux payant.

Nous allons donc voir comment transformer un PC Linux Ubuntu 26.04 LTS en Mac « gratuit ».

La vidéo est en anglais mais normalement elle bascule automatiquement sur une voix off générée en français. Bonne installation de MacOS !

Tutoriel Linux : capturer des commandes tapées au shell dans un GIF animé

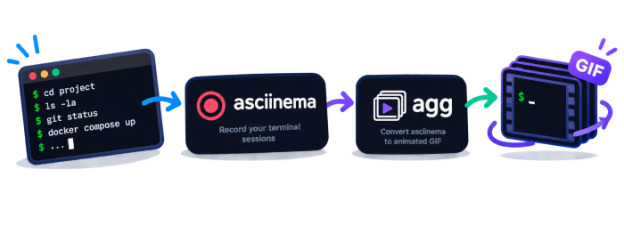
Vous vous êtes peut-être déjà demandé comment tous ces sites web font pour générer des GIF animés qui montrent des commandes tapées dans un shell, comme dans l’exemple ci-dessous.

Nous allons donc voir comment faire. Pour cela nous allons utiliser deux logiciels Linux : asciinema, qui capture le shell sous forme de film, et agg qui transforme ce film en GIF animé.

Installation de asciinema

Sous Ubuntu 26.04, l’installation est très facile :

sudo apt install asciinema

Installation de agg

Malheureusement asciinema n’installe pas toujours agg. On doit souvent (c’est le cas sous Ubuntu 26.04) aller le chercher sur Internet.

Génération d’un GIF animé

Maintenant que asciinema et agg sont installés, la génération d’un GIF animé se fait en 2 commandes shell.

# Enregistrer
asciinema rec demo.cast

# Convertir en GIF
agg demo.cast demo.gif

Et voilà 😎

Tutoriel Linux : page html mise à jour en temps réel par un serveur websocket écrit en langage C

Une websocket est un protocole de communication qui permet d’établir une connexion permanente et bidirectionnelle entre un client (généralement un navigateur) et un serveur. Elle est normalisée par l’IETF sous la référence RFC 6455 et fonctionne au-dessus de TCP.

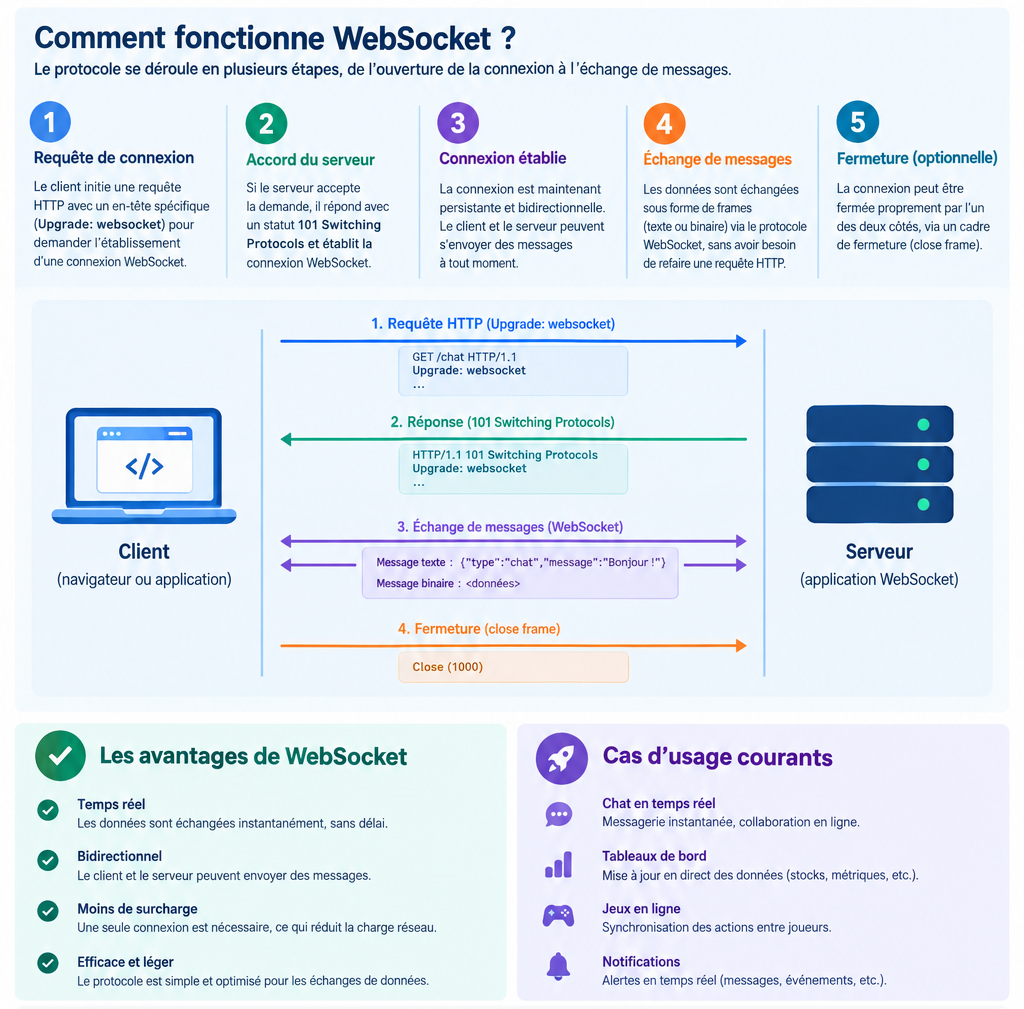
Contrairement au modèle classique du web, où le client envoie une requête et le serveur répond puis ferme la connexion, la websocket maintient un canal ouvert dans les deux sens. Une fois la connexion établie, le client et le serveur peuvent s’envoyer des données à tout moment, sans attendre une nouvelle requête.

Comment la connexion s’établit

La websocket démarre par une requête HTTP classique contenant un en-tête spécifique, Upgrade: websocket. Si le serveur accepte, il répond avec un code 101 (Switching Protocols). À partir de ce moment, la connexion HTTP est transformée en connexion websocket, et les échanges suivent un format de trames propre à ce protocole.

Ce mécanisme de poignée de main permet de réutiliser l’infrastructure existante du web : ports 80 et 443, proxys, TLS. Une websocket peut donc fonctionner en ws:// ou en wss:// pour la version chiffrée.

Continuer la lecture →

Tutoriel Linux : passer de docker à podman

Podman est un moteur de conteneurs développé par Red Hat à partir de 2017.

Sa différence fondamentale avec Docker ne réside pas dans les commandes, mais dans l’architecture.

Docker repose sur un démon qui tourne en permanence avec les privilèges root, et c’est ce service en arrière-plan qui crée et supervise les conteneurs. Podman fonctionne lui sur un modèle fork-exec : lorsque vous tapez une commande, il appelle directement le runtime OCI pour lancer le conteneur, et le processus du conteneur devient un enfant de Podman lui-même. Cette conception réduit la surface d’attaque puisqu’il n’y a pas de service root résident à compromettre, et elle fait du mode rootless le comportement par défaut.

Red Hat a développé Podman précisément parce que l’architecture de Docker posait problème dans les environnements de production critiques. Le démon Docker, constamment actif et disposant des droits root, constitue un point de défaillance unique et une cible de choix pour un attaquant. Podman élimine ce niveau intermédiaire : chaque conteneur est lancé par le processus utilisateur lui-même, ce qui signifie qu’une évasion de conteneur ne donne accès qu’aux droits de cet utilisateur, pas à ceux du système entier.

Sur le plan des parts de marché, Docker reste largement dominant. L’enquête Stack Overflow de 2025 indiquait que 71,1 % des développeurs utilisaient intensivement Docker, contre 11,1 % pour Podman. Ce dernier progresse toutefois rapidement, passant d’environ 5 % en 2024 à 11,1 % en 2025. Dans les environnements d’entreprise, sa part est plus élevée, estimée entre 19 et 23 %, portée par des exigences de sécurité, l’absence de coût de licence et son intégration native avec Red Hat Enterprise Linux et OpenShift.

Installation et utilisation de Podman

Sur Ubuntu 26.04, Podman est disponible directement dans les dépôts officiels.

sudo apt update
sudo apt install podman -y

Vérifiez que l’installation s’est bien déroulée.

podman --version
Continuer la lecture →

Tutoriel Linux : auto-héberger Windshift (équivalent de Jira)

Windshift est un outil de gestion de travail auto-hébergé et open source, publié sous licence AGPL-3.0, pensé pour les équipes qui veulent garder le contrôle de leurs données plutôt que de les confier à un service cloud tiers. Le projet est développé en Go et Svelte, et se présente comme une alternative crédible à Jira, Asana ou ClickUp pour qui souhaite retrouver des concepts familiers (sprints, backlogs, hiérarchies, tableaux) sur sa propre infrastructure.

L’argument central de Windshift tient en une phrase : reprendre le vocabulaire et les habitudes que les équipes ont déjà, sans accepter les conditions d’hébergement, de tarification ou de gouvernance d’Atlassian.

Là où la migration vers Jira Cloud impose des coûts par siège et des politiques de résidence de données qu’on ne maîtrise pas, Windshift propose la même structure mentale sur du matériel qu’on administre soi-même.

L’outil couvre un spectre assez large pour un projet de cette taille : tableaux kanban, jalons, portails clients, suivi du temps, et même un module de gestion des tests qui relie les cas de test aux exigences qui les ont motivés. Cette dernière fonctionnalité est suffisamment rare pour être signalée, même si elle reste à un stade précoce.

La promesse technique se résume à une simplicité assumée. Un seul binaire Go embarque le frontend Svelte compilé, avec SQLite par défaut et PostgreSQL en option si l’équipe grandit. Cela signifie qu’un Raspberry Pi suffit pour commencer, sans couche d’orchestration ni base de données externe à maintenir. Pour les équipes qui n’ont pas d’administrateur système dédié, c’est un argument qui pèse. L’import depuis Jira est intégré pour faciliter la transition : issues, commentaires, pièces jointes, worklogs, tableaux et sprints sont repris avec leur contexte.

Sur le plan de la gouvernance, Windshift permet le choix du modèle d’IA qui traitera les données de travail. On peut utiliser un modèle local ou son propre compte fournisseur, ce qui évite de voir ses données de projet alimenter un système de crédits opaque. Pour les secteurs régulés ou les équipes qui doivent documenter précisément où vivent leurs données, c’est un argument important.

Le projet reste jeune. Première version en décembre 2025, une centaine d’étoiles sur GitHub, une communauté encore réduite. Ce n’est pas un défaut en soi, mais cela signifie que la documentation, les intégrations tierces et l’écosystème de plugins sont moins matures que ceux des concurrents. Les équipes qui cherchent un outil avec dix ans de recul et une armée de contributeurs ne le trouveront pas ici. Celles qui acceptent de participer à l’adoption d’un projet en construction, en échange d’une architecture propre et d’une gouvernance transparente, y trouveront probablement leur compte.

Continuer la lecture →

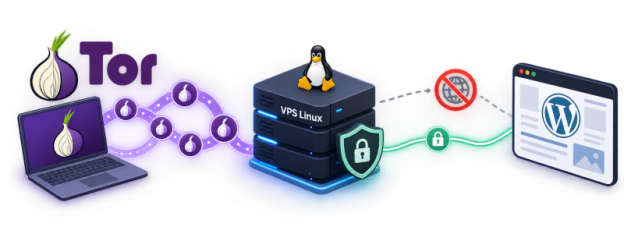
Tutoriel Linux : un site WordPress accessible uniquement comme hidden service TOR

Ce tutoriel trouve son utilité dans un environnement répressif, dans lequel il pourrait être utile de cacher l’adresse IP réelle d’un serveur web.

Dans ce tutoriel, l’architecture que nous allons monter consiste à monter sur un VPS un conteneur docker contenant le CMS WordPress, associé à un conteneur TOR hidden service. Le conteneur WordPress n’exposant aucun port sur Internet, il ne peut être joint avec une adresse IP v4 ou v6.

Le conteneur TOR hidden service fera l’interface entre le monde des clients TOR et le conteneur WordPress.

Le résultat que nous allons obtenir est un site web WordPress accessible uniquement via TOR sur une adresse en .onion. Ce site web n’aura pas de nom de domaine au sens classique du terme (uniquement une adresse onion TOR) et donc n’aura pas besoin de quémander un certificat https à Letsencrypt (la sécurité des accès sera assurée par le réseau TOR lui-même).

Installation

L’installation se fait grâce à deux conteneurs docker, il faut donc que votre serveur soit prêt à lancer des services docker. Si ce n’est pas le cas, vous trouverez le guide d’installation docker sous Ubuntu ici et celui de Devuan ici.

Continuer la lecture →

Tutoriel Linux : installer ClamAV pour tracker les virus

ClamAV est un moteur antivirus open source. Il a été créé à l’origine pour analyser les courriers électroniques sur les passerelles de messagerie, et cette origine explique en grande partie sa conception et ses usages actuels.

Il est aujourd’hui maintenu par Cisco, qui l’a repris après l’acquisition de Sourcefire, lui-même ayant absorbé l’équipe d’origine. Le projet reste distribué sous licence libre et continue d’être développé activement.

Sur Linux, ClamAV n’est pas un antivirus grand public doté d’une protection en temps réel activée par défaut. C’est un ensemble de composants : un moteur d’analyse, une base de signatures, un scanner en ligne de commande, un démon, et divers outils d’intégration. On le trouve dans les dépôts de la plupart des distributions, ainsi que sous forme de paquets officiels fournis directement par l’équipe du projet. Ces deux modes de distribution ne se comportent pas de la même manière, les paquets officiels laissant davantage de configuration manuelle à l’administrateur.

Le fonctionnement de ClamAV repose sur une base de signatures. Cette base est mise à jour régulièrement depuis des miroirs officiels, soit manuellement, soit automatiquement selon le mode d’installation. Sans base à jour, le moteur ne détecte rien, ce qui est la cause la plus fréquente de faux sentiment de sécurité. La base contient des signatures de virus, vers, chevaux de Troie et autres malwares, mais elle est surtout orientée vers les menaces touchant Windows, ce qui est cohérent avec son rôle d’analyse de courrier et de fichiers échangés entre systèmes hétérogènes.

ClamAV propose deux modes d’analyse principaux. Un scanner en ligne de commande, qui charge les signatures à chaque exécution, effectue l’analyse demandée puis se termine. C’est simple, mais peu efficace pour des analyses répétées ou volumineuses. Et un démon, qui charge les signatures une fois et reste actif, prêt à répondre aux demandes d’analyse via une socket locale ou réseau. Ce second mode est celui utilisé pour les analyses régulières, les serveurs de fichiers ou les passerelles. Une interface client distincte permet de dialoguer avec ce démon.

Le moteur peut être intégré à d’autres logiciels. Sur les serveurs de messagerie, un composant dédié s’intercale entre l’agent de transfert et analyse les messages au vol, avec différentes politiques possibles selon la configuration. Le projet fournit également des bibliothèques permettant à des applications tierces d’utiliser le moteur d’analyse directement. C’est cette intégration qui fait de ClamAV un composant courant dans les chaînes de traitement de courrier et les plateformes de partage de fichiers.

Depuis quelques années, ClamAV propose une analyse à l’accès sur Linux, fondée sur un mécanisme du noyau qui permet de surveiller les accès aux fichiers. Cette fonctionnalité peut se contenter de signaler les fichiers suspects ou aller jusqu’à bloquer l’accès, selon la configuration. Elle n’est disponible que sur Linux et dépend d’une version de noyau suffisamment récente. Son coût en performances est réel si elle est appliquée à des répertoires très sollicités, et elle reste optionnelle.

Il existe enfin des interfaces graphiques pour ClamAV, généralement développées par des tiers plutôt que par le projet lui-même. Elles permettent de lancer des analyses, de consulter les résultats et parfois de gérer la mise à jour des signatures sans passer par la ligne de commande. Ces interfaces restent des surcouches : elles ne changent rien au moteur ni à ses limites. Elles peuvent convenir à un usage ponctuel sur un poste de travail, mais elles sont rarement adaptées à l’administration d’un serveur ou d’une passerelle.

Continuer la lecture →
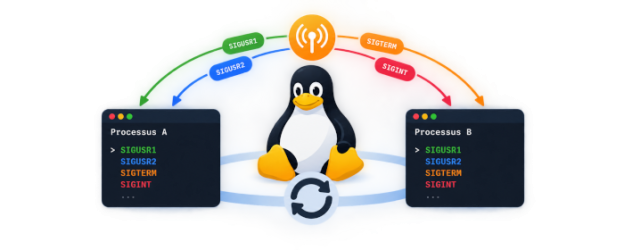
Fonctionnalités du noyau Linux (Episode 8) – Travaux pratiques sur les appels système dédiés à la synchronisation des processus par signaux

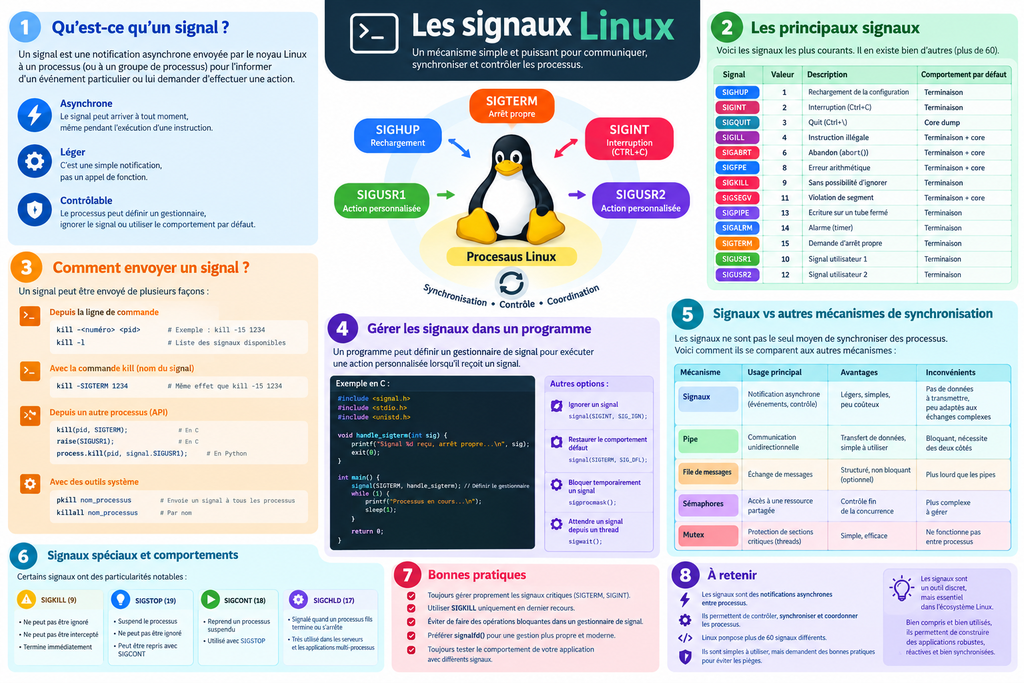
Les signaux sous Linux sont un mécanisme de communication inter-processus utilisé par le noyau pour notifier un processus qu’un événement s’est produit. Nous avons déjà consacré une introduction aux signaux dans l’épisode 5.

Contrairement aux appels système classiques, ils sont asynchrones : un processus peut recevoir un signal à n’importe quel moment, ce qui interrompt temporairement son exécution normale.

Chaque signal possède un numéro et un nom symbolique défini dans le fichier d’en-tête signal.h. Les signaux standard vont de 1 à 31, tandis que les signaux temps réel, plus nombreux, occupent généralement les numéros 32 à 64.

Un signal peut être envoyé par le noyau lui-même, par un autre processus via l’appel système kill, ou par le processus lui-même avec raise.

#include <signal.h>

int kill(pid_t pid, int sig); // pid = numéro du processus à atteindre, sig numéro du signal à lui envoyer
int raise(int sig); // équivalent à kill(getpid(),sig);

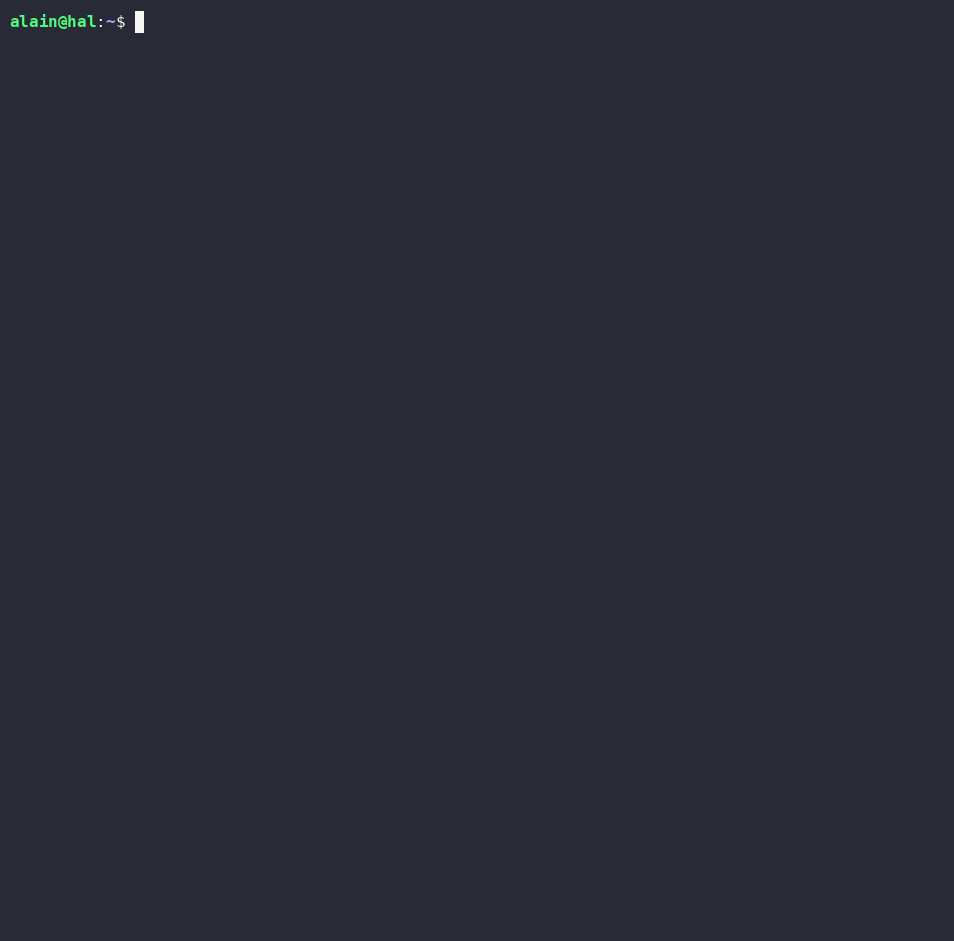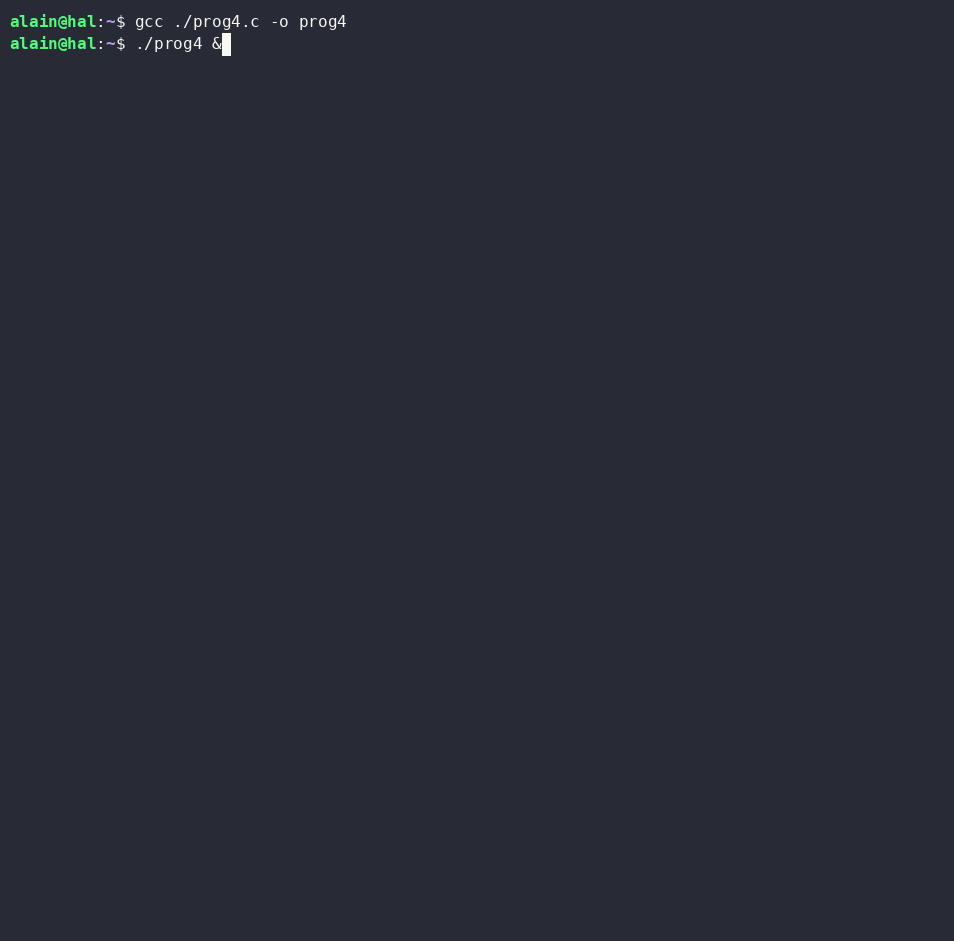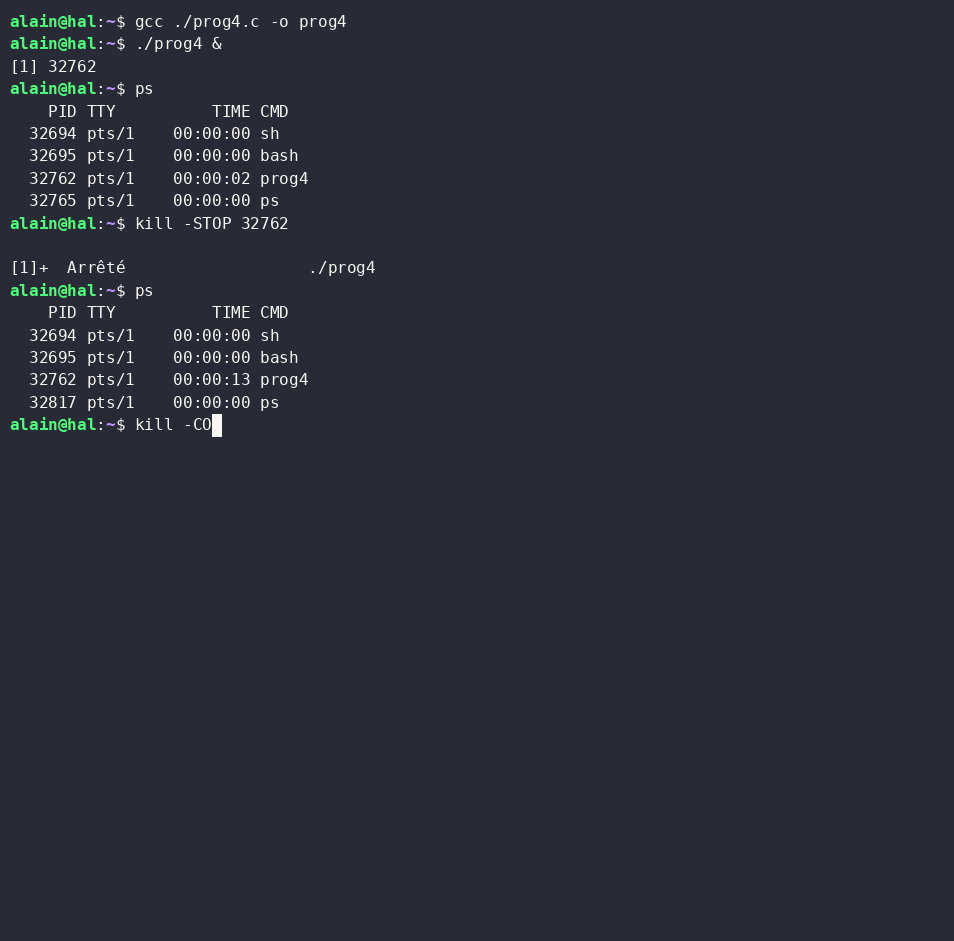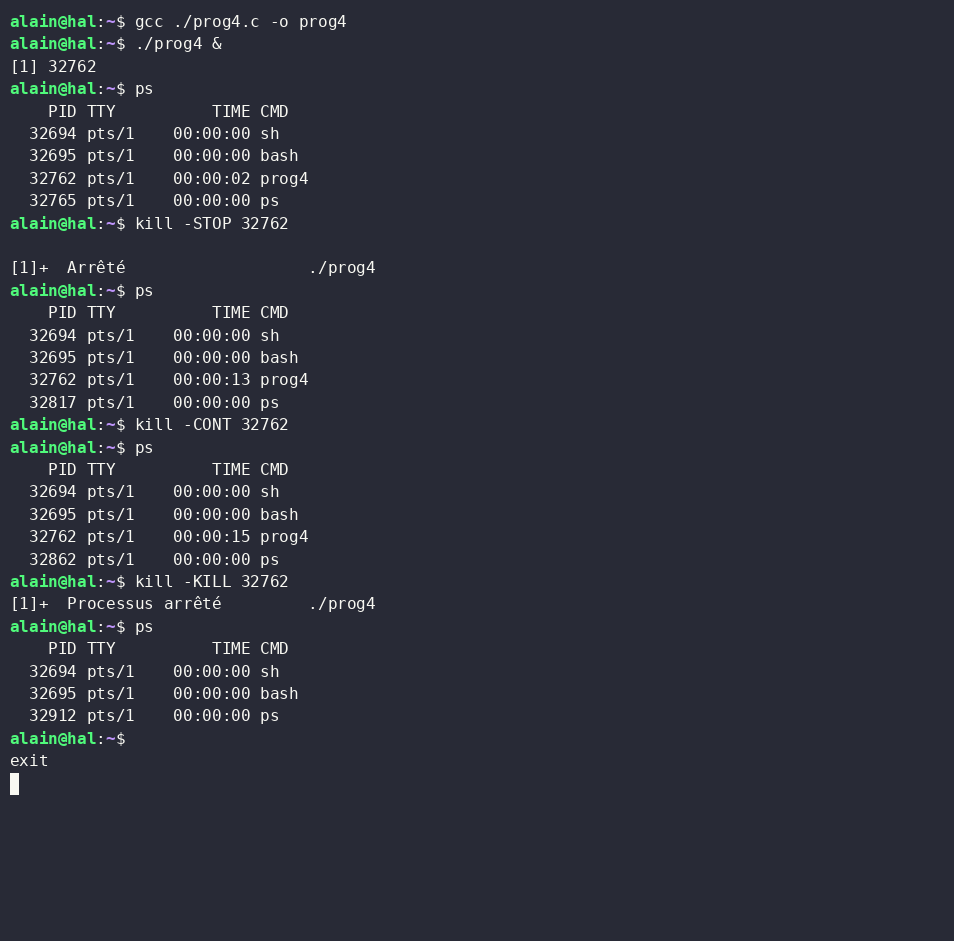
L’utilitaire en ligne de commande kill permet également d’envoyer un signal à un processus identifié par son PID, et pkill ou killall le font par nom.

Chaque signal a une action par défaut. Pour la plupart, cette action est de terminer le processus. Certains signaux comme SIGSEGV ou SIGFPE indiquent une erreur matérielle ou logicielle grave.

Continuer la lecture →