Archives par étiquette : Linux

Tutoriel Linux : créer un réseau VPN Nebula

Nebula est né d’une difficulté d’ingénierie bien concrète. Vers la fin de 2016, le réseau de production de Slack connaissait une expansion rapide, et la solution IPSec utilisée alors pour relier les serveurs entre les régions commençait à montrer ses limites. Chaque paquet traversant les régions devait passer par un hôte tunnel IPSec, ajoutant un saut de latence sans contrepartie.

Plus problématique encore : à mesure que le réseau s’étendait sur plusieurs fournisseurs de cloud et des dizaines de sites, les « groupes de sécurité » propres à chaque fournisseur devenaient incompatibles entre eux, et les règles de pare-feu se réduisaient à une gestion grossière par plages d’adresses IP.

Nate Brown et Ryan Huber ont évalué toutes les solutions disponibles à l’époque. Aucune ne satisfaisait simultanément les exigences de Slack en matière de performance, d’échelle et de simplicité opérationnelle. Ils ont donc décidé de construire la leur. Le résultat de cette décision s’appelle Nebula, un système de réseau superposé qui, depuis le milieu de l’année 2017, porte l’essentiel du trafic réseau de Slack en interne, et qui n’a été basculé en open source qu’en novembre 2019.

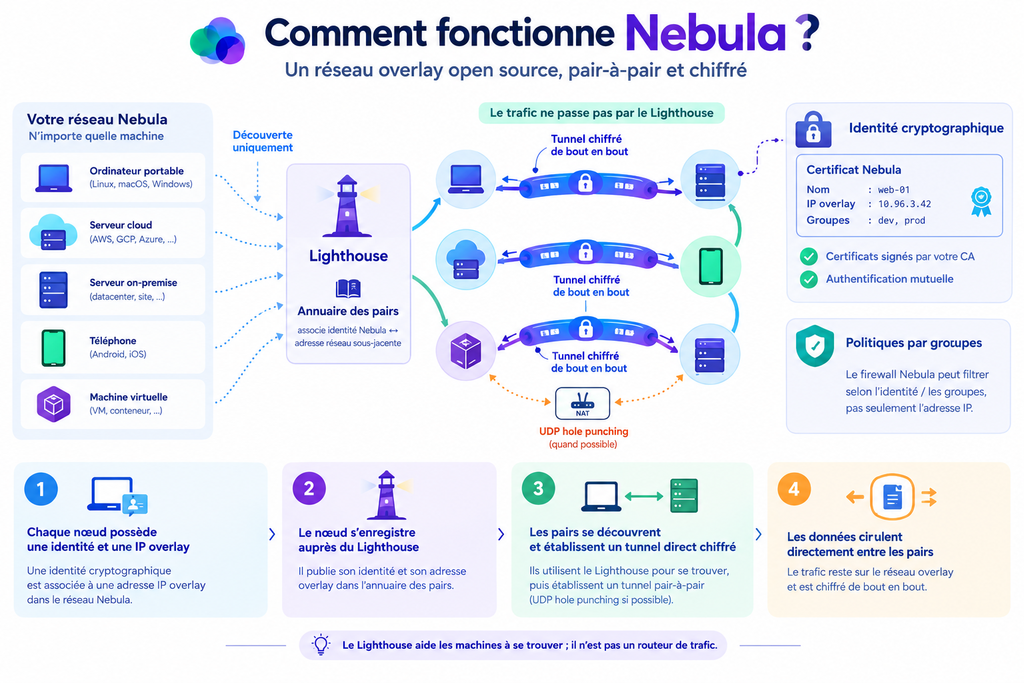
Le principe de conception central de Nebula peut se résumer ainsi : intégrer l’identité numérique directement dans le tunnel chiffré, afin d’éliminer ce problème de distribution des clés qui empoisonne les architectures VPN traditionnelles. En effet, dans la plupart des réseaux superposés bâtis sur WireGuard, le chiffrement est assuré par WireGuard, mais la gestion des clés, l’authentification et le contrôle d’accès reposent sur un système latéral construit séparément. Cela signifie que lorsqu’une nouvelle machine rejoint le réseau, le service de coordination doit prévenir tous les nœuds existants pour qu’ils mettent à jour leur configuration. À l’échelle de Slack, c’est-à-dire plus de cinquante mille machines de production, chaque nouveau nœud impliquait d’informer cinquante mille nœuds de son existence, une approche intenable.

La solution de Nebula consiste à faire porter l’identité par des certificats PKI. Chaque machine reçoit, avant de rejoindre le réseau, un certificat signé par une autorité de certification, dans lequel sont encodés son adresse IP au sein du réseau superposé, son nom, ainsi que son appartenance à des groupes de sécurité définis par l’utilisateur. Lorsque deux machines communiquent pour la première fois, elles échangent et vérifient directement leurs certificats, confirment mutuellement leur identité, puis établissent un tunnel chiffré. Ce processus ne nécessite aucune distribution préalable de clés par un tiers, ni l’intervention d’un plan de contrôle pour coordonner les échanges. Selon les mots de Ryan Huber, ils voulaient un protocole qui traite directement l’identité et le transport, plutôt que d’accoler une identité à un VPN distinct.

Cette logique de décentralisation se retrouve également dans le mécanisme de découverte des nœuds. Il existe dans un réseau Nebula une catégorie de nœuds appelés Lighthouse (phare en français), dont l’unique fonction est de servir d’annuaire : indiquer à une machine comment en trouver une autre. Les Lighthouse ne communiquent pas entre eux et ne participent à aucun transfert de données. Si un réseau compte six Lighthouse et que cinq d’entre eux tombent en panne, le dernier continue de fonctionner normalement, et les chemins de trafic de l’ensemble du réseau restent inchangés.
Continuer la lecture →

Tutoriel Linux : auto-héberger son moteur de recherche

Pour être franc, je visualise peu l’intérêt qu’il y a à auto-héberger son moteur de recherche. Quand bien même on est lassé du tracking que fait Google, il y a déjà des solutions qui permettent d’éviter ce tracking, comme le moteur de recherche StartPage par exemple, qui interroge Google pour nous, ou des moteurs alternatifs comme DuckDuckGo.

Mais bon, on peut. Donc on va voir comment faire cela.

Installer Degoog avec docker

L’installation se fait grâce à un conteneur docker, il faut donc que votre serveur soit prêt à lancer des services docker. Si ce n’est pas le cas, vous trouverez le guide d’installation docker sous Ubuntu ici et celui de Devuan ici.

Dans un répertoire dédié, créer un fichier docker-compose.yml avec pour contenu (changer le mot de passe par celui que vous choissirez) :

services:
  degoog:
    image: ghcr.io/degoog-org/degoog:latest
    container_name: degoog
    restart: unless-stopped
    ports:
      - "8100:4444"
    volumes:
      - ./data:/app/data
    environment:
      - DEGOOG_SETTINGS_PASSWORDS=MotDePasseAChanger
      - DEGOOG_PUBLIC_INSTANCE=true

Puis faites :

mkdir data
docker compose up -d
Continuer la lecture →

Tutoriel Linux : compiler le langage C

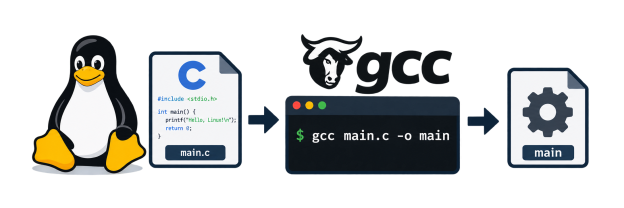
Le langage C est incontournable en environnement Linux, et pas seulement parce que le noyau Linux lui-même est programmé à 99% en C.

En effet, tous les binaires exécutables présents sur un système Linux, quel que soit le langage dans lequel ils sont développés, utilisent la librairie C, qui est le point de passage obligé pour s’interfacer avec les appels systèmes offerts par le noyau. Beaucoup de ces langages sont en réalité traduits en C avant d’être compilés (ce qui est assez cocasse), d’autres comme Python sont interprétés par un interpréteur écrit en C.

Comme nous l’avons déjà vu, les appels systèmes réellement offerts par le noyau (les vrais) sont différents des appels système offerts par la librairie C (souvent appelée libc pour faire court). Les (faux) appels système de la libc sont les seuls à être standardisés par la norme POSIX, qui définit les appels systèmes à implémenter dans un système Unix. La libc est parfaitement conforme (et offre même des appels système en plus) à la norme POSIX. Ne laissez donc jamais un incompétent vous affirmer que Linux n’est pas un Unix.

Le langage C est un langage merveilleux, très simple à apprendre (c’est ce qui a fait son succès), avec lequel on peut absolument TOUT programmer (même des applications web). C’est LE langage par excellence, celui qui, quand on le maîtrise, fait qu’on n’a plus besoin de s’intéresser aux autres langages de programmation.

Tout simple qu’il soit, il n’est pas question dans cet article d’apprendre la programmation C. Le lecteur se référera pour cela à un livre dédié comme celui-ci :

Ou mieux, le Kernighan et Ritchie original, écrit par les deux créateurs du langage C, que tout afficionado de Linux se doit d’avoir dans sa bibliothèque :

Continuer la lecture →

Tutoriel Linux : auto-héberger Ntfy, le service de notification de smartphones

Lorsqu’on développe une application web qui ambitionne de tourner sur mobile, on n’a que peu d’accès au matériel du smartphone (notifications, GPS, etc.), contrairement à une application mobile native.

Accéder à une notification des clients sur smartphones depuis une application web n’est pas impossible, mais au prix de circonvolutions et de ruses de Sioux techniques.

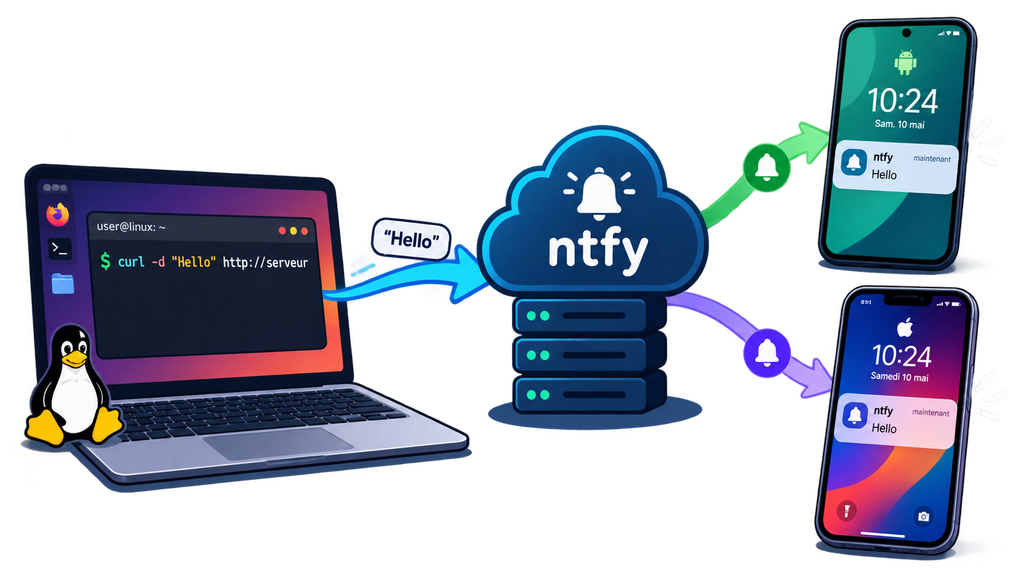
Heureusement, on peut laisser de côté la recherche de cet exploit technique puisqu’il existe un service clé en main qu’on peut utiliser pour faire notifier des smartphones depuis une application web : Ntfy (prononcer notify).

Ntfy est un service de notification. Il ne fait que cela, mais il le fait très bien. Ce service existe sous forme de SaaS ou auto-hébergeable gratuitement. C’est cette version gratuite auto-hébergée que nous allons mettre en place dans ce tutoriel.

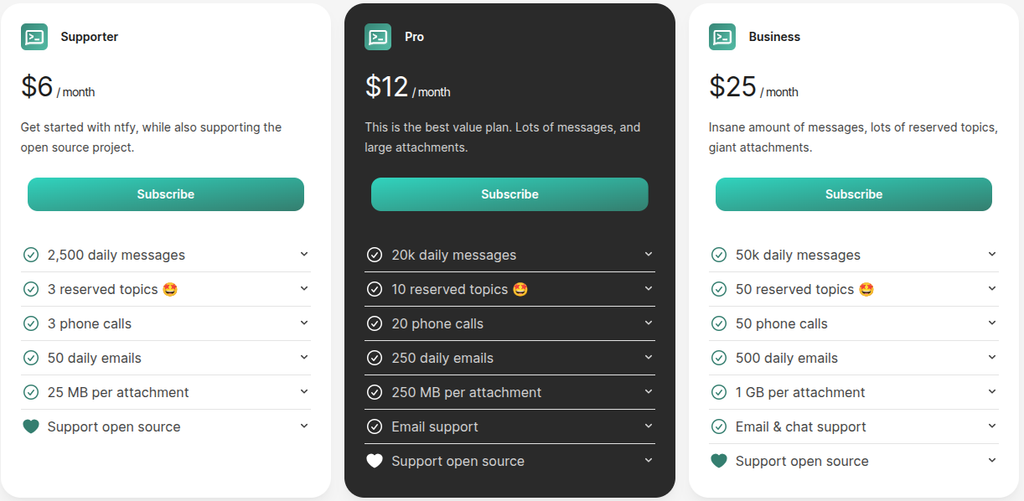
Prix des plans payants de la version SaaS
Continuer la lecture →

Tutoriel Linux : obfusquer le trafic Wireguard

Mettre en place un tunnel Wireguard entre des machines et un serveur est très utile mais cela n’est pas discret.

En effet, s’il est impossible pour un intervenant extérieur de visualiser en clair le trafic vu qu’il est chiffré, la nature Wireguard du trafic est par contre très facile à déterminer.

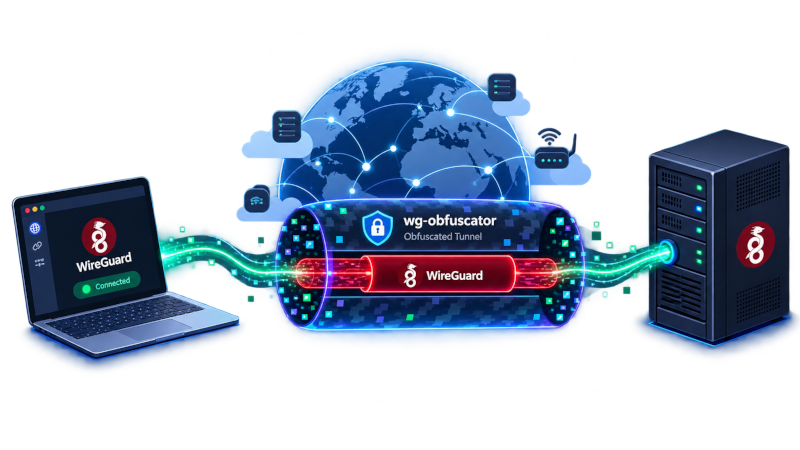
Dans un environnement réseau sous surveillance interdisant le trafic Wireguard, celui-ci sera facilement bloqué. La solution pour passer quand même est d’obfusquer le trafic en l’encapsulant dans un tunnel d’obfuscation.

Celui que nous allons utiliser dans ce tutoriel est wg-obfuscator, qui obfusque le trafic pour le faire ressembler à une visio-conférence, soit une nature de trafic moins sujet à des filtrages.

Rappel : l’installation de Wireguard sans obfuscation a déjà été couverte dans cet article.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 5) – Communication inter-processus

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. L’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques. Dans l’épisode 4 nous avons vu comment le noyau Linux offre aux applications un service d’appels système.

Dans cet épisode 5 nous allons voir les mécanismes qu’offre le noyau Linux aux processus tournant sur le système pour communiquer entre eux, c’est à dire pour se synchroniser et/ou s’envoyer des données.

Rappelons que ces mécanismes sont indispensables car, comme nous l’avons vu dans l’épisode 2 consacré à la gestion de la mémoire, les processus vivent en mémoire virtuelle paginée utilisateur ce qui rend leur espace mémoire complètement étanche avec celui des autres processus.

Sans mécanisme particulier additionnel, la communication inter-processus ne serait tout simplement pas possible par construction.

Le noyau Linux, comme tous les Unices (pluriel d’Unix), offre 2 mécanismes de synchronisation (signaux et sémaphores) et 5 mécanismes d’échange de données (segments de mémoire partagée, files de messages, pipes, pipes nommés, et sockets Unix). Nous allons balayer le fonctionnement de ces mécanismes, dont nous étudierons l’utilisation dans des programmes en langage C dans des articles ultérieurs.

Les signaux

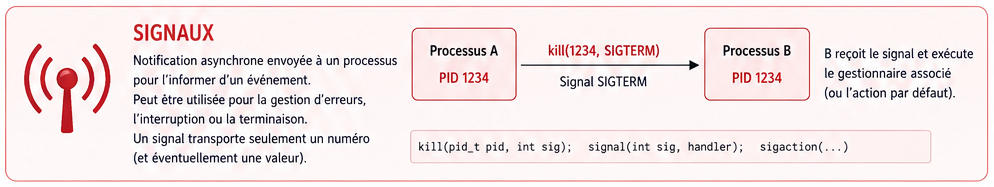
Les signaux sont un mécanisme de communication inter-processus qui permet d’envoyer des notifications asynchrones à un processus pour l’informer qu’un événement s’est produit. On peut les voir comme des « interruptions logicielles » qui permettent au noyau, à un autre processus ou à un utilisateur de contrôler et d’interagir avec un programme en cours d’exécution.

Un signal peut être généré par :

  • L’utilisateur : Par des combinaisons de touches comme Ctrl+C par exemple.
  • Le noyau : Pour signaler une erreur matérielle ou logicielle (par exemple, une division par zéro ou un accès mémoire invalide).
  • Un autre processus : Via des commandes shell comme kill ou des appels système.

Lorsqu’un signal est envoyé à un processus (en indiquant son PID), celui-ci peut y réagir de quatre manières différentes :

  1. Exécuter l’action par défaut : Souvent, cela termine le processus. Parfois, le signal est ignoré.
  2. Ignorer le signal : Le processus ne fait rien et continue son exécution.
  3. Intercepter le signal (avec un gestionnaire, ou callback) : Le processus exécute une fonction personnalisée pour traiter l’événement.
  4. Bloquer le signal : Le signal est mis en attente et ne sera délivré que lorsque le processus le débloquera.

Chaque signal est connu par un nom (SIGKILL, SIGSTOP, etc.) ou par son numéro.

Les signaux SIGKILL (signal qui porte le numéro 9) et SIGSTOP (qui porte les numéros 19, ou 23) sont des exceptions. Ils ne peuvent ni être interceptés, ni ignorés, ni bloqués. Cela garantit que l’utilisateur ou l’administrateur peut toujours stopper un processus, même s’il est défaillant.

Continuer la lecture →

Tutoriel Linux : auto-héberger Snipe-IT, le gestionnaire d’assets pour l’entreprise

Snipe-IT est une solution de gestion de parc informatique qui existe en deux versions : une édition open source que vous pouvez installer sur vos propres serveurs et une offre cloud hébergée par l’équipe derrière le projet. Le produit est utilisé par des organisations de toutes tailles, des établissements scolaires aux grandes entreprises, pour suivre leurs actifs matériels et logiciels.

Le cœur du système repose sur le suivi des actifs. Chaque équipement peut être enregistré avec un numéro de série, un tag unique, un modèle et une étiquette de statut qui indique s’il est déployable, en attente, archivé ou indisponible. L’attribution et le retour des actifs se font en quelques clics, et chaque mouvement est conservé dans un historique détaillé. Il est possible de regrouper les actifs par modèles pour faciliter la gestion en masse, d’ajouter des champs personnalisés pour des informations spécifiques à votre organisation, et de suivre automatiquement la dépréciation ainsi que la fin de vie prévue des équipements.

Au-delà des actifs proprement dits, Snipe-IT permet de gérer les licences logicielles en suivant leurs attributions et leurs dates d’expiration. Les accessoires comme les claviers ou les souris, ainsi que les consommables tels que les toners, peuvent également être inventoriés et attribués.

La gestion des utilisateurs est assez complète. Chaque profil utilisateur affiche un historique centralisé de tous les éléments qui lui ont été confiés. L’importation peut se faire par fichier CSV ou par synchronisation avec Active Directory, LDAP ou Google Secure LDAP. Des rôles et permissions permettent de définir finement les droits d’accès, et le protocole SCIM est pris en charge pour l’approvisionnement automatique des comptes.

Pour ceux qui ont besoin d’interconnecter Snipe-IT avec d’autres outils, l’API REST JSON est le point d’entrée principal. Elle est documentée et permet de développer des automatisations sur mesure. Des intégrations natives existent avec Slack, SAML, JAMF et Kandji, et une passerelle officielle avec Jira est également disponible. La communauté a par ailleurs produit des SDK dans plusieurs langages comme Python, .NET ou PowerShell.

Côté utilisation au quotidien, l’interface est accessible depuis un navigateur et s’adapte aux écrans mobiles, ce qui peut être utile pour des mises à jour sur le terrain. Le logiciel est traduit dans plus de cinquante-cinq langues officiellement, mais les tests en français montrent que les traductions sont incomplètes. Les notifications par email alertent sur les garanties ou licences arrivant à expiration, et des alertes Slack peuvent être configurées pour les attributions et les retours. La génération d’étiquettes de QR codes facilite l’accès aux informations d’un actif via un scanner, et des rapports détaillés peuvent être produits sur les actifs, les licences, les attributions ou la dépréciation.

Une instance de démo est disponible sur le site de l’éditeur.

L’édition open source est gratuite et peut être installée sur vos propres serveurs via docker. L’équipe publie des mises à jour régulières, avec des corrections et des nouvelles fonctionnalités qui apparaissent toutes les quelques semaines. Le code est ouvert et les contributeurs sont nombreux, ce qui assure une certaine transparence et une absence de verrouillage propriétaire.

Continuer la lecture →

Fonctionnalités du noyau Linux (Episode 4) – Appels système

Nous avons vu dans l’épisode 1 l’architecture générale de l’environnement du noyau Linux et la manière dont il gère les processus. L’épisode 2 nous a permis d’entrer dans le détail de la gestion de la mémoire. Et l’épisode 3 nous a permis de creuser comment le noyau Linux gère les périphériques.

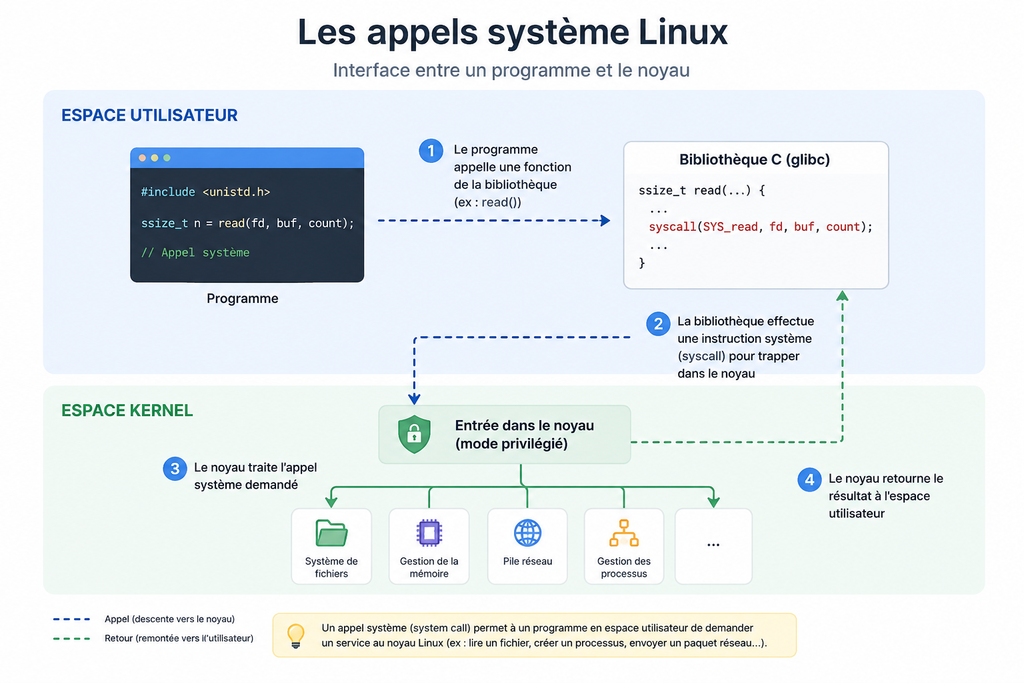
Dans cet épisode 4 nous allons voir comment le noyau Linux offre aux applications un service d’appels système.

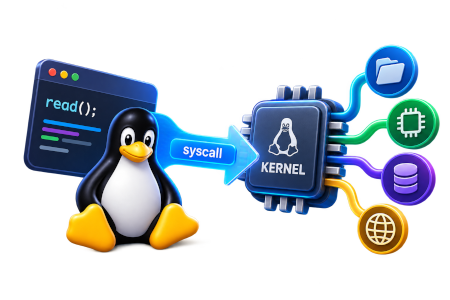
La notion même d’appels système est intimement liée au fait que le noyau est installé dans une zone mémoire à hauts privilèges (qu’on appelle par commodité l’espace noyau), alors que les applications tournent dans le reste de la mémoire, sans privilèges particuliers (qu’on appelle par commodité l’espace utilisateur). De facto, le noyau est le seul programme ayant accès au matériel.

Comme les applications ont besoin d’accéder au matériel (pour détecter un clic de souris sur un bouton par exemple, et déclencher le traitement associé), et que le noyau est le seul à avoir l’accès au matériel, de facto on n’y coupe pas : il faut impérativement que le noyau propose aux applications un service d’accès au matériel en passant par lui. Ce service ce sont les appels système.

Le noyau Linux propose un nombre variable d’appels système en fonction de l’architecture cible. Néanmoins, il y a en moyenne un peu plus de 300 appels système implémentés, couvrant tous les besoins possibles des applications : accéder aux fichiers, aux périphériques, aux couches réseaux, à la gestion des processus, etc.

Continuer la lecture →

Tutoriel Linux : installer Karakeep, le pocket auto-hébergé

Il y a quelques années le service Pocket rendait de grands services en permettant aux internautes d’y sauvegarder des articles d’Internet pour les lire plus tard.

Malheureusement ce service très utile a fermé ses portes définitivement en 2025.

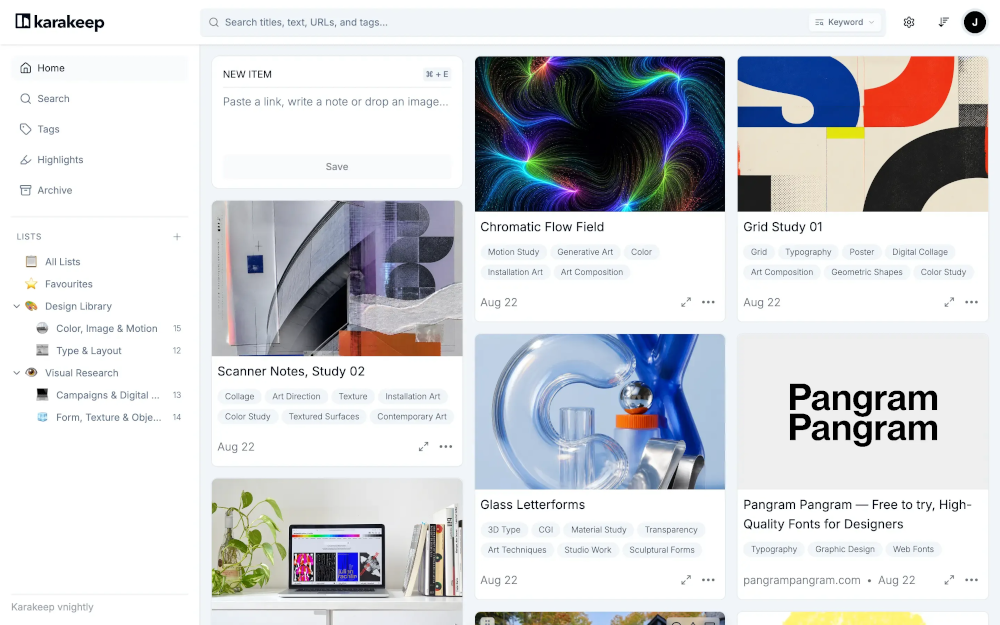
Fort heureusement, le monde de l’auto-hébergement (self hosting) propose maintenant pléthore de logiciels et services à installer soi-même sur son serveur ou sur son laptop, dont Karakeep, un logiciel web qui rend le même service que Pocket.

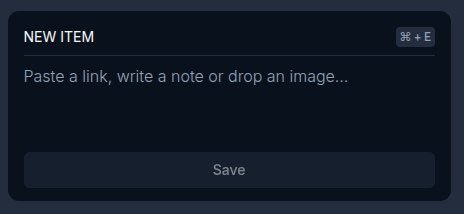
Le principe de fonctionnement est particulièrement simple : vous collez dans la zone « New item » l’URL de l’article qui vous intéresse, et votre article est stocké sous forme de tuile sur la page d’accueil.

Un simple clic sur la tuile ouvre l’article original dans une nouvelle fenêtre du navigateur.

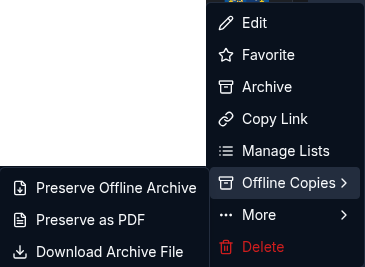
Pour éviter le cas où l’article original aurait disparu du web entre temps, Karakeep permet via un clic droit sur la tuile de télécharger sur le serveur une copie locale de l’article.

Le seul défaut qu’on peut trouver à Karakeep est que l’interface graphique est fournie uniquement en anglais, ce qui ne devrait plus être un problème pour quiconque en 2026.

Continuer la lecture →

Tutoriel Linux : auto-héberger IT-tools, une boîte de +80 outils IT indispensables

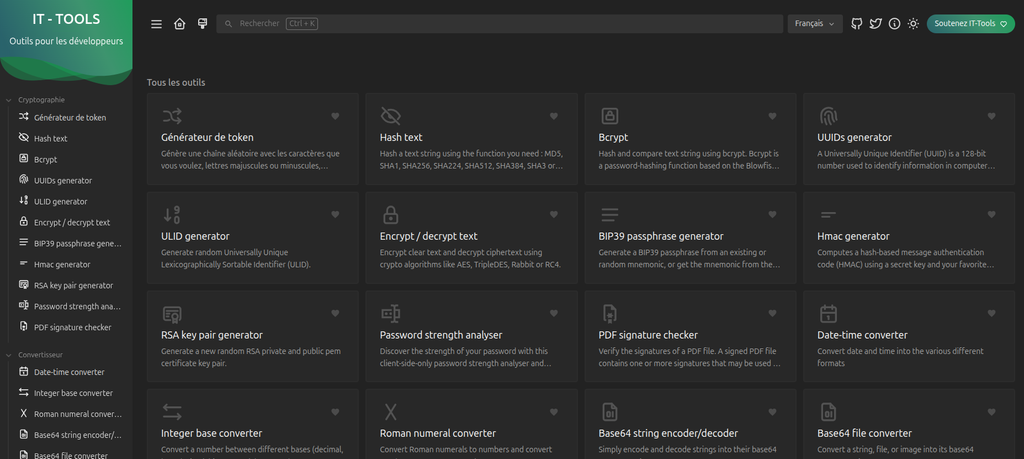
IT-tools est une boîte contenant plus de 80 outils IT indispensables aux personnes travaillant dans le domaine de l’IT. Il est auto-hébergeable sur un serveur en ligne via docker et programmé par le français Corentin Thomasset (ingénieur INSA Lyon).

Une instance en ligne est utilisable directement sur it-tools.tech pour ceux qui auraient la flemme de l’auto-héberger.

Indépendamment de disposer d’une interface web moderne ultra-léchée, la boîte à outil est incroyablement simple à auto-héberger sous docker.

Installation d’IT-tools avec docker compose

Créez un répertoire ittools-docker et mettez-y un fichier docker-compose.yml qui contient :

services:
    it-tools:
        image: ghcr.io/corentinth/it-tools:latest
        ports:
            - "8080:80"
        restart: unless-stopped
        container_name: it-tools

Lancez le service par :

docker compose up -d

Et voilà, c’est installé. Il n’y a plus qu’à se rendre sur http://serveur:8080 pour accéder à la boîte à outils.

Les outils mis à disposition

Le paramétrage de l’interface propose 8 langues, dont bien sûr le français.

Au niveau des outils mis à disposition, c’est le feu d’artifice.

Chaque rubrique propose au moins une dizaine d’outils utilisables d’un clic. Les rubriques couvrent la cryptographie, la conversion de formats, les outils web, la génération de qr codes, le développement, les réseaux, les maths, les mesures, les manipulations de textes, les données.

A chaque mise à jour de l’image docker, on bénéficie d’outils supplémentaires.

Bémol

Attention, la configuration du docker-compose.yml présentée ici aboutit non seulement à un outil en http et non en https, mais aussi un outil accessible à n’importe quel internaute qui connaîtrait l’URL du service.

La seule manière de rendre ce service privé serait de le cacher derrière un reverse proxy présentant à l’internaute une authentification basique.