Archives de catégorie : Tutoriel

Tutoriel Linux : sauvegarder son serveur avec rsyncy

Lorsqu’on dispose d’un serveur en ligne, il est indispensable d’en sauvegarder les répertoires contenant les données que l’on ne veut surtout pas perdre. Mais il est aussi très important de sauvegarder les données stockées en bases de données.

Sous Linux il existe pléthore de logiciels spécialisés pour réaliser cela, mais nous allons voir ici comment le faire avec rsyncy
Sauvegarder le contenu des bases de données MySQL

Allez sur votre serveur et dans un shell bash tapez (remplacez MonMotDePasse et mabase respectivement par le mot de passe et le nom de la base de données MySQL à sauvegarder :

mysqldump --user='root' --password='MonMotDePasse' mabase > mabase.sql

Cette commande produit un fichier mabase.sql qui est auto-porteur, c’est à dire que si un jour vous avez à restaurer la base de données, il suffira d’exécuter ce fichier sql par la commande ci-dessous, lancée depuis l’utilitaire mysql connecté à votre base de données vide (mysql -u utilisateur -p mabase) :

source ./mabase.sql;

Vous pouvez mettre autant de commandes mysqldump que vous le souhaitez dans un shell script bash, et ainsi créer autant de fichier .sql de sauvegarde que nécessaire, dans un répertoire que nous allons sauvegarder sur une machine distante grâce à rsyncy.

Rsyncy va vous permettre de respecter la règle de base pour les sauvegardes, à savoir : la règle du 3-2-1-1-0 :

  • 3 copies de sauvegarde
  • 2 supports différents
  • 1 sauvegarde hors site
  • 1 copie hors ligne
  • 0 erreur testée à la restauration
Rsync et rsyncy

Continuer la lecture

Tutoriel Linux : comment auto-héberger sa messagerie instantanée

Avec des messageries instantanées comme Whatsapp, Telegram ou Signal, il est si facile de communiquer avec ses amis, de s’échanger des photos, des documents, voire de s’appeler au téléphone ou en vidéo, le tout bien sûr chiffré de bout en bout.

Le problème sous-jacent est que, dans ces applications, vos données ne vous appartiennent pas. Elles sont stockées quelque part dans le cloud, chez Meta ou autre, vous ne les maîtrisez pas. Elles peuvent disparaître demain, les récupérer peut devenir payant ou impossible demain, vous subirez.

Si le produit ment et qu’il n’est pas chiffré de bout en bout, vos conversations sont lues par d’autres.

Il est pourtant très simple d’auto-héberger sa messagerie instantanée.

La question que vous vous posez peut-être est : « ok, si j’auto-héberge ma messagerie instantanée, est-ce-que je pourrai communiquer avec mes amis sur Whatsapp ou Telegram ? »

En fait nous allons utiliser le protocole Matrix, qui a été créé justement parce que ses créateurs se demandaient pourquoi un utilisateur d’une messagerie instantanée A (Whatsapp par exemple) ne pouvait pas converser avec les utilisateurs d’une messagerie B (Signal par exemple).

Ils se sont dit que, dans un monde idéal, il y aurait un seul langage universel pour toutes les messageries, tout le monde pouvant ainsi converser avec tout le monde, et chacun pouvant choisir son logiciel favori compatible de ce langage universel.

Du coup ils ont codé ce langage universel et appelé ce protocole Matrix.

L’état français a adopté ce protocole pour son application de messagerie instantanée ministérielle Tchap.

A l’exception de Tchap (qui est du Matrix mais sur un réseau privé dédié), toutes les instances Matrix sont en réseau.

Cela signifie que, si nous installons un serveur Matrix sur notre serveur Linux, non seulement nous pourrons converser à la sauce Whatsapp entre utilisateurs de cette messagerie, mais nous pourrons aussi converser avec les utilisateurs de toutes les autres instances Matrix existant sur Internet.

Dans ce réseau global Matrix, chaque utilisateur est identifié par une adresse du type @utilisateur:serveur

Si nous montons un serveur Matrix sur notre serveur dont le nom de domaine est votre_domaine.duckdns.org par exemple, alors l’utilisateur toto aura comme adresse Matrix @toto:votre_domaine.duckdns.org

Continuer la lecture

Tutoriel Linux : Installer Mullvad VPN sous Devuan

Dans un marché des VPN saturé de promesses parfois difficiles à vérifier, Mullvad VPN se distingue par une approche radicalement différente : placer la confidentialité au-dessus de tout, sans compromis. Basé à Göteborg, en Suède, et opérant sous la juridiction suédoise, ce service s’est forgé une réputation d’intégrité et de transparence inégalée . Son credo est simple : garantir un anonymat maximal à ses utilisateurs, quitte à concevoir un service qui ne pourrait même pas espionner ses propres clients si on le lui ordonnait.

Un processus d’inscription véritablement anonyme

L’engagement de Mullvad envers la confidentialité commence dès l’inscription. Fini les formulaires réclamant une adresse email, un nom ou un numéro de téléphone. Chez Mullvad, chaque nouvel utilisateur se voit attribuer un numéro de compte à 16 chiffres, qui lui sert à la fois d’identifiant et de mot de passe . Ce système garantit qu’aucune donnée personnelle n’est associée à votre activité en ligne. Pour pousser l’anonymat jusqu’au bout, Mullvad propose des options de paiement tout aussi discrètes : en plus des cartes de crédit et des cryptomonnaies classiques, il est possible de payer en liquide ou en chèque .

Une politique « No-Log » prouvée par les faits

La politique de non-conservation des logs de Mullvad est considérée comme l’une des plus robustes du secteur. Elle est si stricte que la société affirme qu’elle ne pourrait pas faire la différence entre un seul utilisateur possédant des centaines de comptes et des centaines d’utilisateurs distincts . Cette promesse a été mise à l’épreuve en avril 2023, lorsque la police suédoise a débarqué dans les locaux de Mullvad avec un mandat de perquisition pour récupérer des données sur ses utilisateurs. Le résultat est éloquent : la police est repartie les mains vides, Mullvad ayant été en mesure de démontrer que les données demandées n’existaient tout simplement pas . La société s’est même engagée à « fermer le service » s’il était un jour légalement contraint d’espionner ses utilisateurs .

Des audits de sécurité indépendants comme gage de confiance

Continuer la lecture

Tutoriel Linux : Ventoy la clé USB universelle pour installer des systèmes d’exploitation

Créer une clé USB bootable pour installer un système d’exploitation a longtemps été une opération répétitive. Il fallait utiliser une clé USB pour chaque OS, puis y graver l’image ISO du système. Les clés USB s’accumulaient dans la boîte à outils.

Ventoy, apparu en avril 2020, propose une approche différente qui a fait sa popularité. Développé par Hailong Sun, cet utilitaire open source transforme une clé USB en un dispositif bootbale capable de démarrer directement sur des fichiers image, sans extraction ni décompression préalable. On boote sur la clé USB, on tombe sur un menu qui nous propose de choisir entre les différentes images ISO présentes sur la clé, on en choisit un, et l’installation de l’OS choisi démarre.

Pour ajouter un OS ou en enlever un, il suffit de mettre ou pas son image ISO sur la clé.

Principe de fonctionnement

Le mécanisme est simple : une fois installé, Ventoy crée deux partitions sur la clé USB cible. Une partition principale, généralement formatée en exFAT ou NTFS, où l’on copie simplement les fichiers image. Et une partition EFI qui contient le chargeur d’amorçage .

L’outil prend en charge une large gamme de formats : ISO, WIM, IMG, VHD(x) et EFI . Sa compatibilité couvre aussi bien les anciens BIOS que les firmwares UEFI récents, et il fonctionne sur les architectures x86, IA32, ARM64 et MIPS64EL . Les systèmes d’exploitation pris en charge sont nombreux : distributions Linux, versions récentes de Windows, FreeBSD, ChromeOS, VMware ESXi, etc. .

Continuer la lecture

Tutoriel Linux : Installation et configuration de docker

Rappelons d’abord ce que sont les machines virtuelles, VM en anglais (Virtual Machines) :

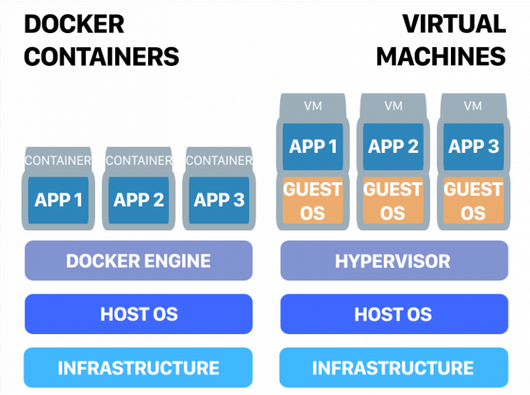
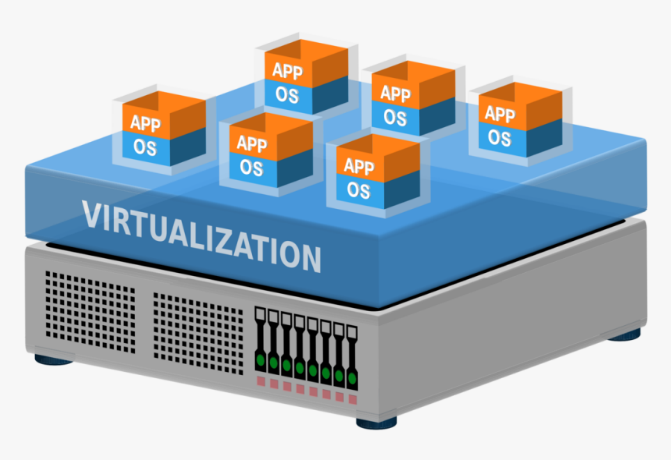
Les VM sont des PC virtuels qui tournent sur une machine réelle, sur laquelle est installée une couche de virtualisation. Chaque PC virtuel dispose de son système d’exploitation (Windows, Linux, …) sur lequel tournent des applications.

C’est une mécanique très puissante et très utilisée dans l’informatique professionnelle mais aussi très gourmande en ressources. C’est pourquoi est apparue la technologie docker, qui n’est pas de la virtualisation mais de la conteneurisation.

Contrairement aux VM, les conteneurs docker n’embarquent pas de système d’exploitation, ils utilisent le système d’exploitation de la machine physique (Linux). Les deux conséquences majeures sont que les ressources nécessaires pour faire tourner des conteneurs sont bien plus faibles que celles nécessaires pour faire tourner des VM, et donc les conteneurs sont bien plus rapides à se lancer que les VM et surtout on peut en mettre beaucoup plus sur une machine donnée. La deuxième conséquence majeure est que seules les applications Linux peuvent tourner dans un conteneur.

L’utilisation des conteneurs docker a beaucoup d’avantages :

Continuer la lecture

Tutoriel Linux : auto-héberger ses BD en ligne sur son VPS avec Kavita (sous docker)

Les passionnés de bandes dessinées n’aiment rien tant que les vraies BD papier, c’est un fait, mais cette approche atteint vite ses limites tant les collections de BD prennent de la place dans la maison.

Avec l’essor des technologies modernes à écrans (PC, smartphones, tablettes), est apparue une offre numérique pour les BD qui n’a rien à envier à l’offre papier physique. Avec un avantage non négligeable : la place.

Un simple disque dur permet de stocker de milliers de BD et tient dans la poche. A ce propos, je me permets de conseiller ce modèle, qui est celui que j’achète systématiquement et qui est à la fois performant, fiable et increvable.

Une collection de BD est à l’abri d’un sinistre (incendie, dégât des eaux), ne jaunit pas avec le temps, ne salit pas, ne vieillit pas. Le seul risque qui guette la collection numérique finalement, c’est le crash du disque dur : ce risque se gère d’une part en misant sur un modèle increvable (comme celui ci-dessus) et surtout en stockant sa collection sur DEUX disques durs.

Continuer la lecture

Installation et configuration du VPN Wireguard

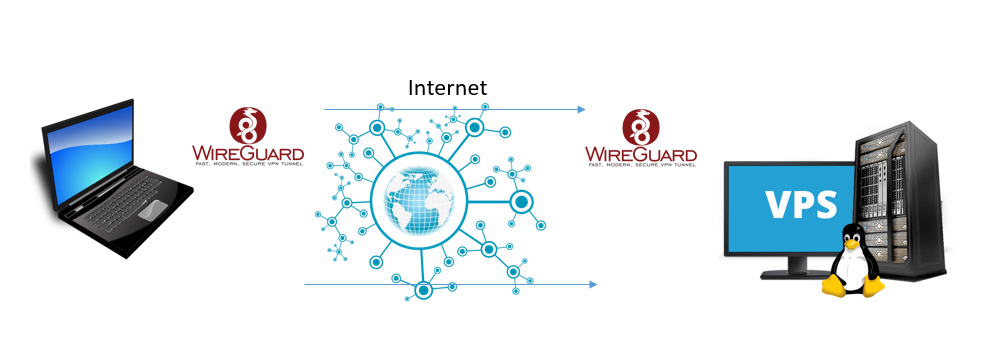
Le schéma ci-dessus montre ce que nous allons réaliser dans ce tutoriel : nous allons installer un serveur VPN wireguard sur un VPS (machine Linux sur Internet), et un client wireguard sur un laptop Linux. Un tel tunnel chiffré permet des connexions distantes en SSH qui empruntent le tunnel. Il est tout à fait possible (nous le verrons dans un article ultérieur) de n’autoriser la connexion SSH que via ce tunnel Wireguard, ce qui protégera le serveur des attaques par force brute sur SSH.

Qu’est ce que wireguard ?

Il s’agit d’un protocole qui permet de créer un tunnel VPN chiffré entre deux machines, ou entre plusieurs clients et un serveur.

Wireguard n’est pas le seul tunnel VPN que l’on pourrait installer. Il y en a d’autres : OpenVPN, IPSec, etc.

Nous allons utiliser wireguard parce qu’il est très facile à installer, léger, performant et moderne.

Continuer la lecture

Créer et gérer son miroir local des dépôts officiels Ubuntu

La mise en place d’un dépôt personnel, ou miroir local, des dépôts officiels Ubuntu est une pratique d’administration système qui consiste à cloner tout ou partie des dépôts de paquets sur un serveur situé sur le réseau local. L’objectif est de centraliser les sources de mise à jour et d’installation pour l’ensemble des machines d’un parc informatique.

L’un des intérêts majeurs d’un miroir local est l’optimisation de l’utilisation de la bande passante et le gain de temps. Dans un environnement où plusieurs machines doivent être mises à jour, chaque serveur ou poste de travail télécharge individuellement les mêmes paquets depuis les serveurs publics d’Ubuntu, ce qui entraîne une duplication massive des données .

En installant un miroir local, les téléchargements depuis l’extérieur ne sont effectués qu’une seule fois, lors de la synchronisation du miroir avec les dépôts officiels. Toutes les autres machines du réseau se servent ensuite de ce miroir, via le réseau local, pour obtenir leurs paquets . La vitesse de transfert sur un réseau local (par exemple, via Ethernet ou Wi-Fi) est en effet bien supérieure aux débits offerts par une connexion internet, ce qui rend les installations et les mises à jour quasi instantanées .

La mise en place d’un miroir local offre une indépendance vis-à-vis de la connexion internet. Dans des environnements où l’accès à internet est limité, instable ou inexistant, comme les laboratoires, les salles de classe ou les réseaux industriels, le miroir devient une ressource essentielle . Les machines peuvent continuer à s’installer, se mettre à jour et fonctionner normalement même en cas de panne de la connexion internet ou d’indisponibilité des serveurs officiels . Cette autonomie garantit la continuité des opérations dans des environnements critiques .

Pour les administrateurs système, un miroir local est un outil de contrôle puissant. En ne synchronisant que les dépôts et les composants sélectionnés, l’administrateur garde la main sur les versions des paquets disponibles pour ses utilisateurs . Il est ainsi possible de geler un environnement à un instant T, de tester les mises à jour de sécurité sur un petit nombre de machines avant un déploiement plus large, ou de garantir que toutes les machines d’un parc utilisent une version identique d’un paquet donné . En pratique, l’administrateur modifie le fichier /etc/apt/mirror.list pour ne retenir que les dépôts pertinents (par exemple, en ne conservant que la branche security pour les mises à jour de sécurité) .

Voici un tutoriel détaillé expliquant comment créer, utiliser et entretenir un miroir de dépôt Ubuntu.

Continuer la lecture

Assistant IA local avec OpenCode et Ollama

Utiliser Claude comme assistant pour nous assister c’est très bien mais cela a tout de même un coût non négligeable. Parmi les alternatives existantes, l’auto-hébergement est une voie intéressante. Il faut cependant être tout de même conscient des limites.

En effet, avec des modèles d’IA auto-hébergés on ne bénéficie pas de la puissance de calcul des data centers des prestataires privés, ni des modèles aux performances les plus avancées. Par contre, c’est complètement gratuit et, pour peu qu’on installe des modèles d’IA adaptés aux performances de sa machine, on peut espérer mettre en place des outils qui répondent à 2 ou 3 tokens par seconde, ce qui est peu par rapport aux modèles payants, mais déjà pas si mal.

Pour mettre en place un tel outil, il est nécessaire de bien définir la machine visée, car le choix de modèles adaptés en découle.

Pour ce tutoriel nous allons viser une machine de type Asus Zenbook 13″ OLED (Intel Core i5, 16 Go RAM, sous Ubuntu 26.04)

Ce tutoriel vous permet d’installer un assistant IA local totalement gratuit, équivalent à Claude (pour les questions/réponses) et Claude Code (pour l’aide au codage en ligne de commande). Aucun abonnement ni connexion internet obligatoire (hors téléchargements initiaux).

Continuer la lecture